Cette cartographie structurée recense les cas d’usage documentés de l’intelligence artificielle appliquée au codage médico-administratif et au revenue cycle management (RCM), issus de la revue de littérature internationale et des retours d’expérience identifiés depuis 2023. Cette analyse a été complétée et revue par deux médecins DIM français de CH, utilisateur et non utilisateur de solutions d’IA dédiée.
Le périmètre couvre la France, l’Europe (pays nordiques, Grèce), l’Amérique du Nord (États-Unis) et l’Asie (Taïwan), avec un focus sur les systèmes DRG-like : PMSI/CIM-10 FR, NordDRG, MS-DRG, Tw-DRG et G-DRG.
Analyse par famille de cas d’usage
Codage automatique / assisté ICD-10
Ce segment concentre la majorité des publications académiques et industrielles. Les approches vont du deep learning multi-label (CUS-FR-001) aux LLM fine-tunés comme DRG-LLaMA (CUS-ROW-002) ou GPT-2 appliqué au Tw-DRG (CUS-ROW-001). Les performances mesurées convergent vers un constat : les modèles atteignent des F1 élevés sur les codes fréquents (>0,85 sur le top 50), mais restent perfectibles sur les codes rares et les cas complexes (F1 global autour de 0,67). Aucun de ces cas n’a encore basculé vers un autocodage complet sans supervision humaine.
Contrôle qualité et détection d’anomalies
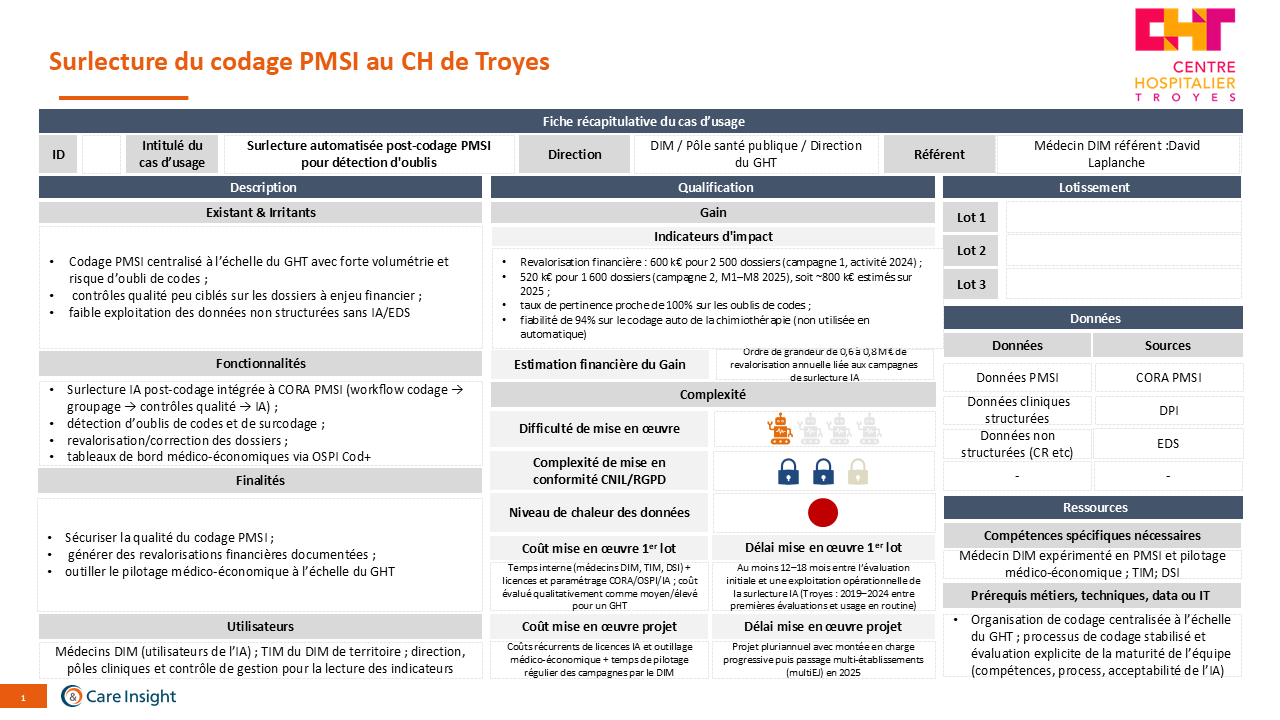
En France, les cas CUS-FR-002 (Cod+) et CUS-FR-003 (CHU Grenoble) illustrent un positionnement centré sur la détection des oublis de codes, des CMA manquantes et de la sous-valorisation. Ce segment présente le meilleur ratio risque/valeur : le ROI est rapide, le risque clinique est limité et le pilotage par KPI est immédiat. Le RETEX du CH de Troyes confirme ce constat terrain : l’IA en surlecture post-codage atteint un taux de pertinence « de quasiment 100% » sur les oublis de codes.
Groupage DRG et raisonnement tarifaire
Le benchmark NordDRG AI (CUS-EU-001) propose une approche originale : encapsuler les tables de définition DRG et les workflows de mise à jour dans un cadre d’évaluation standardisé pour tester les LLM. Les résultats sont encore insuffisants pour une automatisation, mais l’outil est utile pour comparer des copilotes IA avant déploiement en production. En Grèce (CUS-EU-002), une plateforme numérique d’audit a permis un reclassement significatif de DRG vers des groupes plus rémunérateurs.
Revenue Cycle Management (RCM)
Le cas le plus mature est celui d’Auburn Community Hospital (CUS-ROW-003), où l’intégration de l’IA et du RPA au cycle de facturation a produit des résultats mesurables : –50% de dossiers DNFB (discharged-not-final-billed), +40% de productivité des codeurs et +4,6% de CMI. Ce type de déploiement reste spécifique au contexte américain multi-payeurs, mais les KPI sont transposables à la logique PMSI française.
Matrice de positionnement : maturité × valeur × risque
Le croisement des cas d’usage par niveau de maturité et profil de risque/valeur permet d’identifier les segments les plus actionnables pour un établissement français.
| Segment |
Cas d’usage illustratifs |
Maturité |
Valeur potentielle |
Risque |
| Low-risk / High-value |
Surlecture post-codage, détection d’oublis (CUS-FR-002, CH Troyes) |
Élevée – routine |
Élevée – sécurisation + revalorisation |
Faible |
| High-risk / High-value |
Optimisation DRG/RCM à fort enjeu financier (CUS-ROW-003) |
Élevée – opérationnel (USA) |
Très élevée – productivité + CMI |
Moyen (contexte réglementaire) |
| Medium-risk / High-value |
Autocodage séjours simples (CUS-FR-002 mode auto) |
Moyenne – supervisé |
Élevée – gain productivité majeur |
Moyen (6% erreur = trop élevé en routine) |
| High-risk / Low-value |
Autocodage complet sans supervision, cas complexes |
Faible – non utilisé |
Incertaine |
Élevé (codes rares, explicabilité) |
| Low-risk / Low-value |
Chatbot codage ponctuel, usage LLM généraliste |
Faible |
Faible |
Faible |
Le tableau ci-dessous synthétise les principaux KPI rapportés par zone, permettant une lecture comparative rapide.
| KPI |
France (PMSI) |
Europe (NordDRG/G-DRG) |
USA (MS-DRG/RCM) |
Taïwan (Tw-DRG) |
| Gain de temps codage |
≈ 46%/dossier (Cod+) |
Non quantifié publiquement |
–30% charge manuelle |
Non quantifié |
| Automatisation séjours simples |
≈ 50% (Cod+) |
N/A |
N/A |
60–75% principal correct |
| Revalorisation financière |
+1 500 €/séjour ciblé ; 600 k€/campagne (CH Troyes) |
Reclassement DRG significatif (Grèce) |
+4,6% CMI ; millions $/an |
N/A |
| Réduction rejets / DNFB |
Non mesuré (FR) |
N/A |
–50% DNFB ; –30–50% rejets ICD-10 |
N/A |
| Performance IA (F1) |
Amélioré vs baselines (pas de chiffre standardisé) |
Insuffisant pour auto (NordDRG AI) |
Top-1 ≈ 67% (DRG-LLaMA) |
F1 global ≈ 0,67 ; F1 top 50 >0,85 |
| Productivité codeurs |
Non standardisé |
Non quantifié |
+40% (Auburn) |
Réduction charge attestée |
Convergences internationales
Trois constats se dégagent de l’ensemble des cas d’usage, toutes zones confondues :
- L’IA performante en codage repose systématiquement sur une hybridation règles + modèles : aucun déploiement opérationnel ne fonctionne sans moteur de règles encadrant les prédictions des modèles IA.
- Le positionnement en assistance plutôt qu’en remplacement est le dénominateur commun de tous les projets ayant franchi le stade du pilote : l’IA propose, l’humain valide.
- Les KPI de productivité et de qualité (temps de codage, taux d’erreurs, DNFB) sont plus robustes et plus comparables entre pays que les KPI financiers, qui dépendent fortement du contexte tarifaire local.
Spécificités françaises
Le contexte PMSI impose des contraintes qui expliquent un retard apparent de maturité par rapport aux États-Unis :
- L’évolution annuelle des règles PMSI (codes, groupage, PLFSS/ONDAM) exige des solutions capables de ré-entraînement régulier, ce qui alourdit le coût total de possession.
- Les contrôles externes (CAC, Assurance maladie) imposent une traçabilité documentée de chaque décision de codage, rendant l’autocodage pur plus risqué en France qu’aux États-Unis.
- L’absence d’intégration des solutions tierces dans le DPI reste un frein opérationnel majeur, confirmé par les retours DIM.
Zones blanches de la littérature
Plusieurs lacunes sont identifiées dans le paysage actuel des cas d’usage :
- Allemagne (G-DRG) : des initiatives émergent autour du codage assisté ICD-10/OPS, mais la littérature publique détaillée reste pauvre.
- Canada : cité dans le périmètre de l’étude mais aucun cas d’usage formalisé n’a été identifié à ce stade.
- KPI de ROI dynamique : aucun cas d’usage ne présente un suivi longitudinal du ROI intégrant l’érosion potentielle des gains dans un système à enveloppe contrainte.
Nota méthodologique
Les cas d’usage identifiés proviennent de la revue de littérature internationale structurée par Health&Tech Intelligence, couvrant articles scientifiques, études de cas hospitalières, livres blancs d’éditeurs et documents institutionnels depuis 2023. Les chiffres d’impact provenant de communications d’éditeurs sont signalés comme tels et doivent être interprétés avec prudence. Des outils d’IA ont été mobilisés pour la recherche documentaire et la structuration des informations ; l’analyse et les conclusions restent du ressort des équipes HTI et des relecteurs DIM.
| ID |
Pays / zone |
Système de paiement |
Type de cas d’usage IA |
Impact / métriques saillants |
| CUS-FR-001 |
France |
PMSI (CIM‑10 FR) |
Codage automatique/assisté ICD‑10 à partir des textes médicaux français (modèles de deep learning multi‑label). arxiv |
F1 multi‑label significativement amélioré vs baselines, surtout pour les codes fréquents ; étude encore algorithmique, sans KPI de temps ni revenus. arxiv |
| CUS-FR-002 |
France |
PMSI MCO |
Suite Cod+ (Ospi) – primo‑codage IA, contrôle qualité, optimisation valorisation PMSI. ospi |
Gains annoncés : ≈ 46% de temps gagné par dossier, ≈ 50% d’automatisation sur séjours simples, +1500 € de gain par séjour ciblé, >800 règles diagnostics sévérité 1‑3. ospi |
| CUS-FR-003 |
France |
PMSI |
Outil CHU Grenoble (Easily + recherche textuelle/IA) pour optimisation PMSI (détection CMA, sous‑valorisation). craim |
KPI internes : orientation plus ciblée des contrôles qualité, amélioration de l’identification des CMA ; pas (encore) de chiffres standardisés de temps ou de revenu dans la présentation. craim |
| CUS-FR-004 |
France |
PMSI |
Projets ATIH d’IA pour codage automatisé de certaines informations PMSI + enquête flash 2024 sur outils IA de codage diagnostics. atih.sante+3 |
ATIH signale des travaux en cours sur l’IA pour codage automatisé et lance une enquête flash pour mesurer performances des outils IA sur le marché ; pas d’impacts chiffrés publiés à ce stade. atih.sante+1 |
| CUS-EU-001 |
Nordiques (multi‑pays) |
NordDRG |
Benchmark NordDRG AI pour LLM : capacités de raisonnement DRG à partir de cas tests, règles et catalogues ICD‑10/NCSP. arxiv |
Mesure de la précision d’assignation DRG ; résultats encore insuffisants pour une automatisation, mais utiles pour comparer des copilotes IA avant déploiement. arxiv |
| CUS-EU-002 |
Grèce |
DRG grec (G‑DRG‑like) |
Plateforme numérique spécialisée pour fiabiliser le codage DRG dans le déploiement national (audit et correction de codage). pmc.ncbi.nlm.nih |
Reclassement significatif d’un nombre de DRG vers des groupes plus rémunérateurs après audit ; augmentation potentielle substantielle du revenu hospitalier (montant exact dépend des hôpitaux). pmc.ncbi.nlm.nih |
| CUS-ROW-001 |
Taïwan |
Tw‑DRG |
Autocodage et assistant DIM (GPT‑2, HAN) pour ICD‑10‑CM et Tw‑DRG : suggestion de codes, principal, MDC, intégration workflow. jmir |
F1 global ≈ 0,67, F1 main code ≈ 0,58–0,62, ≈ 60–75% de séjours avec principal correct, κ MDC jusqu’à >0,81 pour certaines MDC ; déploiement local intégré au flux DIM. jmir |
| CUS-ROW-002 |
États‑Unis |
MS‑DRG |
DRG‑LLaMA : prédiction automatisée MS‑DRG à partir des notes (MIMIC‑IV). pmc.ncbi.nlm.nih |
Amélioration relative ≈ +35–40% macro‑F1 vs modèles antérieurs ; top‑1 accuracy ≈ 67% pour DRG base et CC/MCC ; preuve de concept, pas de KPI de productivité. pmc.ncbi.nlm.nih |
| CUS-ROW-003 |
États‑Unis |
MS‑DRG, RCM |
Plateformes RCM avec IA (Auburn Community Hospital) : codage, DNFB, CMI. aha |
–50% dossiers DNFB, +40% productivité des codeurs, +4,6% de CMI après intégration IA/RPA pour codage et cycle de facturation. aha |
En Europe, les systèmes DRGlike sont largement répandus, mais avec des déclinaisons nationales (NordDRG, GDRG en Allemagne, groupes DRG nationaux en Grèce, pays d’Europe centrale, etc.), chacune avec ses règles et sa gouvernance. Le benchmark NordDRG AI illustre une approche structurée : il expose les tables de définition DRG et les workflows de mise à jour, et propose une suite de tests pour évaluer la capacité des LLM à suivre ces règles, avec une forte insistance sur la transparence et la reproductibilité.
Dans les pays nordiques, la combinaison d’un casemix partagé (NordDRG), de données hospitalières très structurées et d’une culture de benchmarking facilite les expérimentations IA sur le groupage, le contrôle qualité et l’analyse de coûts. L’IA est utilisée pour tester la robustesse du groupage, identifier des cas limites, et simuler l’impact de modifications tarifaires. Dans d’autres pays (Allemagne, Grèce, etc.), des initiatives émergent autour du codage assisté ICD10/OPS et de la détection d’anomalies de facturation, mais la littérature publique détaillée reste moins riche que pour les ÉtatsUnis ou les pays nordiques.
Comparée à la France, l’Europe “hors France” semble davantage centrée sur le DRG et la logique casemix comme objet principal de l’IA, là où la France reste concentrée sur la chaîne PMSI interne et les besoins spécifiques des DIM. Les différences de gouvernance (centralisée vs plus décentralisée) et de modèles de financement expliquent une partie de ces écarts.
ÉtatsUnis, Taïwan et autres pays : impacts financiers et opérationnels
ÉtatsUnis : RCM comme terrain d’élection
Aux ÉtatsUnis, le couple MSDRG / ICD10CM et un environnement de payeurs multiples font du RCM un terrain privilégié pour l’IA. Des solutions d’IA en codage et RCM rapportent :
- Réductions de 30–50% des rejets de codage ICD10 et des gains de 35% sur le taux de “firstpass yield”.
- Accélération de 25% des cycles de remboursement et baisse de 30% de la charge de travail manuelle des codeurs.
- Gains de revenu additionnel pouvant représenter 0,3–0,5 points de marge sur le chiffre d’affaires hospitalier, et plusieurs millions de dollars par an pour des systèmes multiétablissements.
Ces chiffres proviennent majoritairement de communications d’éditeurs et nécessitent prudence, mais ils indiquent un ordre de grandeur de l’impact potentiel lorsque l’IA est intimement intégrée au RCM (détection des risques de rejet, préscrubbing des demandes, recodage proactif).
Taïwan et TwDRG : étude structurée d’un système NLPdriven
L’étude de 2024 sur un système NLPdriven d’assistance au codage ICD10CM dans le contexte TwDRG fournit une évaluation rigoureuse :
- Les modèles HAN et GPT2 sont comparés à des modèles de référence et au codage humain, avec GPT2 atteignant un F1 global autour de 0,67 et des F1 supérieurs à 0,85 sur les 50 codes les plus fréquents.
- L’outil permet de réduire la charge de travail des codeurs et d’accélérer l’assignation TwDRG, tout en restant loin d’un remplacement complet de l’humain, notamment sur les codes rares et les cas complexes.
Cette étude met en lumière l’importance d’évaluer à la fois la performance globale et la performance par catégorie de codes, et d’intégrer l’IA comme support plutôt que substitut complet.
Autres contextes
Dans d’autres pays, l’IA en codage apparaît souvent couplée à des initiatives plus larges de digitalisation hospitalière :
- Utilisation de l’IA pour améliorer la qualité du codage en vue de comparaisons internationales et d’études d’efficience, dans des systèmes DRG déjà matures.
- Intérêt croissant des régulateurs pour des outils permettant d’auditer les performances des LLM et de vérifier la conformité aux règles de groupage et de tarification.
Ces expériences peuvent servir de référence haute pour l’Europe et la France, sous réserve d’adapter les cas d’usage aux contraintes locales (règles de financement, gouvernance des données, acceptabilité des parties prenantes).
Typologie des solutions observées
On peut distinguer plusieurs familles de solutions sur la période récente :
- Autocodage et codage assisté ICD10 / ICD10CM / CIM10 à partir des comptes rendus et données cliniques, utilisant des architectures deep learning (CNN, RNN, Transformers) et désormais des LLM généralistes ou spécialisés.
- Outils d’aide au codage pour les équipes DIM : suggestions de codes, listes de travail priorisées, contrôle qualité (détection d’atypies, codes incohérents, manques), souvent intégrés dans les plateformes PMSI ou les applications de codage.
- IA pour le groupage DRGlike : assistance au choix ou à la vérification du DRG, simulations d’impact de recodage, et plus récemment benchmarks type NordDRG AI pour tester la capacité des LLM à suivre la logique de groupers complets.
- Solutions RCM intégrées : moteurs d’IA appliqués au cycle de facturation, avec extraction sémantique des diagnostics/actes, détection de risques de rejet, prédiction des denials et workflows de correction avant émission de la facture.
Les cas d’usage couvrent ainsi la chaîne complète : de la production primaire du codage jusqu’à la valorisation financière et à la réduction des pertes de revenu.
Niveaux de maturité
Les niveaux de maturité varient :
- Preuves de concept académiques : essais d’autocodage sur bases anonymisées, souvent monocentriques, évaluant des modèles de deep learning ou de LLM sur des tâches ICD10/ICD10CM, avec des F1 globaux encore limités sur l’ensemble des codes, mais très honorables sur les codes fréquents.
- Pilotes intégrés dans 1–2 hôpitaux : par exemple, des systèmes NLPdriven d’assistance ICD10CM et TwDRG déployés dans des hôpitaux taïwanais, avec mesure de la charge de travail des codeurs, de la cohérence avec le codage humain et de la rapidité de traitement.
- Déploiements multisites et offres industrielles : solutions nordaméricaines et européennes intégrant IA de codage et RCM, avec claims de gains quantifiés sur les rejets, la productivité et le revenu net, parfois sur des réseaux hospitaliers complets.
La tendance majeure est le passage d’outils de codage “isolés” à des plateformes intégrées de revenue cycle, où l’IA est une couche transverse de détection, de recommandation et de contrôle.
Tendances technologiques
Trois évolutions technologiques se détachent :
- Montée en puissance des LLM spécialisés santé, capables de raisonner sur des combinaisons complexes de diagnostics et procédures et de générer des rationales de codage exploités pour la vérification et l’explicabilité.
- Intégration de l’IA dans les pipelines DRG : benchmarks comme NordDRG AI qui encapsulent les tables de définition DRG dans des cadres d’évaluation pour tester la capacité des modèles à reproduire une logique de groupage conforme aux règles nationales.
- Hybridation règles + IA : utilisation de moteurs de règles (editeurs/groupers) pour encadrer l’espace des codes possibles, l’IA venant proposer, prioriser et vérifier, plutôt que décider seule, ce qui est clé pour la conformité et l’audit.
Les différences de nomenclature/systèmes DRG par pays
Diversité des PMSI et nomenclatures : une même logique, des architectures radicalement différentes
Si tous les pays industrialisés partagent la même ambition fondatrice — mesurer l’activité médicale pour financer les établissements de santé et piloter les politiques de santé —, les systèmes mis en place divergent profondément dans leur architecture, leur granularité et leur histoire. La France constitue un cas particulier avec son PMSI, dispositif intégré et centralisé articulé autour de la CIM-10-FR (version enrichie d’extensions nationales par l’ATIH chaque année) pour les diagnostics et de la CCAM pour les actes (8 000+ codes, propre à la France, sans équivalent direct à l’étranger) : cette double nomenclature alimente la classification en GHM, réalisée par le logiciel de groupage de l’ATIH, aboutissant à un GHS tarifé — une cha ine entière qui n’existe sous cette forme dans aucun autre pays. L’Allemagne s’appuie sur un binôme comparable (ICD-10-GM + OPS), mais avec une logique différente : l’OPS est structuré en 6 chapitres et ~18 700 classes à six chiffres, là où la CCAM française est organisée par topographie anatomique et acte technique ; le groupage G-DRG est calculé annuellement par l’InEK à partir de données réelles de coûts hospitaliers, alors que les tarifs GHM français sont fixés administrativement par le ministère. Le Royaume-Uni se distingue par l’emploi de trois couches distinctes : SNOMED CT comme terminologie de saisie au point de soin (350 000+ concepts), ICD-10 pour le codage rétrospectif post-sortie, et OPCS-4 pour les procédures — un triptyque sans équivalent ailleurs, où la traduction SNOMED CT → ICD-10/OPCS-4 constitue elle-même un métier et une source d’erreurs. Les États-Unis poussent la complexité à son paroxysme : ICD-10-CM pour les diagnostics, ICD-10-PCS (77 000+ codes à 7 caractères) pour les procédures hospitalières, CPT (10 000+ codes) pour les actes ambulatoires, et HCPCS pour les fournitures, soit jusqu’à quatre nomenclatures superposées selon le contexte de soin — un éclatement qui s’explique par la fragmentation du système assurantiel (Medicare, Medicaid, assureurs privés) et le fait que le CPT est une propriété privée de l’AMA, générant des droits de licence. Le Canada, via le CIHI, a développé l’ICD-10-CA (version enrichie de l’ICD-10 au-delà du 4ᵉ caractère, couvrant aussi les risques occupationnels et environnementaux) couplée à la CCI, classification à 10 caractères alphanumériques conçue pour être neutre vis-à-vis du lieu et du type de prestataire — une approche délibérément pan-canadienne pour réconcilier 13 systèmes de santé provinciaux. Enfin, Taïwan présente le modèle le plus unifié : ayant migré vers l’ICD-10-CM PCS en 2016 (le même système qu’aux États-Unis), il bénéficie d’un payeur unique (NHIA) qui impose des règles de codage homogènes à l’ensemble des 18 000 établissements contractés, permettant un téléchargement quotidien automatisé des données et des coûts administratifs inférieurs à 1%. Au fond, cette diversité reflète moins des choix techniques qu’des histoires institutionnelles : là où la France a construit un système étatique centralisé avec une nomenclature d’actes souveraine (la CCAM), les États-Unis ont laissé le marché produire une pluralité de nomenclatures concurrentes ; là où l’Allemagne a délégué le calcul des tarifs à un organe paritaire (InEK), le Royaume-Uni a choisi de séparer la terminologie clinique du codage administratif. La transition vers l’ICD-11, premier vrai standard mondial commun, représente donc bien plus qu’une mise à jour technique : elle est un défi de convergence institutionnelle sans précédent