Des solutions d’IA déjà intégrées aux cabinets médicaux
Les médecins libéraux, qu’ils soient généralistes ou spécialistes, disposent aujourd’hui d’un large éventail d’outils basés sur l’intelligence artificielle. Ces solutions s’articulent principalement autour de l’aide au diagnostic, de l’analyse d’imagerie médicale, de l’automatisation des tâches administratives et de la personnalisation du suivi patient. Des logiciels exploitant le traitement automatique du langage naturel permettent d’analyser les comptes rendus médicaux, tandis que des plateformes de machine learning identifient des pathologies à partir d’examens d’imagerie ou de bilans biologiques. Parallèlement, les chatbots médicaux et les outils de triage automatisé facilitent l’orientation des patients vers les soins appropriés. La télémédecine, quant à elle, s’appuie de plus en plus sur des algorithmes prédictifs pour améliorer la pertinence des consultations à distance et éviter des consultations inutiles.
Opportunités et défis : vers une médecine plus préventive et efficace
L’intégration de l’IA ouvre de nouvelles perspectives en matière de prévention, de qualité des soins et d’efficacité opérationnelle. Les algorithmes d’analyse prédictive permettent d’identifier les patients à risque avant l’apparition des symptômes, favorisant une approche proactive de la santé publique. En matière d’excellence opérationnelle, l’automatisation de tâches administratives (prise de rendez-vous, gestion de dossiers médicaux, facturation) réduit la charge de travail des praticiens, leur permettant de se concentrer sur le soin. De plus, l’IA contribue à limiter les erreurs médicales en renforçant la précision diagnostique et en alertant sur d’éventuelles interactions médicamenteuses ou anomalies cliniques. Toutefois, son adoption doit s’accompagner d’une réflexion approfondie sur l’accompagnement des patients, la responsabilité médicale en cas d’erreur algorithmique et la préservation du lien humain entre médecin et patient, fondement essentiel de la pratique médicale libérale.
Données sur les professions de santé libérales en France
Selon les données de l’Assurance Maladie, les professionnels de santé libéraux représentent plus d’un tiers de l’ensemble des professionnels de santé inscrits à leur ordre respectif. Cette proportion varie selon les professions : moins d’un cinquième pour les infirmiers, mais plus de 90 % pour les masseurs-kinésithérapeutes et les pédicures-podologues. Les lieux d’exercice sont multiples : cabinet médical, maison de santé pluriprofessionnelle (MSP), clinique, etc. Les médecins libéraux se répartissent en plusieurs catégories : généralistes, médecins à exercice particulier (MEP) et autres spécialistes. Les chirurgiens-dentistes, sages-femmes et auxiliaires médicaux (infirmiers, masseurs-kinésithérapeutes, pédicures-podologues, orthophonistes, orthoptistes) constituent les autres principales catégories de professionnels de santé libéraux.
L’intégration de l’IA dans la pratique des professionnels de santé libéraux doit donc tenir compte de cette diversité, en adaptant les solutions technologiques aux spécificités de chaque profession et mode d’exercice.
Health&Tech Intelligence vous propose un tour d’horizon du sujet : état des lieux des usages de l’IA en médecine libérale, analyse des solutions disponibles et de leur intégration dans la pratique quotidienne, enjeux éthiques et réglementaires, ainsi que les perspectives d’évolution dans un contexte de crise de la médecine de ville. Ce dossier est composé des éléments suivants :
De l’automatisation des comptes rendus à la gestion des plannings, l’IA transforme la médecine générale. Elle est utilisée pour améliorer la prise en charge des patients, optimiser les tâches administratives et aider les médecins à prendre des décisions éclairées. Découvrez les principaux cas d’usage de l’IA pour les médecins généralistes, avec un focus sur 12 solutions déjà adoptées en France.
L’intégration croissante des outils numériques et de l’intelligence artificielle en santé transforme les pratiques médicales. Du diagnostic assisté par IA à l’optimisation de la facturation, les avancées sont nombreuses, mais posent aussi des défis réglementaires et éthiques. Comment les structures médicales s’organisent-elles pour en tirer parti, et quel cadre juridique encadre son utilisation?
Médecins libéraux : un besoin urgent de formation et d’accompagnement
L’URPS Médecins Libéraux Auvergne-Rhône-Alpes, dans son étude de 2023, met en lumière les enjeux liés à l’intégration du numérique, notamment en matière de gestion de cabinet, d’accès aux soins et d’attractivité du métier. Elle s’appuie sur des ateliers-débats menés avec 150 médecins libéraux de différentes spécialités et exerçant dans divers territoires de la région Auvergne-Rhône-Alpes. L’un des constats majeurs est la nécessité d’un accompagnement dans l’adoption du numérique, notamment pour faciliter les tâches administratives, améliorer l’organisation du travail et optimiser les relations interprofessionnelles.
cette transition pose plusieurs défis :
Confidentialité et sécurité des données : Le RGPD impose des règles strictes sur la collecte et le traitement des informations médicales.
Interopérabilité des systèmes : La diversité des plateformes numériques complique le partage des données entre établissements publics et privés.
Fiabilité et biais des algorithmes : L’IA repose sur des données d’apprentissage dont la qualité impacte directement les décisions médicales.
L’étude de l’URPS souligne que 93 % des médecins généralistes exercent exclusivement en libéral, et que l’organisation de leur activité est un enjeu majeur pour l’intégration de nouvelles technologies
L’URPS Médecins Libéraux met en avant plusieurs défis pour les praticiens :
La formation : de nombreux médecins libéraux se sentent insuffisamment formés aux outils numériques, freinant leur adoption.
La complexité administrative : malgré les promesses de simplification, les démarches numériques alourdissent souvent les procédures au lieu de les fluidifier.
L’impact financier : l’investissement dans des outils IA de qualité est un coût important pour les cabinets libéraux.
L’intégration de l’IA dans la gestion des urgences médicales : l’initiative de l’ONSIL
Au-delà de son impact sur la médecine libérale, l’intelligence artificielle joue un rôle croissant dans la coordination des soins et la gestion des urgences. L’ONSIL (Organisation Nationale des Syndicats d’Infirmiers Libéraux) suit de près ces évolutions et soutient des projets innovants destinés à optimiser la prise en charge des patients en situation d’urgence.
Un projet prometteur actuellement en développement permettrait aux infirmiers libéraux (IDEL) d’envoyer des photos des patients aux équipes du SAMU afin d’obtenir une évaluation rapide et une priorisation des prises en charge. Un système de code couleur est également à l’étude pour identifier les appels des infirmiers libéraux comme prioritaires et garantir une réponse plus rapide et adaptée des services d’urgence.
L’initiative, portée par HiGh WinD, une startup spécialisée dans le diagnostic des situations d’urgence par IA, vise à sécuriser la pratique des IDEL tout en renforçant la coordination entre les professionnels de santé et les services de secours. L’ONSIL, en tant que membre de l’Union Nationale des Professions Libérales (UNAPL), a récemment participé à des événements tels que le congrès “Les grandes tendances de la e-santé” et le 32ᵉ congrès de l’UNAPL pour approfondir la réflexion sur l’impact de l’IA dans les professions libérales.
Ce type d’innovation s’inscrit pleinement dans les évolutions numériques qui transforment les métiers de la santé, en apportant des solutions concrètes aux défis de l’urgence médicale, de la télé-expertise et de la coordination des soins. Pour les infirmiers libéraux souvent isolés lors de leurs interventions à domicile, ce dispositif pourrait représenter une avancée significative, améliorant la sécurité des patients et des soignants tout en optimisant les délais d’intervention en cas de situation critique.
L’Ordre des Médecins : encadrer la responsabilité des praticiens
Dans une étude parue en 2024, l’Ordre des Médecins met en garde contre un usage non encadré de l’IA en santé et rappelle que l’utilisation d’outils numériques ne dégage pas le médecin de sa responsabilité.
Les principales préoccupations soulevées sont :
L’obligation pour le médecin d’exercer un esprit critique sur les recommandations fournies par l’IA;
La responsabilité en cas d’erreur de diagnostic : le médecin reste juridiquement responsable des décisions prises, même si elles sont appuyées par un algorithme;
Le risque de dépendance aux outils d’IA, pouvant réduire l’autonomie des praticiens.
L’Ordre souligne également un paradoxe : un médecin qui refuse d’utiliser un outil IA performant pourrait être tenu responsable d’une perte de chance pour son patient. La question de l’obligation d’usage de l’IA pourrait donc émerger à l’avenir
Un remboursement spécifique pour l’usage de l’IA ?
À ce jour, aucun dispositif spécifique de remboursement n’existe pour l’usage de l’IA en médecine. Les actes médicaux réalisés avec l’aide d’un algorithme restent facturés selon la nomenclature classique de l’Assurance Maladie.
Cependant, des discussions sont en cours pour inclure certains outils IA dans le forfait innovation, notamment pour des applications dans le suivi des maladies chroniques.
En mai 2021, le Comité technique de l’innovation en santé de l’Article 51 a mandaté un groupe de sept experts issus du monde académique et administratif pour une réflexion prospective sur le déploiement, le financement et la régulation de la télésurveillance en France.
Ce travail s’appuie sur :
l’analyse d’expérimentations de l’Article 51,
l’étude des effets des technologies et des modèles de rémunération,
une revue de littérature,
ainsi que des échanges avec des experts internationaux.
Entre juin 2021 et février 2023, le groupe a tenu 15 séances de travail pour explorer la valeur créée par la télésurveillance et ses implications organisationnelles et économiques. Une note prospective, rédigée sous la direction de Dominique Polton et du Pr. Étienne Minvielle, propose une synthèse des travaux, soulève des questions sur les modèles de financement et d’évaluation, et esquisse des alternatives inspirées d’expériences étrangères. Sans trancher définitivement, elle vise à éclairer les décideurs sur les enjeux et évolutions possibles de la télésurveillance dans le cadre du droit commun.
Dans cet article, H&TI reviendra sur les points saillants de ce rapport, afin d’analyser ses conclusions et d’en évaluer les implications pour l’écosystème de santé numérique en France.
Une transformation organisationnelle à intégrer
La TLS n’est pas seulement une technologie, elle introduit également une réorganisation des soins. Elle permet de déléguer certaines tâches aux infirmiers et d’autonomiser les patients, ce qui réduit le recours aux consultations médicales traditionnelles. Par exemple, dans le cadre du programme CAPRI, cette approche a permis d’améliorer la qualité des soins pour les patients atteints de cancer tout en réduisant les hospitalisations, avec une économie de 669 € par patient.
Le modèle économique actuel et ses limites
En France, le financement de la TLS repose sur un double système : un forfait « opérateur » pour rémunérer les structures de soins et un forfait « exploitant » pour les éditeurs de solutions numériques. Bien que ce modèle favorise l’implémentation de la TLS, il présente plusieurs limites.
Calibrage des forfaits : Les forfaits alloués aux opérateurs sont souvent jugés insuffisants pour couvrir les coûts du personnel, tandis que les forfaits destinés aux exploitants peuvent être perçus comme déséquilibrés par rapport à leurs coûts réels.
Fragmentation des financements : Le financement par pathologie conduit à l’achat de solutions spécifiques pour chaque besoin, ce qui peut générer des coûts supplémentaires à long terme.
Risques liés à la rémunération directe : Le modèle actuel, basé sur un paiement par patient pour les industriels, pourrait entraîner des comportements inflationnistes ou créer une dépendance économique envers certains fournisseurs.
Modèles internationaux et approches alternatives
Des pays comme le Canada et les États-Unis ont adopté des approches différentes pour financer la TLS. Au Canada, la TLS est intégrée aux fonctionnalités génériques des dossiers médicaux électroniques, réduisant les coûts et favorisant une approche centralisée. Aux États-Unis, un système détaillé de codes pour chaque étape de la TLS (éducation, collecte et analyse des données, suivi) structure le financement, permettant une facturation précise et adaptée.
Vers un financement global
Une des propositions du rapport est de passer à un modèle de financement global basé sur le parcours de soins, plutôt qu’une rémunération spécifique à la TLS. Cette approche simplifierait la gestion et encouragerait une meilleure coordination entre les différents acteurs de santé. Le financement global pourrait inclure la TLS, mais aussi d’autres outils et innovations organisationnelles, en mettant l’accent sur les résultats obtenus plutôt que sur des actes spécifiques.
Une technologie en phase d’apprentissage
Le rapport indique que la TLS est encore en phase de développement. Il est essentiel de maintenir une flexibilité dans son évaluation et son financement pour permettre l’émergence des pratiques les plus efficaces. L’intelligence artificielle, par exemple, pourrait à terme redéfinir certains aspects de la TLS, en particulier dans le tri et la gestion des patients.
La télésurveillance médicale représente une méthode efficace pour moderniser les systèmes de santé et améliorer la prise en charge des patients. Son développement dépendra d’une adaptation des modèles économiques actuels, en favorisant des financements globaux et une répartition équilibrée des bénéfices entre les acteurs. L’expérimentation et l’évaluation est essentielles pour garantir un déploiement durable et optimal de cette technologie.
Activité constante sur l’année , montants records en septembre
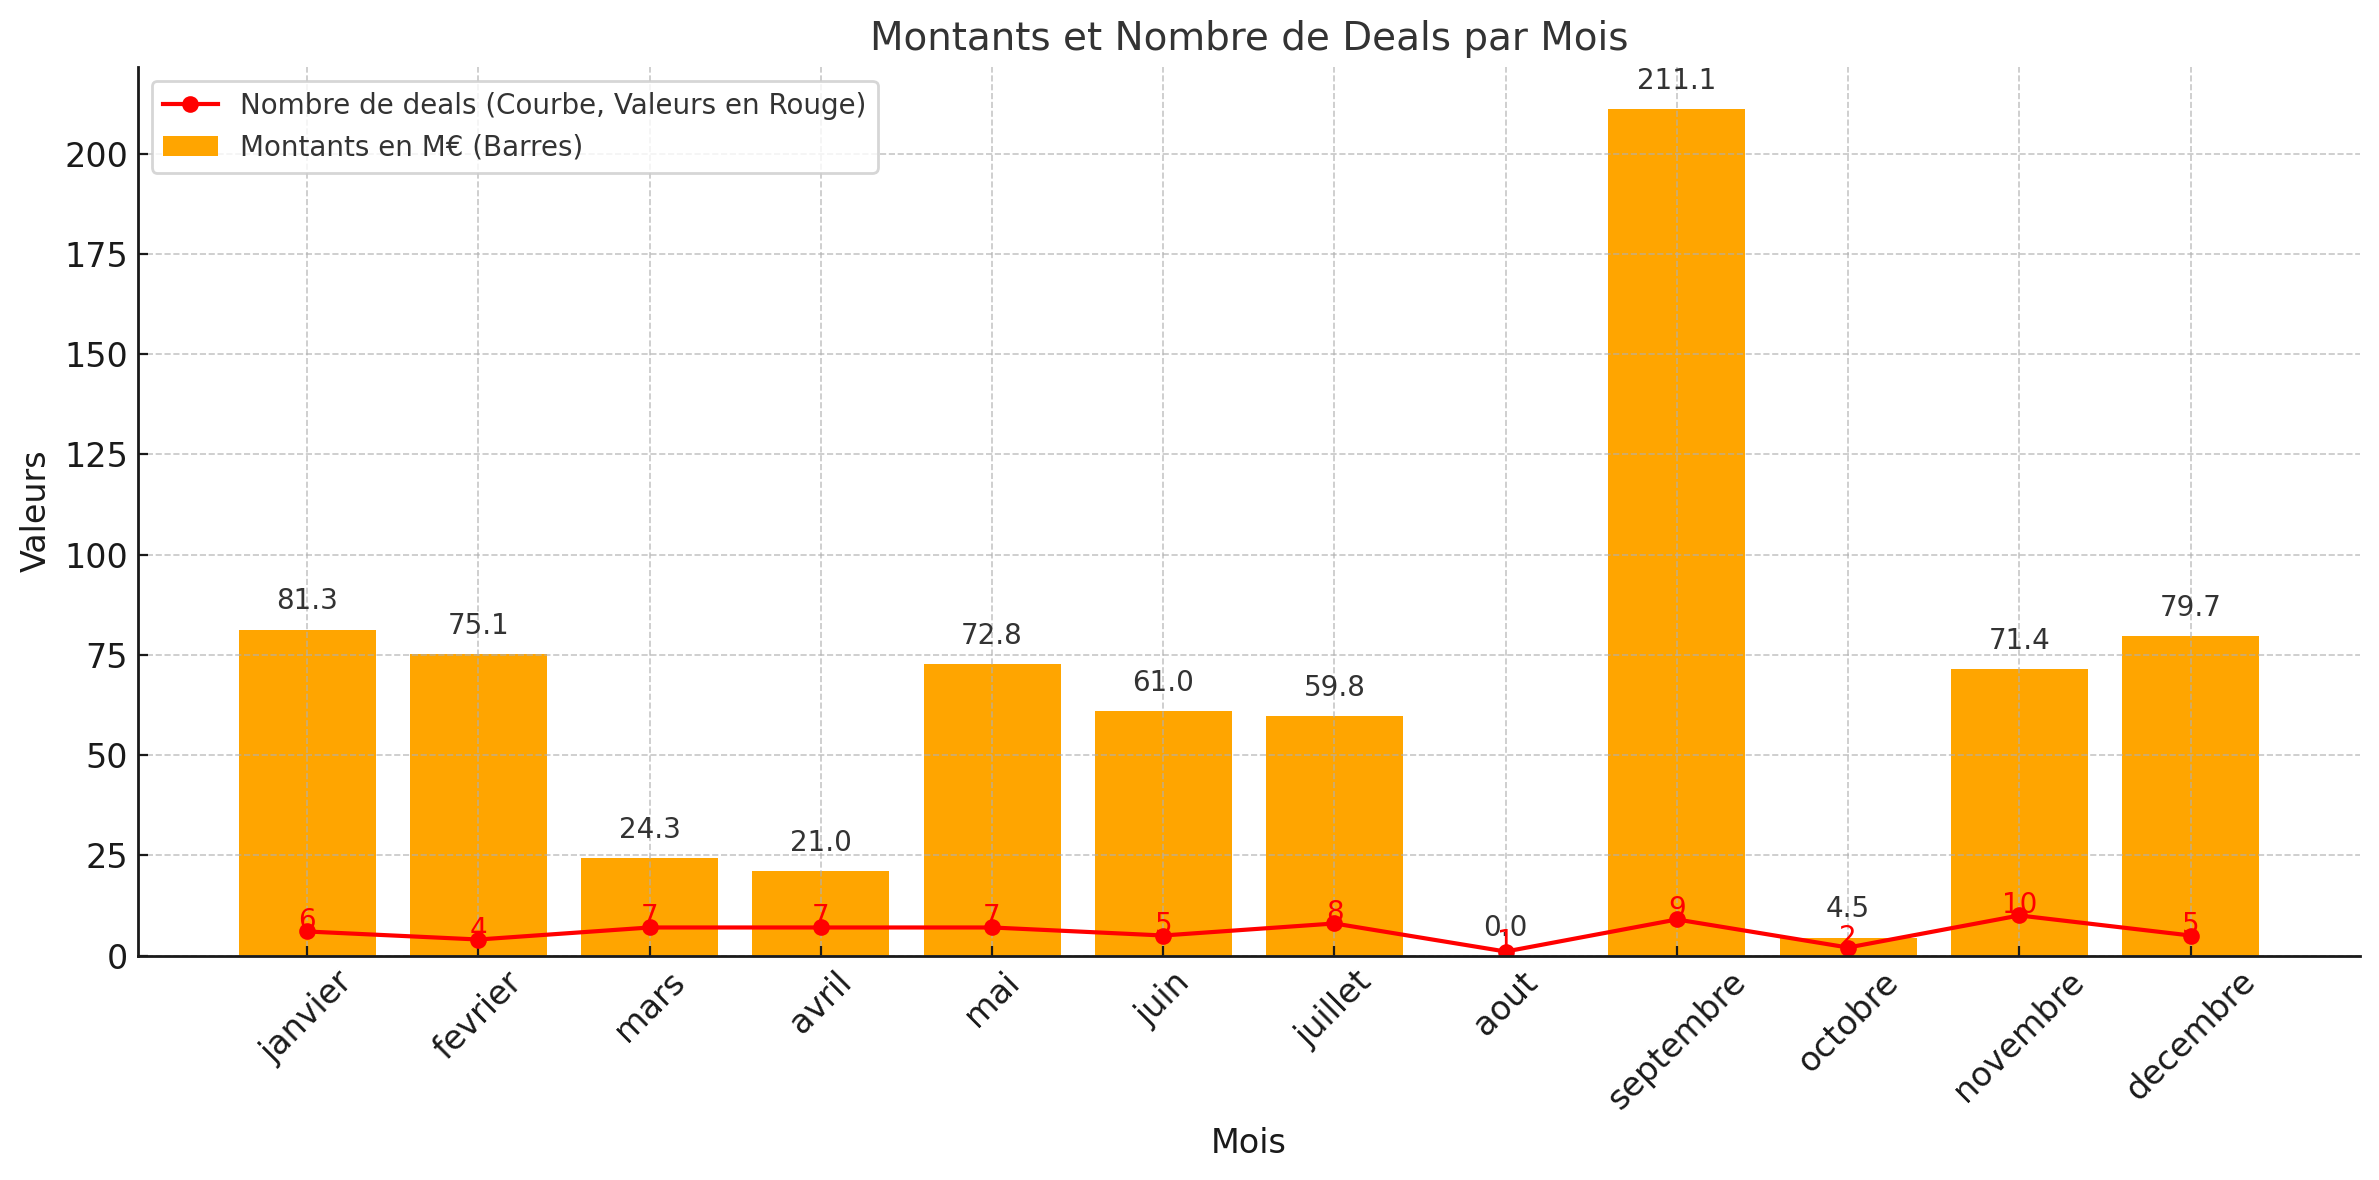
Périodes fortes : Septembre est le mois record avec 211,1 M€ levés en 9 deals. Novembre affiche le plus grand nombre de deals (10) pour un montant de 71,4 M€.
Saisonnalité : Une forte activité est observée en début (janvier) et fin d’année (novembre, décembre);
Corrélation partielle : Un grand nombre de deals n’entraîne pas toujours des levées significatives (ex. octobre : 2 deals, 4,5 M€).
Les levées de fonds ont été particulièrement marquées par des pics d’activité au cours de l’année. Le troisième trimestre s’est distingué avec un montant record de 280,9 millions d’euros, porté notamment par la levée d’Alan en septembre. Le quatrième trimestre a également été actif avec 155,6 millions d’euros levés.
Sur le plan des phases de financement, la série F domine avec 173 millions d’euros. Les séries A et Seed suivent avec respectivement 141,9 millions d’euros et 107,1 millions d’euros, témoignant du dynamisme des entreprises en phase de développement initial.
Auvergne-Rhône-Alpes , Occitanie et Nouvelle-Aquitaine dans le Top 5 des régions attractives
La répartition géographique des levées de fonds montre une concentration significative autour des grands pôles urbains et économiques. la région parisienne se distingue largement avec un total de 595 millions d’euros, soit plus de cinq fois les montants levés dans la deuxième région la plus performante. Cette domination s’explique notamment par la présence de startups phares comme Alan, qui a levé 173 millions d’euros, et TRICares avec 47 millions d’euros.
La région Auvergne-Rhône-Alpes arrive en deuxième position avec 92,1 millions d’euros, suivie de l’Occitanie et la Nouvelle-Aquitaine, avec respectivement 22,8 millions d’euros et 21,6 millions d’euros.
En 2024, le secteur de la santé numérique en France a connu une forte activité de fusions et acquisitions, marquée par des opérations comme l’achat d’Amolyt Pharma, société de biotechnologie Lyonnaise spécialisée dans les maladies métaboliques rares, par AstraZeneca pour un montant d’1,05 milliard de dollars. Cette cartographie présente les principales transactions de l’année.
L’année 2024 a marqué un tournant dans le paysage des levées de fonds aux États-Unis, selon le rapport State of Venture 2024 de CB Insights. Malgré un contexte économique globalement incertain, les tendances clés révèlent un dynamisme retrouvé, notamment grâce à des secteurs émergents comme l’intelligence artificielle (IA). Voici les principaux enseignements de cette année.
Parmi les entreprises les plus remarquables, Alan, spécialisée dans l’assurance santé, a réalisé la plus importante levée de fonds de l’année avec 173 millions d’euros. Elle est suivie par TRICares (47 millions d’euros), active dans le domaine des dispositifs médicaux, et par uromems, qui a levé 44 millions d’euros pour développer des solutions en médecine de précision.
Sur les 761,9 millions d’euros levés par les entreprises françaises du numérique en santé en 2024, 467,7 millions d’euros ont été levés lors des 10 plus grosses levées de fonds de l’année. Alan, Aqemia, Tricares… 9 sociétés ont levé entre 22 et 173 millions d’euros au cours de l’année 2024.
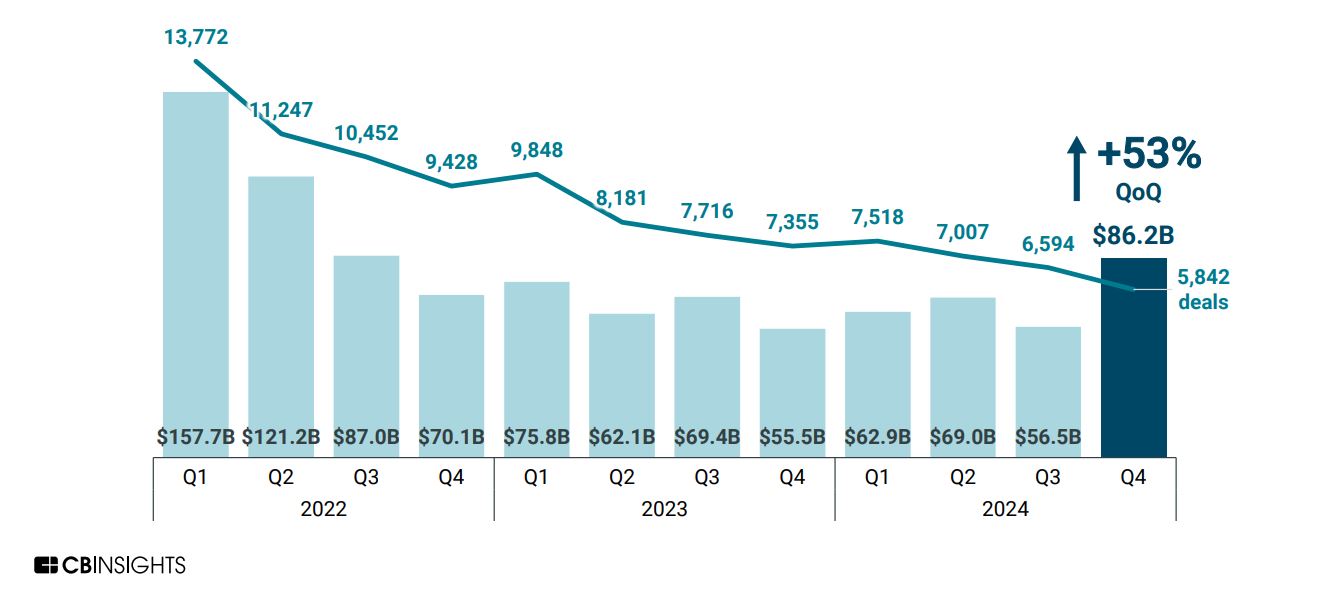
Après plusieurs années de ralentissement marqué, le dernier trimestre 2024 (Q4) a enregistré un volume de financement de 60,8 milliards de dollars répartis sur 2 169 transactions, selon les données de CB Insights. Ce chiffre représente une augmentation significative par rapport aux trimestres précédents et témoigne d’un regain d’optimisme parmi les investisseurs, soutenu par des méga-levées de fonds (deals supérieurs à 100 millions de dollars), qui ont constitué 60 % du financement total.
Cependant, le nombre de transactions continue de diminuer, atteignant seulement 5 842 deals, reflétant une concentration des capitaux sur des méga-transactions. Ce rebond suggère un regain de confiance des investisseurs malgré un marché encore sélectif.
En synthèse :
2024 a confirmé la résilience et la capacité d’adaptation de l’écosystème de levées de fonds aux États-Unis, tout en soulignant l’importance croissante de l’IA comme moteur d’innovation. Ce bilan laisse présager une année 2025 tout aussi dynamique, portée par les tendances technologiques et les évolutions des marchés ;
Tout comme en France, les levées de fonds précoces (early-stage) ont connu un regain d’intérêt, atteignant un montant médian record de 25 millions de dollars. Les startups en phase initiale bénéficient de la capacité à développer des produits avec des coûts réduits grâce aux avancées technologiques, notamment en IA. Cependant, les financements en stade intermédiaire et tardif, bien qu’en légère reprise par rapport à 2023, restent inférieurs aux niveaux de 2021 et 2022 ;
En 2024, le temps médian entre le premier financement et l’introduction en bourse pour les startups soutenues par du capital-risque a atteint 7,5 ans, soit deux ans de plus qu’en 2022. Cela reflète des conditions de marché défavorables qui poussent certaines entreprises à privilégier des tours de table supplémentaires ou des ventes d’actions privées pour maintenir leur liquidité ;
Les hubs traditionnels tels que la Silicon Valley et New York ont continué de dominer les levées de fonds. Cependant, d’autres régions comme Austin et Miami commencent à émerger, attirant des capitaux importants grâce à des environnements fiscaux favorables et des écosystèmes technologiques en plein essor.
L’Ascension de l’Intelligence Artificielle : redéfinition du paysage de l’investissement, consolidant sa place comme secteur prioritaire pour les investisseurs en capital-risque
Le rapport note également une augmentation de 150 % des transactions liées à l’IA. Ces technologies, encore à un stade émergent, attirent des investissements massifs, les investisseurs misant sur leur potentiel disruptif.
Quelques points saillants du rapport :
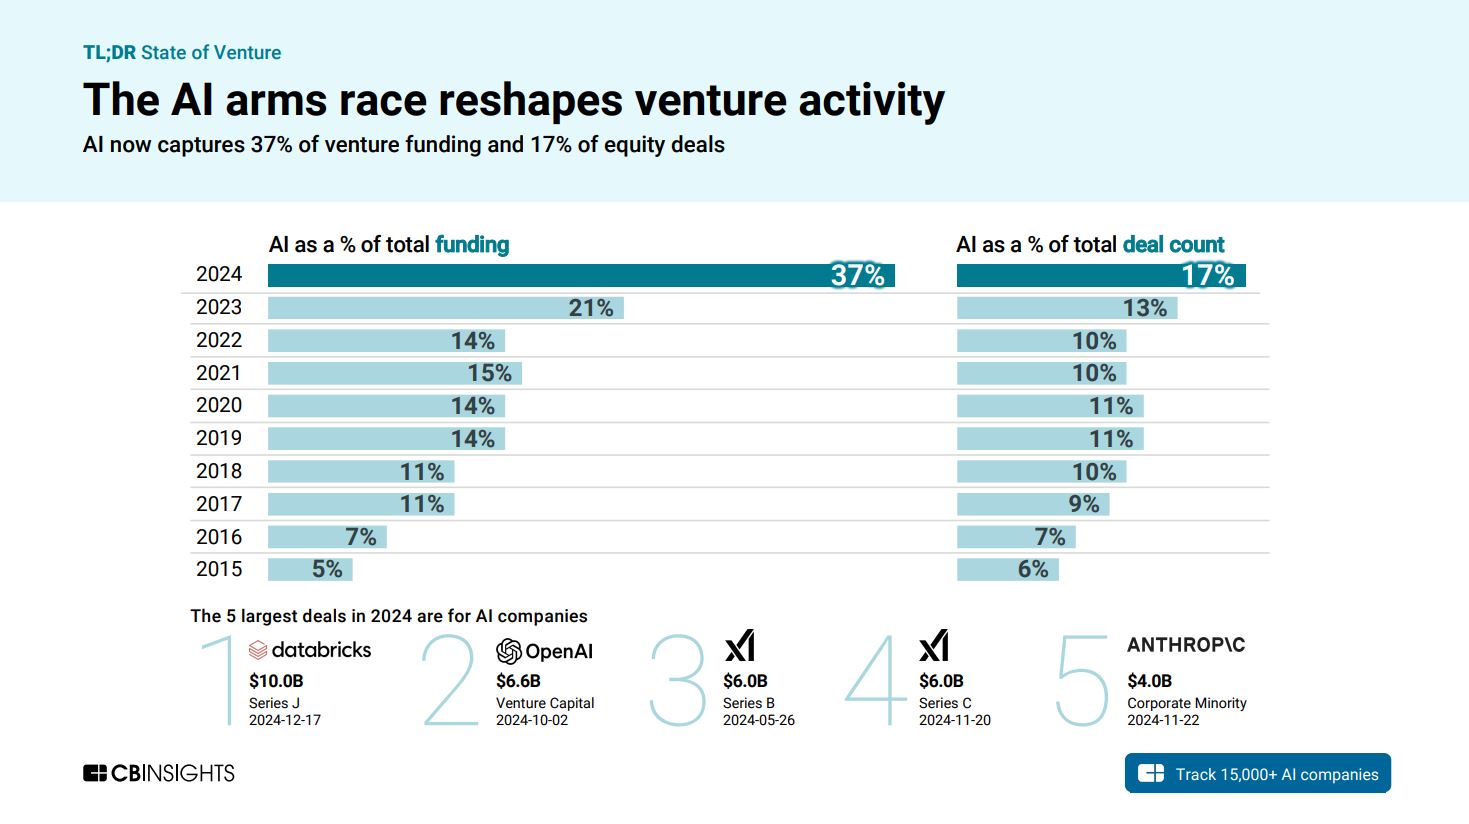
Hausse historique de la part de l’IA : En 2024, l’IA a capturé 37 % du financement total en capital-risque et 17 % du nombre total de transactions, un record. Cela montre l’engouement croissant des investisseurs pour ce domaine.
Croissance rapide depuis 2015 : La part du financement pour l’IA est passée de 5 % en 2015 à 37 % en 2024, avec une progression particulièrement marquée depuis 2022 (14 % à 37 %).
Transactions majeures : Les 5 plus grandes levées de fonds de l’année ont été réalisées par des entreprises d’IA. Databricks a dominé avec une levée record de 10 milliards de dollars (série J), suivie par OpenAI (6,6 milliards de dollars) et xAI (6 milliards de dollars).
Raisons de cet intérêt : Cette tendance reflète l’importance stratégique de l’IA dans divers secteurs économiques, avec des investisseurs qui cherchent à capturer les bénéfices futurs de ces technologies émergentes
Près de trois transactions sur quatre dans l’IA étaient à un stade précoce (early-stage), soulignant une stratégie claire des investisseurs de miser sur des innovations prometteuses. Ces levées précoces ont attiré des montants record avec une valuation médiane à ce stade atteignant 25 millions de dollars.
Fusions et acquisitions en santé numérique : Une entreprise sur deux acquises en 2024 était spécialisée en intelligence artificielle.
Santé numérique : Financement à l’équilibre
Selon les données CBInsight, on observe une baisse marquée du financement et des transactions en santé numérique depuis le pic de 2021 lié à la crise sanitaire (52,8 Mds $ et 2 902 deals) jusqu’à 2024 (15,6 Mds $ et 1 225 deals). Cette tendance reflète un retour à la normalité post-pandémie, avec une stabilisation relative entre 2023 et 2024, les investisseurs se concentrant sur des projets stratégiques.
Quelques évènements marquants à l’international 2024:
Ambience Healthcare lève 70 M$ pour faciliter la prise en charge des maladies pulmonaires : La start-up californienne Ambience Healthcare a annoncé une levée de fonds de 70 millions de dollars en série B, dans un tour de table mené par Kleiner Perkins et OpenAI Startup Fund. La jeune pousse développe des outils d’intelligence artificielle pour aider les médecins à diagnostiquer et à traiter les maladies pulmonaires ;
Alaffia Health lève 10 M$ pour développer ses solutions GenAI: Spécialisée dans les solutions d’intelligence artificielle générative (Gen AI) pour les demandes d’assurance santé, Alaffia Health sécurise 10 millions de dollars lors d’un tour de financement de série A, portant son financement total à 17,6 millions de dollars ;
Transcarent évaluée à 2,2 M$ après son dernier tour de table et une levée de fonds de 126 M$ : Cette opération, témoigne de la confiance croissante des investisseurs dans les startups technologiques, en particulier dans le secteur de la santé. Fondée en 2020, Transcarent est une startup de santé numérique qui aide les entreprises à réduire les coûts et à gérer efficacement les prestations de soins de santé pour leurs employés en utilisant l’IA pour réduire la complexité ;
Xaira Therapeutics lève 1 Md$ pour sa plateforme d’intelligence artificielle : Xaira Therapeutics, une entreprise de découverte et de développement de médicaments basée sur l’IA, a annoncé son lancement avec plus de 1 milliard de dollars de capital. Dirigée par le PDG Dr. Marc Tessier-Lavigne, Xaira se concentre sur la découverte et le développement de médicaments grâce à l’apprentissage automatique et à la modélisation des données ;
EvolutionaryScale lève 142 millions de dollars pour son modèle d’IA en biologie : EvolutionaryScale, start-up spécialisée en intelligence artificielle générative pour la biologie, a levé 142 M$ pour soutenir la recherche et le développement de sa solutions en biologie computationnelle, visant à transformer les domaines de la génomique, de la protéomique et de la biochimie. L’objectif est d’accélérer les découvertes scientifiques et d’améliorer les traitements médicaux ;
Huma lève 80 M$ et lance une plateforme IAGen: Cette levée de fonds en série D permettra à Huma de lancer sa nouvelle plateforme Huma Cloud, intégrant l’intelligence artificielle générative. Cette initiative vise à accélérer le développement de solutions de santé numérique en réduisant les coûts et les délais, avec des fonctionnalités de configuration sans code et d’hébergement flexible ;
Truvian Health lève 74 M$ pour une plateforme de diagnostics sanguins automatisés : Cette levée de fonds permettra d’accélérer la commercialisation de sa technologie, qui vise à fournir des résultats de tests sanguins rapides et précis en point de soins. Cette innovation pourrait transformer la manière dont les diagnostics médicaux sont réalisés, rendant les tests plus accessibles et efficaces pour les patients et les professionnels de santé ;
La société de capital-risque Asabys Partners lève 200 M$ pour investir dans l’innovation en santé : a société basée à Barcelone, a levé 180 M€ pour soutenir l’innovation dans la santé numérique. Dirigée par Maite Malet, la firme prévoit d’investir dans 12 à 15 entreprises en Europe, avec des plans d’expansion aux États-Unis, pour accompagner leur croissance de la phase initiale à leur expansion internationale, en particulier dans le domaine de la technologie de santé.
TOP 10 des levées de fonds réalisées aux USA en 2024
En 2024, plusieurs régions ont émergé comme des pôles majeurs d’innovation en santé numérique Paris et l’île de France s’impose une fois de plus en tête avec plus de 595,7 millions d’euros, soit plus de cinq fois les montants levés dans la deuxième région la plus performante : Auvergne-Rhône-Alpes. Cette dernière est suivie par l’Occitanie et la Nouvelle Aquitaine.
Une dynamique soutenue tout au long de l’année
Les levées de fonds ont été particulièrement marquées par des pics d’activité au cours de l’année. Le troisième trimestre s’est distingué avec un montant record de 280,9 millions d’euros, porté notamment par la levée d’Alan en septembre. Le quatrième trimestre a également été actif avec 155,6 millions d’euros levés.
Sur le plan des phases de financement, la série F domine avec 173 millions d’euros. Les séries A et Seed suivent avec respectivement 141,9 millions d’euros et 107,1 millions d’euros, témoignant du dynamisme des investisseurs pour des entreprises en phase de développement initial.
Quelques faits saillants :
71 opérations réalisées par les startups de la santé numérique et plus de 762 M€ levés en 2024 ;
Le ticket moyen est de 11,2M€ ;
Alan réalise le seul megadeal (> 100M€) avec un ticket de 173M€ ;
Plus de la moitié des entreprises ayant levé des fonds au premier trimestre 2024 ont recueilli des montants entre 5 et 30 millions d’euros, avec plus de 44 % des opérations réalisées en amorçage. Ce bilan au premier trimestre 2024 est marqué par l’absence de mega deals : aucune levée de fonds ne dépasse les 30 millions d’euros.;
Au deuxième trimestre, le ticket maximum est de 44 millions d’euros, près de la moitié des opérations réalisées ont été faites en amorçage tout comme au premier trimestre ;
Au troisième trimestre, le ticket maximum est de 44 millions d’euros, près de la moitié des opérations réalisées ont été faites en amorçage ;
Intelligence artificielle (IA) : L’IA reste un moteur majeur d’innovation, appliquée notamment à la découverte de médicaments, avec des levées importantes comme celle de AQEMIA (36,2 millions d’euros);
Certaines entreprises comme inheart et Aqemia ont réalisé plusieurs levées au cours de l’année, témoignant de leur solidité et de la confiance des investisseurs.
L’année 2024 s’achève avec des résultats prometteurs pour les entreprises de la santé numérique en France. Les levées de fonds témoignent de l’intérêt croissant des investisseurs pour ce secteur, marqué par des innovations technologiques et des solutions de santé connectées.
La santé numérique reste un secteur clé, attirant des capitaux importants et stimulant l’innovation en France. Les investissements réalisés en 2024 montrent une dynamique forte, tant au niveau des technologies développées que des capacités de ces entreprises à répondre aux besoins croissants en solutions de santé connectée et personnalisée.
Avec un écosystème en pleine expansion et des entreprises prometteuses, 2025 pourrait être une année décisive pour confirmer le leadership de la France dans ce secteur stratégique.
Anne Maheust, CEO d’Interop’Santé, a ouvert la discussion en rappelant que « l’interopérabilité sémantique est une dimension essentielle de la qualité des données. Elle permet de lever les silos et d’assurer une collaboration fluide entre les différents acteurs de l’écosystème de santé. » Elle a également souligné l’importance de fédérer les producteurs de données autour d’initiatives communes, comme le fait Interop’Santé en France.
L’interopérabilité comme levier stratégique
Diego Kaminker (HL7 International) a présenté l’impact des standards globaux dans l’amélioration des systèmes de santé. Il a souligné que l’interopérabilité technique (structure des données) ne suffit pas si elle n’est pas accompagnée d’une interopérabilité sémantique (compréhension partagée des données). « Lorsque les données cliniques sont alignées avec des terminologies standardisées, les erreurs diminuent, et la qualité des soins s’améliore », a-t-il affirmé. Il a également évoqué les avancées de HL7 FHIR, qui fournit une API standardisée pour l’échange d’informations.
Interrogée sur les perspectives à court terme, Catherine Chronaki (HL7 Europe) a expliqué que des efforts sont en cours pour harmoniser les priorités au niveau européen, notamment autour de six catégories prioritaires : résumés de patients, prescriptions électroniques, dispensations, rapports d’examens, résultats diagnostiques et données médicales structurées. Elle a rappelé l’importance de l’adoption collaborative de ces standards pour atteindre les objectifs fixés pour 2025.
La France en avance sur certains domaines
Du côté français, Thierry Dart et Maël Le Gall (ANS) ont détaillé les initiatives nationales, notamment le Cadre d’Interopérabilité des Systèmes d’Information de Santé (CI-SIS). Ils ont illustré ces efforts par des cas concrets, comme le projet Mon Espace Santé, qui intègre des données standardisées grâce à SNOMED CT et FHIR, insistant sur la nécessité d’une traduction précise des standards internationaux en contextes locaux pour garantir leur adoption par les professionnels de santé.
Lors d’une question sur l’intégration des standards dans les systèmes existants, Nicolas Riss (ANS) a évoqué les défis techniques liés à l’hétérogénéité des données dans les établissements de santé. Il a expliqué que l’usage de terminologies comme SNOMED CT et LOINC permet non seulement de structurer les données, mais aussi de les annoter pour des utilisations secondaires, comme la recherche clinique ou l’entraînement d’algorithmes d’intelligence artificielle.
Une vision d’avenir tournée vers les écosystèmes ouverts
Stefan Schraps a clôturé la session en partageant sa vision d’un écosystème de santé piloté par les données. Selon lui, l’avenir repose sur des systèmes ouverts, capables de gérer des données longitudinales tout au long de la vie d’un patient. « La structuration homogène des données est essentielle, car des données mal harmonisées créent des inefficacités et des erreurs coûteuses », a-t-il précisé. Il a également plaidé pour une adoption conjointe des standards FHIR (pour l’échange) et OpenEHR (pour la persistance des données), afin d’assurer la pérennité des systèmes.
Perspectives à cinq ans
En conclusion, les experts ont répondu à une question sur l’avenir de l’interopérabilité sémantique d’ici cinq ans. Tous ont convenu que l’accélération de son adoption sera inévitable, notamment sous l’effet des avancées en intelligence artificielle, qui dépendent de la qualité des données.
Diego Kaminker a ajouté que le succès résidera dans l’utilisation universelle des standards : « Dans cinq ans, nous ne devrions même plus savoir qui utilise FHIR, car il sera omniprésent. »
L’importance des terminologies et de la sémantique pour l’interopérabilité des données de santé
En conclusion de la session, l’Agence du Numérique en Santé (ANS) a mis en avant le rôle des terminologies et de la sémantique dans l’interopérabilité des données de santé. Ces éléments permettent de garantir une communication efficace entre les systèmes tout en préservant la signification des informations échangées.
Les besoins fondamentaux
Préserver le sens des données : La sémantique assure que la signification des données reste intacte lors des échanges entre systèmes;
Agréger les données : Elle permet de consolider des informations issues de sources variées pour une meilleure exploitation;
Enrichir les données : Grâce à l’annotation et au traitement automatique du langage naturel (NLP), il devient possible de relier des synonymes ou d’analyser des documents non structurés;
Raisonner sur les données : La sémantique autorise des déductions et ouvre la voie à de nouvelles connaissances.
Les bonnes pratiques
Utiliser des référentiels standards : L’adoption de terminologies universelles, telles que SNOMED CT ou LOINC, est essentielle pour harmoniser les échanges;
Adapter les référentiels : Traduire et contextualiser les terminologies permet leur utilisation dans différents cadres nationaux;
Publier selon des normes : Les terminologies et leurs correspondances doivent être diffusées de manière standardisée (par exemple, avec FHIR ou RDF/OWL) pour garantir leur interopérabilité.
En adoptant ces approches, la sémantique et les terminologies contribuent à une meilleure qualité des soins et à l’optimisation des données de santé, en consolidant un écosystème numérique centré sur le patient et son parcours.
Un appel à l’action collective
Cette session a mis en évidence la nécessité d’une mobilisation collective pour renforcer l’interopérabilité sémantique à l’échelle locale et globale. En harmonisant les pratiques et en formant les professionnels de santé, ces standards permettront non seulement d’améliorer les soins, mais aussi de faire des données de santé un véritable moteur d’innovation.
Qu’est-ce qui caractérise les “bonnes données” en santé ?
L’intelligence artificielle (IA) redéfinit le secteur de la santé, apportant des transformations majeures dans des domaines tels que le diagnostic, la médecine personnalisée, et l’efficacité opérationnelle, tout en introduisant de nouveaux modèles de soins. Toutefois, la robustesse des solutions de santé basées sur l’IA repose fondamentalement sur la qualité des données utilisées. Des données de mauvaise qualité ou un manque d’interopérabilité peuvent compromettre l’efficacité des modèles d’IA, voire les rendre nuisibles.
Dans le domaine de la santé, où chaque décision peut avoir un impact direct sur les patients, la qualité des données est une exigence cruciale. Des cadres normatifs tels qu’openEHR, FHIR, et SNOMED CT jouent un rôle clé en garantissant la qualité, l’interopérabilité, et la clarté sémantique des données, établissant ainsi une base solide pour le déploiement efficace de l’IA.
Les données de santé, souvent complexes et issues de multiples sources (dossiers médicaux électroniques, systèmes de laboratoire, dispositifs médicaux, et systèmes d’imagerie), doivent respecter des critères stricts pour être exploitables par l’IA :
précision : Données exemptes d’erreurs et d’incohérences ;
exhaustivité : Ensemble de données aussi complet que possible, avec un minimum de données manquantes ;
clarté sémantique : Définitions précises et univoques, assurant une interprétation cohérente entre les systèmes ;
interopérabilité : Structuration permettant un échange fluide sur diverses plateformes ;
et actualité : Données collectées et traitées en temps réel ou quasi réel.
De plus, ces données doivent être conformes aux réglementations en matière de protection des données, telles que le RGPD, tout en restant accessibles pour la formation et l’inférence de modèles d’IA.
Le rôle des normes pour garantir des données fiables
Une base pour des données structurées et interopérables
OpenEHR est une norme ouverte qui fournit un cadre complet pour la gestion des dossiers médicaux interopérables tout au long de la vie. Cette norme se distingue par :
structuration des données : Concepts cliniques représentés via des archétypes, garantissant la lisibilité et la réutilisabilité ;
interopérabilité : Échange fluide de données via des formats standardisés ;
précision sémantique : Conservation du contexte et de la signification des données cliniques pour une interprétation correcte par l’IA.
FHIR : faciliter l’interopérabilité
Fast healthcare interoperability resources (FHIR) est conçu pour l’échange de données de santé entre systèmes. Ses points forts incluent :
des API permettant le partage en temps réel, essentiel pour des applications telles que l’analyse prédictive et l’aide à la décision ;
une conception modulaire qui s’adapte à divers cas d’utilisation ;
une intégration fluide avec les systèmes existants, déverrouillant des données auparavant isolées.
SNOMED CT est un système de terminologie clinique normalisé qui assure la cohérence sémantique dans les écosystèmes openEHR et FHIR. Ses atouts incluent :
codification des données cliniques : Diagnostics, procédures et observations standardisés pour une exploitation calculable ;
compréhension contextuelle : Permet aux modèles d’IA de saisir la signification clinique des données ;
Adaptabilité internationale : Support multilingue, facilitant l’utilisation globale des solutions d’IA.
Pourquoi des données fiables sont-elles essentielles pour l’IA en santé ?
📌 Qualité des données, qualité des résultats :
L’efficacité des modèles d’IA dépend directement de la qualité des données d’entraînement. Des données biaisées ou inexactes compromettent les prédictions, pouvant entraîner des résultats inappropriés.
📌 Interopérabilité pour l’évolutivité :
L’interopérabilité, assurée par des cadres tels que FHIR et openEHR, permet d’accéder à des ensembles de données diversifiés, essentiels pour des modèles d’IA robustes.
📌 Précision sémantique et interprétation cohérente :
L’interopérabilité sémantique garantit que les données sont interprétées uniformément, évitant les ambiguïtés critiques dans des applications comme l’aide à la décision clinique.
📌 Données longitudinales pour l’apprentissage continu :
Les données longitudinales, couvrant toute la vie d’un patient, favorisent l’apprentissage continu des systèmes d’IA. openEHR est spécifiquement conçu pour prendre en charge de tels dossiers.
Construire des données adaptées à l’IA grâce aux normes
En combinant les forces d’openEHR, FHIR et SNOMED CT, les organisations de santé peuvent créer des écosystèmes de données optimisés pour l’IA :
OpenEHR assure un stockage structuré avec une préservation du contexte;
FHIR facilite l’échange de données en temps réel;
SNOMED CT codifie les concepts cliniques pour garantir une interprétation cohérente.
L’exemple de l’analyse prédictive des maladies chroniques
Un hôpital intégrant openEHR pour le stockage de ses données peut utiliser les API FHIR pour connecter des flux de données en temps réel et enrichir ces informations avec des codifications SNOMED CT. Ces données combinées permettent :
de prédire la progression des maladies chroniques.
d’identifier les patients à haut risque.
de fournir des informations exploitables en temps réel aux cliniciens.
En conclusion, pour que l’IA atteigne son plein potentiel dans le domaine de la santé, il est indispensable d’investir dans la qualité des données, l’interopérabilité et les normes. Ces fondations permettront non seulement d’assurer la fiabilité et la sécurité des solutions d’IA, mais également de transformer les résultats des patients à l’échelle mondiale.
Standardisation des données de santé : Défis, opportunités et typologie proposée
Dans leur article publié le 9 avril 2024 dans le Journal of Medical Internet Research (DOI : 10.2196/55779), Guy Tsafnat, Rachel Dunscombe, Davera Gabriel, Grahame Grieve et Christian Reich explorent les enjeux liés à l’interopérabilité des données en santé numérique. Constatant un écosystème fragmenté et des efforts d’interopérabilité souvent incohérents, les auteurs mettent en évidence les limites d’une prolifération de standards incompatibles. Ils proposent une typologie structurée des besoins en données de santé, articulée autour de trois domaines : les soins cliniques et l’administration, l’échange de données, et l’analyse longitudinale. Chaque domaine est examiné à travers ses caractéristiques propres et les défis qu’il pose, avec des recommandations de conception à la fois générales et spécifiques. L’article souligne l’importance stratégique des standards ouverts pour favoriser une collaboration plus efficace, réduire les inefficacités et garantir des soins de meilleure qualité, tout en s’adaptant aux besoins diversifiés des acteurs de la santé.
Trois domaines clés des données de santé
Soins cliniques et administration
Les données de santé sont générées pour documenter la prestation de services cliniques à diverses fins, notamment la continuité des soins et la facturation. Un référentiel de dossiers médicaux contenant l’historique complet de chaque patient est nécessaire pour fournir des soins continus et cohérents de manière efficace et efficiente. Étant donné que les soins cliniques manquent parfois d’une base de données probantes solide à partir de laquelle les meilleures pratiques peuvent être glanées, la documentation des soins doit pouvoir traiter un large éventail de types de données, y compris les événements « ponctuels » reflétant des circonstances imprévues chez le patient .
L’objectif principal des normes d’interopérabilité des dossiers médicaux électroniques est de protéger les utilisateurs contre la dépendance vis-à-vis d’un fournisseur, dans laquelle le coût du changement vers un meilleur système dépasse les avantages attendus du changement. Un système de dossiers médicaux électroniques qui utilise une norme ouverte peut remplacer un autre qui utilise la même norme beaucoup plus facilement et avec moins de perturbations pour la pratique clinique que deux systèmes incompatibles où la transformation des données d’un système à l’autre représente la part du lion du coût.
Échange de données
Les dossiers médicaux sont utilisés dans la communication entre différents acteurs. Par exemple, la continuité des soins dépend du partage d’informations sur le patient par plusieurs prestataires de soins de santé, et une facturation efficace nécessite le partage d’informations entre prestataires et payeurs. Il est souvent essentiel que les informations soient transmises immédiatement entre les systèmes pour éclairer les décisions urgentes. Les normes de transmission des données de santé devraient pouvoir être organisées en petites quantités qui incluent toutes les informations pertinentes et uniquement celles-ci.
L’objectif principal des normes d’échange de données est la fidélité aux processus opérationnels de soins de santé. Par exemple, l’un des objectifs est de capturer et de représenter fidèlement la terminologie utilisée dans les processus locaux, quelle qu’elle soit, plutôt que de restreindre l’utilisation à une terminologie commune.
Analyse longitudinale
Le modèle commun de données (OMOP) du partenariat Observational Medical Outcomes Partnership (OHDSI) est une norme ouverte conçue pour l’interrogation longitudinale des dossiers cliniques. Son utilisation d’un modèle relationnel centré sur le patient le rend adapté aux requêtes complexes sur de nombreux dossiers de patients pour découvrir des modèles et des tendances à l’aide de techniques statistiques et d’apprentissage automatique.
Les exigences de chaque norme de données ne permettant pas de remplacer les autres, des projets d’harmonisation sont menés par des bénévoles de la communauté afin de fournir des transformations standard d’une norme à une autre. Par exemple, la collaboration entre OHDSI et HL7 se manifeste par un groupe de travail commun qui organise des réunions hebdomadaires pour produire un guide de mise en œuvre des algorithmes qui convertissent les données de FHIR à OMOP et d’OMOP à FHIR. Des projets similaires visant à harmoniser openEHR avec OMOP et FHIR avec openEHR fournissent une architecture standard pour une interopérabilité et une réutilisation efficaces des données qui créeront un cercle vertueux de participation croissante de la communauté, d’amélioration des normes et de simplification de l’harmonisation. Ces groupes de bénévoles sont très bénéfiques, non seulement pour les normes auxquelles ils se consacrent, mais aussi pour les systèmes de santé du monde entier.
Praticité, faisabilité et communauté
Compromis techniques
L’adéquation technique d’une norme au problème qu’elle traite est importante, mais la santé numérique et l’interopérabilité des données sont des disciplines appliquées. Les considérations pratiques et sociotechniques, telles que les compétences disponibles, sont aussi importantes, voire plus importantes, que la supériorité technique. Bien qu’aucune norme ne soit parfaite, il existe des différences majeures entre ce que les normes peuvent faire « prêtes à l’emploi » et le degré de personnalisation requis avant de pouvoir les utiliser. Pour assurer l’interopérabilité des données dans la pratique, les normes doivent trouver le bon équilibre entre personnalisation et rigidité. Les données de base pour l’interopérabilité des États-Unis sont un excellent exemple de cet équilibre . Ces définitions d’éléments de données de base sont réglementées pour une utilisation aux États-Unis et peuvent être considérées comme un point médian entre les personnalisations nécessaires à chaque site et la rigidité concernant des éléments de données spécifiques.
Engagement communautaire
Les normes de données ne sont utiles que dans la mesure où elles sont adoptées par les organisations collaboratrices. Les normes largement utilisées dans la communauté sont donc plus susceptibles d’être bénéfiques pour les organisations qui cherchent à rejoindre des réseaux de collaboration qui utilisent ces normes. L’engagement des communautés qui non seulement utilisent une norme, mais qui y contribuent également et l’améliorent au fil du temps, différencie les normes existantes des normes plus durables. Une communauté activement engagée fera évoluer, au fil du temps, même une norme infantile vers une norme supérieure. Une communauté engagée et dynamique constitue donc un avantage majeur pour la longévité des normes de données qu’elle utilise . Les normes ouvertes ont un net avantage sur les normes propriétaires, car elles sont disponibles pour la contribution d’un public plus large et sont testées dans des environnements plus divers. Inversement, il est généralement plus facile de régir le développement de normes propriétaires, ce qui peut conduire à des cycles d’amélioration plus courts.
Terminologies
Un aspect commun à toutes les normes de données, quelle que soit leur application, est l’utilisation de terminologies communes. De nombreuses normes s’appuient sur des terminologies développées indépendamment. Les terminologies peuvent être plates ou ontologiques, spécifiques à un ou à quelques domaines ou plus générales, propriétaires ou ouvertes. En fonction de l’utilisation prévue de la norme et des ressources disponibles, la politique d’inclusion des terminologies dans une norme peut différer. Les normes conçues pour la continuité des soins peuvent autoriser l’utilisation de terminologies externes si elles sont disponibles pour toutes les parties fournissant des soins, tandis que les normes utilisées pour l’exploration de données peuvent limiter leur utilisation aux seules terminologies approuvées. Comme c’est le cas des normes de données, les terminologies bénéficient de communautés actives pour les maintenir à jour. Comme le montrent les différents critères de conception, un système de santé véritablement interopérable et agile qui fournit les meilleurs soins cliniques possibles met en œuvre plusieurs normes. Par exemple, les dossiers standard d’un référentiel d’antécédents médicaux complets peuvent être transformés en une norme pour la transmission et transformés à nouveau lorsqu’ils sont saisis dans un entrepôt de données pour analyse. Une harmonisation systématique entre les normes réduirait ou éliminerait la perte d’informations dans les processus de transformation .
Standards émergents
Paradoxe de l’interopérabilité
L’un des paradoxes de l’interopérabilité des soins de santé est l’existence d’un grand nombre de normes qui se chevauchent considérablement. Chacune d’entre elles peut être plus ou moins adaptée à l’usage auquel elle est destinée, de sorte qu’il peut être difficile de sélectionner une norme à mettre en œuvre. L’harmonisation de toutes les normes avec toutes les autres est peu pratique. Le paradoxe de l’interopérabilité est que plus il y a de normes, plus l’interopérabilité est faible. Nous (les auteurs: ndlr) proposons donc que la communauté de l’informatique médicale converge vers trois normes seulement. Nous avons choisi des normes ouvertes, soutenues par des communautés actives et qui ont été testées et éprouvées dans leurs domaines respectifs.
openEHR pour les soins cliniques et l’administration:
openEHR fournit une structure de données commune pour les systèmes informatiques de santé, y compris, mais sans s’y limiter, les dossiers médicaux électroniques et les systèmes d’administration des patients. La norme utilise une base de données centralisée avec une structure arborescente pour une récupération efficace d’un dossier patient complet. Le schéma de la base de données est centré sur le patient, clinique et extensible avec des archétypes et des modèles réutilisables. openEHR est de plus en plus préféré aux formats propriétaires, car plusieurs fournisseurs qui proposent des systèmes commerciaux basés sur openEHR signifient qu’un processus très coûteux de changement de fournisseur peut être grandement simplifié.
FHIR pour l’échange de données:
Les ressources d’interopérabilité rapide des soins de santé (FHIR) de Health Level 7 (HL7) constituent une norme ouverte particulièrement adaptée au transfert de données. Au cœur de la spécification FHIR se trouve une interface de programmation d’application (API) de transfert d’état représentatif (RESTful) qui fournit des services de soins de santé réels tels que « enregistrer les détails du patient », « prescrire un médicament », « suggérer le traitement approprié pour un patient » et « prendre rendez-vous avec votre médecin ». Sa structure de ressources ne contient que des informations pertinentes pour un appel d’API particulier afin qu’elles puissent être transmises efficacement. Des ensembles de données minimaux spécifiques de FHIR (appelés cœurs) sont requis aux États-Unis, d’autres pays élaborant actuellement des exigences de base supplémentaires. L’utilisation de FHIR permet à différentes entités de ce pays de rationaliser la continuité des soins en échangeant des informations entre les systèmes et les organisations.
OMOP pour l’analyse longitudinale:
Les exigences de chaque norme de données ne permettant pas de remplacer les autres, des projets d’harmonisation sont menés par des bénévoles de la communauté afin de fournir des transformations standard d’une norme à une autre. Par exemple, la collaboration entre OHDSI et HL7 se manifeste par un groupe de travail commun qui organise des réunions hebdomadaires pour produire un guide de mise en œuvre des algorithmes qui convertissent les données de FHIR à OMOP et d’OMOP à FHIR. Des projets similaires visant à harmoniser openEHR avec OMOP et FHIR avec openEHR fournissent une architecture standard pour une interopérabilité et une réutilisation efficaces des données qui créeront un cercle vertueux de participation croissante de la communauté, d’amélioration des normes et de simplification de l’harmonisation. Ces groupes de bénévoles sont très bénéfiques, non seulement pour les normes auxquelles ils se consacrent, mais aussi pour les systèmes de santé du monde entier.
Quelle norme utiliser ?
La plupart des utilisateurs choisiront facilement si leurs besoins sont axés sur la prestation de soins opérationnels ou sur l’analyse et identifieront les systèmes concernés. La figure 1 fournit une clé, facilitant le choix entre openEHR, OMOP ou FHIR et l’investissement dans des processus d’extraction, de transformation et de chargement pour modifier les représentations de données de l’un à l’autre. Un système de santé interopérable utiliserait openEHR pour collecter des données, FHIR pour transmettre des données entre les systèmes et les organisations, et OMOP pour trouver des informations dans les données.
Figure 1. Alignement entre le domaine (cercle extérieur) et la norme ouverte (cercle intérieur). FHIR : ressources d’interopérabilité rapide des soins de santé ; OMOP : modèle de données commun du partenariat sur les résultats.
Il est possible que les transformations d’une norme à une autre soient « avec perte ». Par exemple :
La fidélité peut être perdue lors de la conversion d’un terme spécifique (par exemple, « fracture du quatrième métatarsien du pied gauche ») à un terme plus général (par exemple, « fracture du quatrième métatarsien »).
Des informations peuvent être perdues lorsque des informations capturées dans une norme (par exemple, l’heure à laquelle l’administration du médicament a été constatée dans FHIR) n’ont pas leur place dans une autre norme (par exemple, OMOP).
Les relations peuvent être perdues lorsque des informations doivent être séparées (par exemple, un diagnostic et un traitement ultérieur).
La précision peut être perdue lors de la conversion vers une norme qui nécessite des informations non trouvées dans l’autre (par exemple, l’heure à laquelle un médicament a été arrêté est requise pour chaque exposition dans OMOP et peut devoir être estimée chaque fois qu’elle n’est pas présente dans l’ensemble de données).
Il convient de veiller à minimiser ces pertes. Ces approches peuvent s’appuyer sur des connaissances tacites ou implicites concernant l’ensemble de données, des connaissances externes ou des métadonnées .
Conclusion
Les normes ouvertes, soutenues par des communautés engagées, présentent un avantage par rapport aux normes propriétaires. Elles permettent des contributions et des tests plus larges, favorisant ainsi une amélioration continue. Cependant, pour parvenir à une véritable interopérabilité, il faut harmoniser les normes et prévoir une voie de migration à partir d’autres normes et modèles propriétaires. Trois normes ouvertes sont particulièrement adaptées à leurs domaines de soins de santé respectifs : openEHR pour les soins cliniques et l’administration, FHIR pour l’échange de données et OMOP pour l’analyse longitudinale. L’aspect le plus important de chaque norme est sa communauté, et toutes trois disposent de communautés actives et en pleine croissance qui continuent d’utiliser et d’améliorer ces normes.
Les auteurs
Guy Tsafnat est fondateur et président d’Evidentli Pty Ltd, ainsi qu’éditeur associé du Journal of Medical Internet Research.
Rachel Dunscombe est directrice générale de openEHR International.
Grahame Grieve est fondateur de Health Intersections Pty Ltd.
Christian Reich est directeur général d’Odysseus Data Services.
Davera Gabriel est employée chez Evidentli et membre du comité consultatif scientifique d’Evidentli.
Abréviations
API : interface de programmation d’application
FHIR : ressources d’interopérabilité rapide des soins de santé
HL7 : Niveau de santé 7
OHDSI : Sciences et Informatique des Données Observationnelles en Santé
OMOP : Modèle commun de données du Partenariat pour les résultats
RESTful : transfert d’état représentatif
Pour aller plus loin
Lors du Health&Tech Summit, découvrez pourquoi l’interopérabilité sémantique est essentielle pour maximiser l’usage des données de santé. Participez à la session Track 2.4 – No meaningful data without semantic interoperability standards, le mercredi 18 décembre 2024, de 16h00 à 17h00.
Au programme :
L’interopérabilité est une composante clé pour :
Optimiser les résultats des soins cliniques.
Faciliter la continuité des soins entre les professionnels de santé.
Encourager les usages secondaires des données, comme la recherche et l’innovation.
Avec la participation de Stefan Schraps :
Stefan Schraps : Vice-président Business & Community Management chez Vitagroup et membre actif de openEHR International, Stefan partagera son expérience sur l’application des normes dans les systèmes de santé pour une gestion efficace des données.
Les autres intervenants :
🔹 Anne-Sophie Bouy (Numeum / Cegedim) – Experte en réglementation et présidente de la commission santé.
🔹 Diego Kaminker (HL7 International) – Responsable de la mise en œuvre des standards HL7, comme FHIR et CDA.
🔹 Anne Maheust (Interop’Santé / Use&Share) – Fondatrice de solutions facilitant l’interopérabilité des données dans l’écosystème de santé.
Pourquoi y participer ?
Découvrir les standards comme FHIR, CDA, et openEHR et leur rôle dans la transformation des systèmes de santé.
Comprendre comment les normes permettent une meilleure continuité des soins et une valorisation des données.
Échanger avec des experts sur des cas concrets d’interopérabilité.
🎯 Inscrivez-vous dès maintenant pour explorer l’avenir des données en santé : lien d’inscription.
Standardisation des données de santé : Défis, opportunités et typologie proposée
Dans leur article publié le 9 avril 2024 dans le Journal of Medical Internet Research (DOI : 10.2196/55779), Guy Tsafnat, Rachel Dunscombe, Davera Gabriel, Grahame Grieve et Christian Reich explorent les enjeux liés à l’interopérabilité des données en santé numérique. Constatant un écosystème fragmenté et des efforts d’interopérabilité souvent incohérents, les auteurs mettent en évidence les limites d’une prolifération de standards incompatibles. Ils proposent une typologie structurée des besoins en données de santé, articulée autour de trois domaines : les soins cliniques et l’administration, l’échange de données, et l’analyse longitudinale. Chaque domaine est examiné à travers ses caractéristiques propres et les défis qu’il pose, avec des recommandations de conception à la fois générales et spécifiques. L’article souligne l’importance stratégique des standards ouverts pour favoriser une collaboration plus efficace, réduire les inefficacités et garantir des soins de meilleure qualité, tout en s’adaptant aux besoins diversifiés des acteurs de la santé.
Trois domaines clés structurant les données de santé liés au besoin:
Le soin clinique et l’administration :
Les données de santé sont générées pour documenter la prestation de services cliniques à diverses fins, notamment la continuité des soins et la facturation. Un référentiel de dossiers médicaux contenant l’historique complet de chaque patient est nécessaire pour fournir des soins continus et cohérents de manière efficace et efficiente. Étant donné que les soins cliniques manquent parfois d’une base de données probantes solide à partir de laquelle les meilleures pratiques peuvent être glanées, la documentation des soins doit pouvoir traiter un large éventail de types de données, y compris les événements « ponctuels » reflétant des circonstances imprévues chez le patient .
L’objectif principal des normes d’interopérabilité des dossiers médicaux électroniques est de protéger les utilisateurs contre la dépendance vis-à-vis d’un fournisseur, dans laquelle le coût du changement vers un meilleur système dépasse les avantages attendus du changement. Un système de dossiers médicaux électroniques qui utilise une norme ouverte peut remplacer un autre qui utilise la même norme beaucoup plus facilement et avec moins de perturbations pour la pratique clinique que deux systèmes incompatibles où la transformation des données d’un système à l’autre représente la part du lion du coût.
L’échange de données :
Les dossiers médicaux sont utilisés dans la communication entre différents acteurs. Par exemple, la continuité des soins dépend du partage d’informations sur le patient par plusieurs prestataires de soins de santé, et une facturation efficace nécessite le partage d’informations entre prestataires et payeurs. Il est souvent essentiel que les informations soient transmises immédiatement entre les systèmes pour éclairer les décisions urgentes. Les normes de transmission des données de santé devraient pouvoir être organisées en petites quantités qui incluent toutes les informations pertinentes et uniquement celles-ci.
L’objectif principal des normes d’échange de données est la fidélité aux processus opérationnels de soins de santé. Par exemple, l’un des objectifs est de capturer et de représenter fidèlement la terminologie utilisée dans les processus locaux, quelle qu’elle soit, plutôt que de restreindre l’utilisation à une terminologie commune.
L’analyse longitudinale :
Le modèle commun de données (OMOP) du partenariat Observational Medical Outcomes Partnership (OHDSI) est une norme ouverte conçue pour l’interrogation longitudinale des dossiers cliniques. Son utilisation d’un modèle relationnel centré sur le patient le rend adapté aux requêtes complexes sur de nombreux dossiers de patients pour découvrir des modèles et des tendances à l’aide de techniques statistiques et d’apprentissage automatique.
Les exigences de chaque norme de données ne permettant pas de remplacer les autres, des projets d’harmonisation sont menés par des bénévoles de la communauté afin de fournir des transformations standard d’une norme à une autre. Par exemple, la collaboration entre OHDSI et HL7 se manifeste par un groupe de travail commun qui organise des réunions hebdomadaires pour produire un guide de mise en œuvre des algorithmes qui convertissent les données de FHIR à OMOP et d’OMOP à FHIR. Des projets similaires visant à harmoniser openEHR avec OMOP et FHIR avec openEHR fournissent une architecture standard pour une interopérabilité et une réutilisation efficaces des données qui créeront un cercle vertueux de participation croissante de la communauté, d’amélioration des normes et de simplification de l’harmonisation. Ces groupes de bénévoles sont très bénéfiques, non seulement pour les normes auxquelles ils se consacrent, mais aussi pour les systèmes de santé du monde entier.
Praticité, faisabilité et communauté
L’équilibre entre personnalisation et rigidité est un enjeu clé pour l’interopérabilité :
L’adéquation technique d’une norme au problème qu’elle traite est importante, mais la santé numérique et l’interopérabilité des données sont des disciplines appliquées. Les considérations pratiques et sociotechniques, telles que les compétences disponibles, sont aussi importantes, voire plus importantes, que la supériorité technique. Bien qu’aucune norme ne soit parfaite, il existe des différences majeures entre ce que les normes peuvent faire « prêtes à l’emploi » et le degré de personnalisation requis avant de pouvoir les utiliser. Pour assurer l’interopérabilité des données dans la pratique, les normes doivent trouver le bon équilibre entre personnalisation et rigidité. Les données de base pour l’interopérabilité des États-Unis sont un excellent exemple de cet équilibre . Ces définitions d’éléments de données de base sont réglementées pour une utilisation aux États-Unis et peuvent être considérées comme un point médian entre les personnalisations nécessaires à chaque site et la rigidité concernant des éléments de données spécifiques.
L’engagement communautaire , une clé de la durabilité et de l’évolution des normes :
Les normes de données ne sont utiles que dans la mesure où elles sont adoptées par les organisations collaboratrices. Les normes largement utilisées dans la communauté sont donc plus susceptibles d’être bénéfiques pour les organisations qui cherchent à rejoindre des réseaux de collaboration qui utilisent ces normes. L’engagement des communautés qui non seulement utilisent une norme, mais qui y contribuent également et l’améliorent au fil du temps, différencie les normes existantes des normes plus durables. Une communauté activement engagée fera évoluer, au fil du temps, même une norme infantile vers une norme supérieure. Une communauté engagée et dynamique constitue donc un avantage majeur pour la longévité des normes de données qu’elle utilise . Les normes ouvertes ont un net avantage sur les normes propriétaires, car elles sont disponibles pour la contribution d’un public plus large et sont testées dans des environnements plus divers. Inversement, il est généralement plus facile de régir le développement de normes propriétaires, ce qui peut conduire à des cycles d’amélioration plus courts.
L’harmonisation des terminologies : un pilier pour l’interopérabilité agile et efficace :
Un aspect commun à toutes les normes de données, quelle que soit leur application, est l’utilisation de terminologies communes. De nombreuses normes s’appuient sur des terminologies développées indépendamment. Les terminologies peuvent être plates ou ontologiques, spécifiques à un ou à quelques domaines ou plus générales, propriétaires ou ouvertes. En fonction de l’utilisation prévue de la norme et des ressources disponibles, la politique d’inclusion des terminologies dans une norme peut différer. Les normes conçues pour la continuité des soins peuvent autoriser l’utilisation de terminologies externes si elles sont disponibles pour toutes les parties fournissant des soins, tandis que les normes utilisées pour l’exploration de données peuvent limiter leur utilisation aux seules terminologies approuvées. Comme c’est le cas des normes de données, les terminologies bénéficient de communautés actives pour les maintenir à jour. Comme le montrent les différents critères de conception, un système de santé véritablement interopérable et agile qui fournit les meilleurs soins cliniques possibles met en œuvre plusieurs normes. Par exemple, les dossiers standard d’un référentiel d’antécédents médicaux complets peuvent être transformés en une norme pour la transmission et transformés à nouveau lorsqu’ils sont saisis dans un entrepôt de données pour analyse. Une harmonisation systématique entre les normes réduirait ou éliminerait la perte d’informations dans les processus de transformation .
Les auteurs :
Guy Tsafnat est fondateur et président d’Evidentli Pty Ltd, ainsi qu’éditeur associé du Journal of Medical Internet Research.
Grahame Grieve est fondateur de Health Intersections Pty Ltd.
Christian Reich est directeur général d’Odysseus Data Services.
Davera Gabriel est employée chez Evidentli et membre du comité consultatif scientifique d’Evidentli.
Abréviations :
API : interface de programmation d’application
FHIR : ressources d’interopérabilité rapide des soins de santé
HL7 : Niveau de santé 7
OHDSI : Sciences et Informatique des Données Observationnelles en Santé
OMOP : Modèle commun de données du Partenariat pour les résultats
RESTful : transfert d’état représentatif
Pour aller plus loin
Lors du Health&Tech Summit, découvrez pourquoi l’interopérabilité sémantique est essentielle pour maximiser l’usage des données de santé. Participez à la session Track 2.4 – No meaningful data without semantic interoperability standards, le mercredi 18 décembre 2024, de 16h00 à 17h00.
Au programme :
L’interopérabilité est une composante clé pour :
Optimiser les résultats des soins cliniques.
Faciliter la continuité des soins entre les professionnels de santé.
Encourager les usages secondaires des données, comme la recherche et l’innovation.
Avec la participation de Stefan Schraps :
Stefan Schraps : Vice-président Business & Community Management chez Vitagroup et membre actif de openEHR International, Stefan partagera son expérience sur l’application des normes dans les systèmes de santé pour une gestion efficace des données.
Les autres intervenants :
🔹 Anne-Sophie Bouy (Numeum / Cegedim) – Experte en réglementation et présidente de la commission santé.
🔹 Diego Kaminker (HL7 International) – Responsable de la mise en œuvre des standards HL7, comme FHIR et CDA.
🔹 Anne Maheust (Interop’Santé / Use&Share) – Fondatrice de solutions facilitant l’interopérabilité des données dans l’écosystème de santé.
Pourquoi y participer ?
Découvrir les standards comme FHIR, CDA, et openEHR et leur rôle dans la transformation des systèmes de santé.
Comprendre comment les normes permettent une meilleure continuité des soins et une valorisation des données.
Échanger avec des experts sur des cas concrets d’interopérabilité.
🎯 Inscrivez-vous dès maintenant pour explorer l’avenir des données en santé : lien d’inscription.