Analyse

  • IA, financement et gouvernance : les deux modèles nord-américains de santé connectée

    États-Unis : profondeur de marché et logique de scale

    Le marché américain du digital health est déjà installé à grande échelle, avec une progression attendue à près de 266 Md$ à horizon 2035, portée par la généralisation des services numériques, la télésanté et l’IA clinique. La demande émane des grands systèmes de santé, des payeurs et des industriels technologiques, dans une logique de retour sur investissement mesuré en réduction de coûts, gestion du risque et optimisation des parcours.

    Les segments les plus dynamiques restent les plateformes logicielles et les services IA intégrés aux systèmes d’information existants (DME, outils de planification, analytique populationnelle). Pour un acteur qui cherche des volumes, le marché américain offre un terrain de déploiement à large échelle, mais impose de se positionner face à des géants technologiques et à une densité élevée de startups déjà financées.

    Canada : rattrapage numérique et arbitrage souveraineté / dépendance

    Au Canada, l’attractivité repose moins sur la taille immédiate du marché que sur un double mouvement : manque d’accès aux soins et volontarisme politique pour que la réponse passe par le numérique. La montée rapide du marché des smart hospitals, avec des investissements dans l’IoT hospitalier, l’IA embarquée et les plateformes cloud, illustre ce rattrapage en cours.

    La situation actuelle, fragmentation des systèmes, accès limité aux données de santé pour les citoyens et risque de captation de valeur par des fournisseurs étrangers, crée une fenêtre d’opportunité pour des solutions capables d’appuyer la continuité des soins, l’interopérabilité et la coordination clinique. Pour les entreprises, cela signifie un marché encore en structuration, où l’enjeu est autant d’accompagner la transformation du système que de vendre une solution clé en main.

    Budgets publics, capital et structuration des écosystèmes

    Les États-Unis s’appuient sur une profondeur budgétaire distribuée : budgets hospitaliers, contrats payeurs, financements industriels et capital-risque massif structurent un environnement où l’innovation se déploie à grande vitesse, mais sur un mode concurrentiel intense et fragmenté. L’enjeu pour les entreprises est de s’inscrire dans des chaînes de valeur existantes, avec des cycles de vente longs mais des volumes potentiels importants une fois l’ancrage établi.

    Au Canada, le Budget 2025 annonce une stratégie plus centralisée autour de l’IA, avec des enveloppes dédiées à l’infrastructure (cloud souverain, capacités de calcul), au capital innovation (mécanismes de capital‑croissance) et à la mesure de l’économie numérique. Ces orientations signalent un environnement où l’État cherche à piloter l’émergence d’un écosystème IA, en incitant les entreprises à investir dans des solutions alignées avec des objectifs de souveraineté des données et de création de valeur locale.

    Rôle des hubs IA et de la commande publique canadienne

    Les recommandations émises par les acteurs hospitaliers canadiens vont dans le sens d’une structuration du marché autour de hubs régionaux d’innovation et d’une entité pancanadienne dédiée à l’IA en santé. Pour les entreprises, cela dessine un futur paysage où :

    • l’évaluation, la validation clinique et l’achat des solutions IA seraient en partie mutualisés ;

    • la capacité à démontrer un impact sur les coûts et la qualité des soins deviendrait un prérequis à l’accès au marché ;

    • les technologies développées au Canada pourraient bénéficier de mécanismes de préférence ou de soutien spécifiques.

    La commande publique, si elle évolue dans ce sens, deviendra un levier concurrentiel déterminant : être référencé dans ces structures pourra conditionner l’accès aux établissements et aux budgets d’investissement. Les acteurs étrangers devront démontrer non seulement leur performance technologique, mais aussi leur contribution à la souveraineté numérique et au développement de capacités locales.

    Arbitrages stratégiques pour les entreprises en phase d’exploration

    Pour une entreprise qui sonde ces deux marchés, la lecture business intelligence conduit à des arbitrages clairs :

    • Les États-Unis conviennent à des acteurs cherchant une croissance rapide en volume, disposant de moyens commerciaux et d’intégration suffisants pour affronter un environnement concurrentiel dense.

    • Le Canada s’adresse plutôt à des entreprises prêtes à co‑construire avec le système de santé, à intégrer des exigences fortes de gouvernance des données et à s’inscrire dans des dispositifs publics (hubs, programmes nationaux, appels à projets).

    Dans les deux cas, l’alignement avec la trajectoire de transformation des systèmes, réduction des coûts, productivité clinique, résorption des délais d’accès, est un prérequis, mais le mode de capture de la valeur diffère : logique fortement orientée marché aux États-Unis, logique hybride marché / politique publique au Canada.

  • Quels KPI suivre pour piloter un projet IA de codage/RCM ?

    Performance IA (niveau modèle)

    • Metrics classiques de classification multiétiquettes : précision, rappel, F1 global et par code, avec distinction codes fréquents vs rares. 
    • Robustesse par souscatégorie (chapitres ICD, types d’actes), comme l’illustre l’étude GPT2 vs HAN détaillant les performances par bloc de la classification.  
    • Qualité des rationales de codage et taux de cohérence avec les rationales expertes lorsque cette dimension est évaluée. 

    KPI de cas d’usage (productivité, qualité, flux)

    • Productivité : temps de codage par séjour, nombre de séjours codés par ETP et par jour, réduction du backlog, part des séjours codés automatiquement ou semiautomatiquement. 
    • Qualité de codage : taux d’erreurs détectées en audit, exhaustivité des codes secondaires, taux de révisions après contrôle DIM, stabilité du CMI dans le temps. 
    • Flux RCM : taux de dossiers “dischargednotfinalbilled”, délais entre sortie et facturation, taux de rejets payeurs liés au codage, taux de firstpass yield. 

    KPI d’impact financier et RH

    • Impact financier direct : variation du revenu net par séjour, gain de CMI, réduction des pertes liées aux rejets et aux souscodages, ROI global (temps de retour sur investissement). 
    • Impact RH : réduction de la charge répétitive pour les codeurs, évolution du mix de compétences (plus d’analyse, moins de saisie), perception des équipes (acceptation, confiance). 

    Certains KPI sont largement universels (temps de codage, taux de rejets, F1 sur les codes principaux), ce qui permet des comparaisons entre pays. D’autres sont fortement contextuels, comme l’impact sur la valorisation PMSI/T2A en France ou les mécanismes spécifiques de partage de risque avec les payeurs dans les systèmes DRG nordaméricains ou nordiques. 

    Facteurs de risque et de succès : enseignements de l’observatoire 

    Même si les retours sont fragmentaires, les travaux récents sur l’IA en codage convergent vers plusieurs familles de facteurs. 

    Données 

    • Qualité, exhaustivité et structuration de la documentation clinique conditionnent directement la performance ; les modèles peinent sur les codes rares et les catégories peu représentées. 
    • Des cas illustrent comment des catégories avec très peu d’exemples d’entraînement (certains blocs ICD) restent mal performantes malgré de bons résultats globaux.  

    Technique 

    • Robustesse et explicabilité sont cruciales, surtout dans des contextes de financement et d’audit ; des travaux proposent des pipelines où des LLM vérifient et affinent des prédictions initiales pour améliorer la fiabilité. 
    • L’intégration SI (avec les logiciels de codage, les groupers, le DPI) est un déterminant clé d’adoption, davantage que la performance brute du modèle. 

    Clinique et organisationnelle 

    • Acceptabilité par les DIM et les codeurs dépend du positionnement de l’outil : les projets qui se construisent en coconception, avec des workflows centrés sur l’assistance et la priorisation, rencontrent moins de résistance que ceux qui visent un remplacement frontal. 
    • La charge cognitive et la gouvernance des corrections doivent être anticipées : qui a le dernier mot, comment les corrections humaines rétroalimentent les modèles, quelle traçabilité des décisions ? 

    Réglementaire et financière 

    • L’alignement avec les règles nationales (PMSI, DRG, exigences de documentation) et la capacité à produire des preuves auditables sont des prérequis, en particulier dans les environnements très régulés. 
    • Les modèles économiques doivent être compatibles avec les marges hospitalières et les modalités de financement ; les promesses de ROI (x5 sur l’investissement, plusieurs millions par an) affichées par certains acteurs doivent être examinées de manière critique et contextualisée. 

    En combinant ces éléments, on peut esquisser une matrice implicite : 

    • Lowrisk / highvalue : assistance au codage sur séjours simples, contrôle qualité a posteriori, priorisation des dossiers à vérifier. 
    • Highrisk / highvalue : optimisation DRG à fort enjeu financier, ajustements de codage en amont de la facturation, ajustement de CMI de niveau établissement. 
    • Highrisk / lowvalue : tentatives d’autocodage complet sans supervision sur cas complexes, surtout sans explicabilité ni cadre d’audit. 
    • Lowrisk / lowvalue : usages ponctuels type “chatbot codage” sans intégration SI. 

    Implications pour les acteurs  

    Pour les hôpitaux, DIM et directions 

    Les établissements ont intérêt à : 

    • Réaliser un diagnostic de maturité : niveau de structuration des données, pratiques actuelles de codage et de RCM, contraintes spécifiques (type de patients, multisites, GHT). 
    • Prioriser une feuille de route IA par cas d’usage : assistance au codage, contrôle qualité, prévention des rejets, en alignant les choix sur quelques KPI cibles (CMI, délais de facturation, taux de rejets, charge DIM). 
    • Encadrer les pilotes par une gouvernance claire (DIM, DSI, direction financière) et un protocole d’évaluation structuré (avant/après, groupe contrôle si possible, analyse des risques). 

    Pour les industriels et éditeurs 

    Les cas d’usage existants montrent que : 

    • Les hôpitaux attendent des solutions intégrées, interopérables avec leurs SI existants et adaptées aux spécificités nationales (PMSI, NordDRG, MSDRG, TwDRG). 
    • La différenciation se joue sur la capacité à démontrer un ROI crédible et mesuré (productivité, qualité, revenus), plutôt que sur l’originalité de l’algorithme seul. 
    • Des opportunités existent pour des offres de niche : établissements de taille moyenne, pays moins couverts, services d’audit indépendant de systèmes IA de codage pour régulateurs et payeurs. 

    Pour les régulateurs et payeurs 

    Les régulateurs peuvent utiliser l’IA : 

    • Pour améliorer la qualité des données de codage et la comparabilité interétablissement, via des outils de détection d’anomalies et de souscodage mis à disposition des DIM. 
    • Pour auditer les systèmes IA euxmêmes, en s’appuyant sur des benchmarks ouverts type NordDRG AI, et sur des cadres d’évaluation de robustesse et de fairness des LLM en codage. 
    • Pour encourager des modèles de financement qui valorisent la qualité du codage et la transparence des flux, plutôt que des mécanismes purement volumedriven. 
  • France : PMSI, DIM et premiers déploiements IA

    Les DIM jouent un rôle central : pilotage du codage, contrôles qualité, gestion des atypies et lien avec la direction financière, dans un contexte de tension sur les ressources médicales et de montée des exigences de qualité des données. 

    Le débat sur l’usage des LLM généralistes pour le PMSI illustre bien les tensions actuelles : certains tests exploratoires montrent des capacités pédagogiques et d’aide ponctuelle au codage, mais jugent ces outils encore très loin d’un usage opérationnel sécurisé pour du codage semi automatisé. 

    Solutions de marché et initiatives observées 

    Plusieurs acteurs français positionnent des solutions IA autour du PMSI : 

    • Outils comme Cod+, issus de la consolidation de plusieurs éditeurs, proposent un environnement intégré de codage PMSI par IA, couvrant primocodage enrichi (DP, DR, DAS), listes de travail, contrôles qualité et suivi de performance, avec interopérabilité SIH. 
    • Des démonstrations récentes (par exemple l’interaction entre un front PMSI et une IA de type SANCARE ou équivalent) visent à automatiser partiellement le codage des séjours simples, à générer des alertes sur les atypies et à recentrer les médecins DIM sur les cas complexes et l’analyse stratégique. 
    • En dehors du codage strict, différentes initiatives explorent l’usage de l’IA pour requêtes PMSI complexes, aide à la recherche clinique, ou détection de profils de séjours atypiques, permettant d’orienter les efforts de recodage ou d’audit. 

    Les retours d’expérience détaillés restent encore peu publiés, souvent limités à des webinaires ou communications industrielles, ce qui réduit la visibilité sur les impacts quantifiés dans le contexte français. 

    KPI observés, freins et opportunités 

    Les KPI mis en avant par les solutions centrées PMSI incluent : 

    • Gain de temps par séjour codé, réduction du backlog, réallocation du temps DIM vers des tâches analytiques. 
    • Amélioration de la qualité et de l’exhaustivité du codage (réduction des erreurs, détection de souscodage), avec impact attendu sur le CMI et la valorisation T2A. 
    • Capacité à suivre des plans d’assurance qualité PMSI, via des modules dédiés et des tableaux de bord intégrés. 

    Les freins majeurs identifiés : 

    • Acceptabilité des médecins et TIM, préoccupés par le risque de “boîte noire” et la perte de maîtrise du codage, d’autant plus que les sanctions en cas d’erreurs peuvent être significatives. 
    • Contraintes réglementaires françaises (cadre PMSI, contrôles externes, évolutions annuelles des règles) qui exigent des solutions constamment mises à jour et auditables, ce qui favorise une approche conservatrice. 
    • Qualité et hétérogénéité des données sources, notamment lorsque la documentation clinique reste partiellement structurée ou saisie sous forme narrative non standardisée. 

    Les opportunités restent néanmoins fortes, notamment dans les GHT et réseaux hospitaliers qui cherchent à harmoniser les pratiques de codage et à mutualiser les ressources DIM. (Voir Retex CH de Troyes, Peer Review CH).


  • Codage médical par IA : 5 solutions en France

    Le codage médical, indispensable à la facturation, au suivi épidémiologique et à l’analyse de performance, représente un poste administratif important pour les établissements de santé. En France, il mobilise des milliers de médecins et de techniciens d’information médicale (TIM).  L’intelligence artificielle promet de bouleverser ces processus, avec des gains de temps pouvant atteindre 50 à 70% et des revalorisations financières qui se chiffrent en millions. Cet article passe en revue les principales solutions d’IA utilisées en France appliquées au codage médical, leur technologie, leurs résultats chiffrés et leurs déploiements hospitaliers. 

    Codage Médical (Parallel) : L’agent IA qui « clique » à la place du TIM 

    Parallel, startup française (ex-Kiosk Medical), développe un agent IA qui automatise le codage médical PMSI ( Programme de médicalisation des systèmes d’information) de bout en bout. L’agent lit l’intégralité du dossier médical, identifie les diagnostics et actes correspondants, puis saisit les codes directement dans le logiciel PMSI de l’établissement.

    L’originalité de Parallel réside dans son approche « Computer Use » : les agents IA interagissent avec les logiciels hospitaliers comme des humains ils naviguent entre les écrans, cliquent sur les boutons et remplissent les champs. Cette approche contourne le problème des systèmes informatiques hospitaliers obsolètes et dépourvus d’API performantes. 

    LLM et IA générative

    Parallel s’appuie sur les grands modèles de langage (LLM) et l’IA générative pour structurer l’information médicale (radios, opérations, consultations). L’approche « Computer Use » utilise des modèles multimodaux capables de « voir » l’écran et d’interagir avec l’interface graphique des logiciels existants.

    Une solution utilisée par le GHICL

    L’entreprise a effectué son premier déploiement au GHICL (Groupement des hôpitaux de l’Institut Catholique de Lille), avec le Dr Louis Rousselet, chef du département d’information médicale. La startup est en phase de recrutement de TIM pour des prestations de codage MCO (Médecine, Chirurgie, Obstétrique et Odontologie ).

    3,5 millions d’euros levés en 2025

    Parallel ne publie pas encore de chiffres de ROI, la solution étant en phase de déploiement initial. La startup a levé 3,5 M d’euros en amorçage en avril 2025.


    Sclépios IA : La cotation des urgences par les urgentistes 

    Sclépios IA, créée par le Dr Andréï Galindo (urgentiste) et Jonathan Coviaux, propose Pulsar IA, une extension logicielle intégrée au DPI existant qui optimise la gestion hospitalière aux urgences et en hospitalisation. La solution automatise la rédaction des comptes rendus médicaux, insère les bons mots-clés PMSI et optimise la cotation des actes. Elle propose également des fonctionnalités complémentaires : aide au tri IOA (infirmier Organisateur de l’Accueil), dictée vocale, import automatique de données et OCR (Reconnaissance Optique de Caractères) d’ordonnances. 

    Un LLM pour optimiser la cotation

    Sclépios IA utilise des technologies basées sur les LLM (grands modèles de langage) pour l’analyse de données médicales, la génération de recommandations personnalisées et l’optimisation de la cotation. 

    Une surcouche du DPI

    Pulsar IA est conçue comme une surcouche du DPI existant, sans nécessiter de changement de logiciel. C’est une extension qui s’ajoute au système en place. 

    Une solution déjà déployées à la Polyclinique de la Clarence à Divion

    Premier déploiement à la Polyclinique de la Clarence à Divion (Groupe AHNAC). Discussions en cours avec l’Hôpital Foch, ainsi qu’une trentaine de structures de soins représentant près de 2 millions de séjours aux urgences annuels. 

    Gains chiffrés revendiqués 

    • Jusqu’à 100 € supplémentaires facturés par passage patient aux urgences 
    • Prévention d’indus pouvant atteindre plusieurs millions d’euros en SMR 
    • Tarification SaaS basée sur le nombre de séjours aux urgences et en hospitalisation 


    Sancare : Le machine learning probabiliste au service du DIM 

    Sancare est un logiciel d’aide au codage des séjours hospitaliers destiné aux DIM. Il automatise une partie du codage pour les cas à haut niveau de confiance et propose des suggestions de revalorisation pour les séjours potentiellement sous-codés. L’ensemble du processus est tracé pour faciliter les contrôles externes. 

    Machine Learning et NLP

    Le moteur de Sancare repose sur le machine learning probabiliste et le NLP. L’algorithme apprend à prédire les bons codes à partir de gros volumes de données du DPI (comptes rendus, notes médicales, résultats d’examens, prescriptions, dossier infirmier), sans aucune indication préalable. Il extrait une « empreinte » riche en informations, adaptée à l’interprétation statistique, qu’il sait relier aux codes avec un fort taux de fiabilité.

    Un partenariat avec Dedalus

    Sancare travaille au sein du système d’informations de l’établissement, sans transfert de données à l’extérieur. Un partenariat stratégique avec Dedalus (leader des solutions PMSI en France, 400 établissements) a été annoncé en janvier 2025 pour une intégration directe dans l’environnement PMSI Dedalus. 

    Sancare se positionne comme leader en France des outils d’aide au codage par IA et équipe des établissements MCO et SMR. Via le partenariat avec Dedalus, la cible atteint près de 400 établissements publics, privés et ESPIC. 

    Gains chiffrés revendiqués 

    Sancare vise une économie de 0,5% des dépenses des établissements de santé, par l’automatisation et la réduction des oublis de facturation. Pour les hôpitaux français représentant un marché total de 70 milliards d’euros (public et privé), ce potentiel est significatif. 

    Un jugement de redressement judiciaire a été prononcé en décembre 2025 par le tribunal de commerce d’Évry. Un redressement judiciaire peux avoir plusieurs causes différentes, et n’est pas systématiquement synonyme de faillite à venir, mais reste malgré tout un signe de difficultées financières. 


    Cod+ (Ospi)  

    Cod+ est la solution intégrée d’Ospi dédiée au codage PMSI (Programme de Médicalisation des Systèmes d’Information) par intelligence artificielle, lancée en 2024. Elle réunit les fonctionnalités historiques de PMSIpilot (analyse PMSI) et d’Intelligence for Health (IA de codage développée par Collective Thinking). Cod+ couvre l’intégralité de la chaîne PMSI en MCO et SMR (Service Médical Rendu) : primo-codage enrichi des diagnostics principaux (DP), diagnostics reliés (DR) et diagnostics associés significatifs (DAS), plus de 800 règles de contrôle qualité, un module dédié au plan d’assurance qualité (CAC), et des listes de travail prédéfinies. 

    La solution propose trois modes de fonctionnement selon la complexité du séjour : 

    • Automatisation complète des séjours simples (< 3 nuits : cataractes, syndrome du canal carpien). Revendication :  <99% de précision. 
    • Automatisation supervisée des séjours intermédiaires (fractures fermées, etc.)  Revendication : 85% de précision 
    • Assistance au codage pour les séjours complexes (> 3 nuits) Revendication :  précision < 80%, temps gagné ~40% 

    Un NLP dévellopé par Collective Thinking

    Ospi s’appuie sur des technologies avancées de NLP (traitement automatique du langage naturel) développées par Collective Thinking, société d’IA spécialisée dans le traitement de données de santé textuelles et structurées. La plateforme embarque une dizaine d’intelligences artificielles dédiées, capables d’analyser les données hétérogènes du dossier patient (comptes rendus, notes médicales, résultats d’examens) pour en extraire les codes PMSI pertinents. 

    Un partenariat avec Berger-Levrault

    Cod+ est décrite comme « totalement interopérable avec le système d’information hospitalier ». Un partenariat stratégique avec Berger-Levrault (éditeur majeur de DPI et GAP pour le privé) a été signé en mars 2025 pour garantir une intégration native dans l’environnement DPI/GAP des cliniques privées. 

    Plus de 200 établissements

    Ospi est déployé dans plus de 1 100 hôpitaux publics, 80% des GHT et CHU, et plus de 100 hôpitaux privés en France. Cod+ comptait plus de 200 établissements déployés début 2025. Parmi les références citées : le CH de Rambouillet (Dr Nicolas Halys), le CH de Haute-Marne (Dr Nicolas Petit), le Groupe Hospi Grand Ouest (Dr Georges Legrand) et le CHI de Créteil (Dr Mathilde Rousseau). 

    Gains chiffrés revendiqués 

    • 46% de gain de temps au codage par dossier 
    • 50% d’automatisation sur les séjours simples 
    • 2,4 M€ revalorisés en 3 semaines pour un CHU utilisateur 
    • Gain moyen de 1 500 € par séjour revalorisé 
    • 30% de gain financier sur les séjours revalorisés.


    Medicode (Kaduceo)  

    Medicode automatise le codage de l’activité hospitalière à partir des comptes rendus médicaux et des lettres de sortie. La solution identifie les diagnostics et les procédures dans le texte clinique, puis propose les codes correspondants accompagnés d’un score de fiabilité permettant au praticien de garder le contrôle. 

    Medicode fait partie d’un triptyque de solutions Kaduceo : QualiLdS (vérification qualité des lettres de sortie), SynthEZ (génération de comptes rendus synthétiques) et Medicode (codage). 

    IA générative et NLP

    Kaduceo utilise l’IA générative et le NLP pour analyser les textes médicaux. La technologie est qualifiée de 100% française et souveraine, avec un hébergement conforme aux exigences de sécurité du secteur de la santé. Matthieu Ortala, CEO de Kaduceo, décrit l’approche comme une automatisation et fiabilisation des tâches obligatoires et répétitives par IA.

    Une solution Saas

    Medicode est disponible en mode SaaS ou interopérable via des connecteurs HL7. L’API s’implémente « en quelques minutes » selon l’éditeur. La solution est également disponible en marque blanche. 

    4 établissements pionniers

    Quatre établissements pionniers : la Clinique Pasteur de Toulouse et le CHI de Créteil sont les principaux cités. 

    Solutions et des cas d’usage de l’IA en codage médical

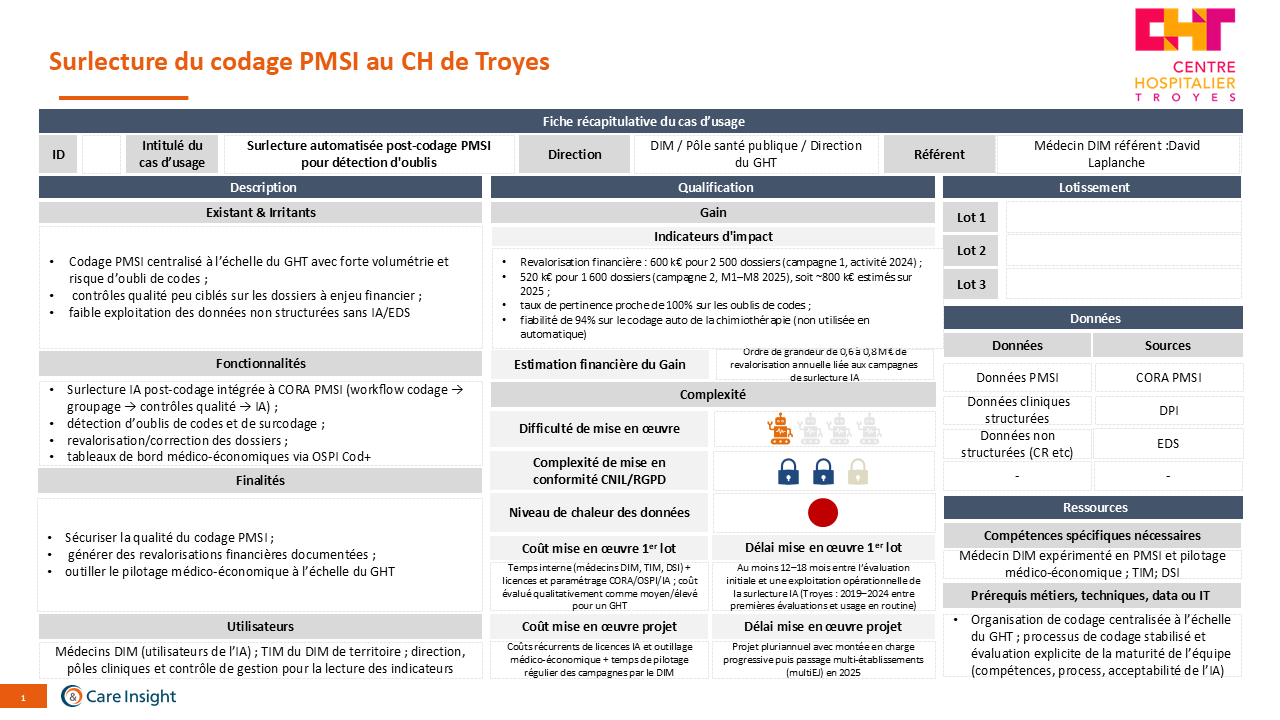
  • RETEX Établissement : Centre Hospitalier de Troyes

    @Health&Tech Intelligence – Retex CH de Troyes

    Établissement : Centre Hospitalier de Troyes (GHT)
    Interlocuteur : David Laplanche
    Périmètre : IA codage PMSI, OSPI Cod+, exploitation de données structurées et non structurées
    Maturité : Usage en routine depuis 2024, passage multiEJ en 2025 

    Idées clés 

    • Un modèle organisationnel centralisé (10 techniciens d’information médicale, équipe pluridisciplinaire, couverture Groupement Hospitalier de Territoire complète) constitue un prérequis à l’intégration réussie de l’IA dans le codage.
    • L’IA est utilisée en surlecture postcodage, non en codage automatique, y compris sur les actes répétitifs : le taux d’erreur de 6% sur la chimiothérapie est jugé trop élevé pour basculer en automatisation, malgré un potentiel de gain majeur ( Hôpital De Jour, actes standardisés).
    • OSPI Cod+ dépasse le rôle de simple outil de codage pour devenir une brique de comptabilité analytique, de contrôle qualité et de pilotage médicoéconomique à l’échelle du GHT.
    • La 1ʳᵉ campagne de revalorisation (janvier 2025, sur l’année 2024) a généré 600 k€ sur 2 500 dossiers ; la 2ᵉ campagne (fin sept. 2025, M1–M8 2025) a produit 520 k€ sur 1 600 dossiers, 800 k€ estimé sur 2025.

    Fiche d’identité du cas d’usage 

    Champ  Détail 
    ID Observatoire  À attribuer (interne)  
    Année de déploiement  2024 (routine), 2025 (multiEJ) 
    Pays  France 
    Type d’établissement  CH public, tête de GHT 
    Niveau de soins  MCO toutes spécialités (hors chirurgie cardiaque → CHU), psychiatrie 
    Domaine  Codage PMSI, contrôle qualité, comptabilité analytique 
    Solutions utilisées  CORA PMSI (codage/groupage), OSPI Cod+ (analytique/contrôle), PSIH (historique DIM), AIR (indicateurs), EDS (données non structurées), DXCare/ passage HM/Softway en cours dans le GHT 
    Type d’IA  IA de surlecture intégrée à CORA (initialement I4H, puis COD+) 
    Objectif principal  Sécurisation du codage, détection d’oublis 
    Métriques clés  600 k€ / 2 500 dossiers (campagne 1) ; 520 k€ / 1 600 dossiers (campagne 2)  
    Maturité  Déploiement multisites avec impact chiffré 

    Contexte organisationnel 

    Équipe et gouvernance 

    Le CH de Troyes a structuré un pôle de santé publique intégrant recherche clinique (4 assistants de recherche clinique, dont 1 data scientist), archives médicales et coordination ville/hôpital. Le Département d’Information Médicale a été mutualisé sur le territoire dès 2013, puis renforcé par étapes :

    • 2015 : direction commune et création du DIM de territoire.
    • 2016 : outil unique de codage et solution de suivi médicoéconomique.
    • 2019 : premières utilisations de données de santé (COCOC) et premiers outils d’IA.
    • 2020 : initiation de l’entrepôt de données de santé (EHOP).
    • 2024 : utilisation de l’IA en routine.
    • 2025 : passage en multiEJ pour les outils de codage et de pilotage.

    L’équipe opérationnelle se compose d’environ 10 TIM, 1 à 2 infirmières d’Assistance aux Malades en Ambulatoire. 1 sagefemme et 1 datamanager. Le codage est centralisé pour toutes les spécialités du GHT, organisé à la séquence de soins ou au séjour complet, couvrant toutes les Unité Médicale traversées par le patient. Chaque TIM suit les patients sur l’ensemble de leur parcours et se voit affecter des séjours de manière aléatoire, assurant une répartition équitable et un contrôle qualité homogène.

    Socle d’outils 

    Outil  Fonction 
    CORA PMSI  Codage, groupage, contrôle qualité — version multientités juridiques 
    OSPI Cod+  Comptabilité analytique, contrôle qualité complémentaire, pilotage médicoéconomique 
    PSIH  Historique DIM, analyses rétrospectives pluriannuelles 
    AIR / DIM Package  Production automatisée d’indicateurs, alimentation BI 
    EDS (EHOP)  Accès aux données non structurées (comptes rendus, notes médicales, transmissions) 
    DXCare / HM / Softway  DPI et sources cliniques (dont psychiatrie) 

    Parcours d’adoption de l’IA codage 

    Phase d’évaluation (2019–2022) 

    Dès 2019, l’établissement reçoit les premières sollicitations d’éditeurs. En 2022, un comparatif sur M1 oppose deux solutions d’IA — Sancare et Collective Thinking. Le constat est que peu de différences de revalorisation moyenne existent entre les deux, mais que le ciblage des dossiers diffère (environ 300 € en moyenne par dossier ouvert, 15% des dossiers modifiés). Le choix se porte sur la solution la mieux intégrée à CORA PMSI, critère déterminant pour l’équipe de codage.

    Phase de test (2022–2024) 

    Pendant deux ans, l’équipe constate une instabilité de la solution et une intégration perfectible. Elle engage une réflexion sur le process d’utilisation de l’IA en définissant un workflow séquentiel strict :

    CODAGE → GROUPAGE → CONTRÔLES QUALITÉ → TEST IA 

    Ce positionnement de l’IA en bout de chaîne traduit une réticence assumée à recevoir les propositions IA directement en phase de codage. L’IA est conçue comme une étape de complément, pas comme un codage automatique : la preuve est historisée et traçable.

    Phase de routine (2024–2025) 

    En 2024, l’établissement adopte l’outil médicoéconomique OSPI au niveau GHT et bascule la solution d’IA d’I4H vers COD+. Les résultats sont tangibles :

    Campagne  Période couverte  Dossiers traités  Revalorisation 
    1ʳᵉ campagne (janv. 2025)  Année 2024  2 500  600 k€ 
    2ᵉ campagne (sept. 2025)  M1–M8 2025  1 600  520 k€ 

    La réflexion porte désormais sur la fréquence d’utilisation (mensuelle vs trimestrielle) et sur la stabilisation des paramétrages et règles.

    Analyse des usages IA et de leur acceptabilité 

    Surlecture et détection d’oublis 

    L’IA est utilisée par les médecins DIM en fin de codage (jamais par les TIM directement). Les propositions sont transmises mensuellement. Sur les oublis de codes, le taux de pertinence est jugé très élevé : quand le dossier est repris, “l’IA a raison dans quasiment 100% des cas aujourd’hui”. L’IA sécurise le codage dans son ensemble, y compris parfois avec une valorisation négative (correction d’erreurs de surcodage), ce qui renforce la crédibilité de l’outil.

    Changement de diagnostic principal 

    Les propositions de modification du diagnostic principal sont en revanche peu testées et jugées peu fiables, générant du bruit. Ce point constitue une limite fonctionnelle claire de l’IA actuelle dans cet établissement.

    Codage automatisé : un potentiel majeur encore bloqué par le taux d’erreur 

    Sur les actes de chimiothérapie, l’IA atteint 94% de fiabilité sur environ 1 000 actes par mois. Bien que ce volume rende la saisie manuelle très lourde, l’établissement considère que 6% d’erreur sur 1 000 dossiers reste trop élevé pour basculer en codage automatique. Le risque d’erreurs en cascade, la nécessité de retraitement et les enjeux de fiabilité des données PMSI rendent cette marge inacceptable en l’état.

    Ce constat est d’autant plus significatif que le potentiel de gain serait majeur : les activités d’hôpital de jour (HDJ), la chimiothérapie et certains actes chirurgicaux standardisés (par exemple le canal carpien) représentent des segments à fort volume et forte répétitivité, idéalement éligibles à l’automatisation.

    En résumé : le codage automatisé est identifié comme un levier d’avenir, mais il reste aujourd’hui non utilisé au CH de Troyes. L’IA demeure strictement cantonnée à un rôle de surlecture et de détection d’anomalies. 

    Centralisation vs décentralisation : un enseignement clé 

    L’expérience de Troyes dégage un principe important : 

    • Organisation centralisée → l’IA est utilisée pour améliorer la qualité du codage (surlecture, détection d’oublis, sécurisation).
    • Organisation décentralisée → l’IA tend à être positionnée comme un outil financier pur (optimisation de valorisation), avec un risque accru de défiance médicale et de biais.

    Facteurs de succès et facteurs de risque 

    Facteurs de succès 

    Famille  Facteur  Illustration CH Troyes 
    Organisation  Centralisation du codage à l’échelle GHT  Toutes spécialités couvertes, suivi patient complet 
    Outillage  Intégration native IA–outil de codage  Choix de la solution intégrée à CORA comme critère premier 
    Process  Workflow séquentiel (codage → contrôle → IA)  Réticence assumée au codage IA direct, IA en “complément” 
    Gouvernance  Évaluation explicite de la maturité de l’équipe  Grille : compétences, process, acceptabilité, sécurisation recette 
    Données  EDS et accès aux données non structurées  Exploitation des comptes rendus, notes médicales, transmissions 
    Historisation  Traçabilité des preuves et des corrections  Chaque proposition IA documentée et archivée 

    Grille de KPI observés 

    Catégorie  KPI  Valeur observée  Commentaire 
    Impact financier  Revalorisation par campagne  600 k€ (2 500 doss.), 520 k€ (1 600 doss.)  Deux campagnes successives, tendance stable 
    Fiabilité IA  Taux de fiabilité codage auto chimio  94% (~1 000 actes/mois)  Jugé insuffisant pour basculer en automatique (6% d’erreur inacceptable) 
    Qualité  Taux de pertinence IA sur oublis  ~100% (estimation terrain)  Source : retour d’expérience 
    Qualité  Taux de pertinence IA sur changement Diagnostic Principal  Non mesuré (non testé)  Jugé peu fiable par les utilisateurs 
    Acceptabilité  Utilisateurs effectifs de l’IA  Médecins DIM uniquement  TIM ne sont plus impliqués  
    Fréquence  Rythme de transmission  Mensuel (100% des propositions)  Réflexion en cours sur passage trimestriel 

     Matrice maturité / valeur pour la cartographie HTI 

    Usage IA  Maturité  Valeur potentielle  Risque 
    Surlecture postcodage (oublis)  Élevée — routine  Élevée — sécurisation + revalorisation  Faible 
    Codage auto actes répétitifs (chimio, HDJ)  Faible — non utilisé (fiabilité insuffisante)  Très élevée — gain de productivité majeur si fiabilité atteinte  Élevé (6% d’erreur, risque en cascade) 
    Changement de diagnostic principal  Faible — non testé  Incertaine  Élevé (bruit, acceptabilité) 
    Comptabilité analytique via OSPI  Élevée — en place  Moyenne à élevée — pilotage GHT  Faible 
    Exploitation données non structurées (EDS)  Moyenne — en développement  Élevée — enrichissement du PMSI  Moyen (qualité des données, délais) 

    Ce RETEX a été formalisé par Health & Tech Intelligence (HTI) à partir d’un entretien avec David Laplanche (CH de Troyes). Les données chiffrées proviennent de communications de l’établissement.  

    Nota : Des outils d’IA ont été mobilisés pour la recherche documentaire et la structuration des informations, l’analyse et les conclusions restant du ressort des équipes Health&Tech intelligence et de relecteurs DIM. 

  • Cartographie des cas d’usage IA en codage médical : benchmark international

    Cette cartographie structurée recense les cas d’usage documentés de l’intelligence artificielle appliquée au codage médico-administratif et au revenue cycle management (RCM), issus de la revue de littérature internationale et des retours d’expérience identifiés depuis 2023. Cette analyse a été complétée et revue par deux médecins DIM français de CH, utilisateur et non utilisateur de solutions d’IA dédiée.  

    Le périmètre couvre la France, l’Europe (pays nordiques, Grèce), l’Amérique du Nord (États-Unis) et l’Asie (Taïwan), avec un focus sur les systèmes DRG-like : PMSI/CIM-10 FR, NordDRG, MS-DRG, Tw-DRG et G-DRG.   

    Analyse par famille de cas d’usage 

    Codage automatique / assisté ICD-10 

    Ce segment concentre la majorité des publications académiques et industrielles. Les approches vont du deep learning multi-label (CUS-FR-001) aux LLM fine-tunés comme DRG-LLaMA (CUS-ROW-002) ou GPT-2 appliqué au Tw-DRG (CUS-ROW-001). Les performances mesurées convergent vers un constat : les modèles atteignent des F1 élevés sur les codes fréquents (>0,85 sur le top 50), mais restent perfectibles sur les codes rares et les cas complexes (F1 global autour de 0,67). Aucun de ces cas n’a encore basculé vers un autocodage complet sans supervision humaine.  

    Contrôle qualité et détection d’anomalies 

    En France, les cas CUS-FR-002 (Cod+) et CUS-FR-003 (CHU Grenoble) illustrent un positionnement centré sur la détection des oublis de codes, des CMA manquantes et de la sous-valorisation. Ce segment présente le meilleur ratio risque/valeur : le ROI est rapide, le risque clinique est limité et le pilotage par KPI est immédiat. Le RETEX du CH de Troyes confirme ce constat terrain : l’IA en surlecture post-codage atteint un taux de pertinence « de quasiment 100% » sur les oublis de codes.  

    Groupage DRG et raisonnement tarifaire 

    Le benchmark NordDRG AI (CUS-EU-001) propose une approche originale : encapsuler les tables de définition DRG et les workflows de mise à jour dans un cadre d’évaluation standardisé pour tester les LLM. Les résultats sont encore insuffisants pour une automatisation, mais l’outil est utile pour comparer des copilotes IA avant déploiement en production. En Grèce (CUS-EU-002), une plateforme numérique d’audit a permis un reclassement significatif de DRG vers des groupes plus rémunérateurs.  

    Revenue Cycle Management (RCM) 

    Le cas le plus mature est celui d’Auburn Community Hospital (CUS-ROW-003), où l’intégration de l’IA et du RPA au cycle de facturation a produit des résultats mesurables : –50% de dossiers DNFB (discharged-not-final-billed), +40% de productivité des codeurs et +4,6% de CMI. Ce type de déploiement reste spécifique au contexte américain multi-payeurs, mais les KPI sont transposables à la logique PMSI française.  

    Matrice de positionnement : maturité × valeur × risque 

    Le croisement des cas d’usage par niveau de maturité et profil de risque/valeur permet d’identifier les segments les plus actionnables pour un établissement français.  

    Segment  Cas d’usage illustratifs  Maturité  Valeur potentielle  Risque 
    Low-risk / High-value  Surlecture post-codage, détection d’oublis (CUS-FR-002, CH Troyes)  Élevée – routine  Élevée – sécurisation + revalorisation  Faible 
    High-risk / High-value  Optimisation DRG/RCM à fort enjeu financier (CUS-ROW-003)  Élevée – opérationnel (USA)  Très élevée – productivité + CMI  Moyen (contexte réglementaire) 
    Medium-risk / High-value  Autocodage séjours simples (CUS-FR-002 mode auto)  Moyenne – supervisé  Élevée – gain productivité majeur  Moyen (6% erreur = trop élevé en routine) 
    High-risk / Low-value  Autocodage complet sans supervision, cas complexes  Faible – non utilisé  Incertaine  Élevé (codes rares, explicabilité) 
    Low-risk / Low-value  Chatbot codage ponctuel, usage LLM généraliste  Faible  Faible  Faible 

    Le tableau ci-dessous synthétise les principaux KPI rapportés par zone, permettant une lecture comparative rapide.  

    KPI  France (PMSI)  Europe (NordDRG/G-DRG)  USA (MS-DRG/RCM)  Taïwan (Tw-DRG) 
    Gain de temps codage  ≈ 46%/dossier (Cod+)  Non quantifié publiquement  –30% charge manuelle  Non quantifié 
    Automatisation séjours simples  ≈ 50% (Cod+)  N/A  N/A  60–75% principal correct 
    Revalorisation financière  +1 500 €/séjour ciblé ; 600 k€/campagne (CH Troyes)  Reclassement DRG significatif (Grèce)  +4,6% CMI ; millions $/an  N/A 
    Réduction rejets / DNFB  Non mesuré (FR)  N/A  –50% DNFB ; –30–50% rejets ICD-10  N/A 
    Performance IA (F1)  Amélioré vs baselines (pas de chiffre standardisé)  Insuffisant pour auto (NordDRG AI)  Top-1 ≈ 67% (DRG-LLaMA)  F1 global ≈ 0,67 ; F1 top 50 >0,85 
    Productivité codeurs  Non standardisé  Non quantifié  +40% (Auburn)  Réduction charge attestée 

    Convergences internationales 

    Trois constats se dégagent de l’ensemble des cas d’usage, toutes zones confondues :  

    • L’IA performante en codage repose systématiquement sur une hybridation règles + modèles : aucun déploiement opérationnel ne fonctionne sans moteur de règles encadrant les prédictions des modèles IA.
    • Le positionnement en assistance plutôt qu’en remplacement est le dénominateur commun de tous les projets ayant franchi le stade du pilote : l’IA propose, l’humain valide.
    • Les KPI de productivité et de qualité (temps de codage, taux d’erreurs, DNFB) sont plus robustes et plus comparables entre pays que les KPI financiers, qui dépendent fortement du contexte tarifaire local.

    Spécificités françaises 

    Le contexte PMSI impose des contraintes qui expliquent un retard apparent de maturité par rapport aux États-Unis :  

    • L’évolution annuelle des règles PMSI (codes, groupage, PLFSS/ONDAM) exige des solutions capables de ré-entraînement régulier, ce qui alourdit le coût total de possession. 
    • Les contrôles externes (CAC, Assurance maladie) imposent une traçabilité documentée de chaque décision de codage, rendant l’autocodage pur plus risqué en France qu’aux États-Unis. 
    • L’absence d’intégration des solutions tierces dans le DPI reste un frein opérationnel majeur, confirmé par les retours DIM. 

    Zones blanches de la littérature 

    Plusieurs lacunes sont identifiées dans le paysage actuel des cas d’usage :  

    • Allemagne (G-DRG) : des initiatives émergent autour du codage assisté ICD-10/OPS, mais la littérature publique détaillée reste pauvre. 
    • Canada : cité dans le périmètre de l’étude mais aucun cas d’usage formalisé n’a été identifié à ce stade. 
    • KPI de ROI dynamique : aucun cas d’usage ne présente un suivi longitudinal du ROI intégrant l’érosion potentielle des gains dans un système à enveloppe contrainte. 

    Nota méthodologique 

    Les cas d’usage identifiés proviennent de la revue de littérature internationale structurée par Health&Tech Intelligence, couvrant articles scientifiques, études de cas hospitalières, livres blancs d’éditeurs et documents institutionnels depuis 2023. Les chiffres d’impact provenant de communications d’éditeurs sont signalés comme tels et doivent être interprétés avec prudence. Des outils d’IA ont été mobilisés pour la recherche documentaire et la structuration des informations ; l’analyse et les conclusions restent du ressort des équipes HTI et des relecteurs DIM. 

    ID  Pays / zone  Système de paiement  Type de cas d’usage IA  Impact / métriques saillants 
    CUS-FR-001  France  PMSI (CIM‑10 FR)  Codage automatique/assisté ICD‑10 à partir des textes médicaux français (modèles de deep learning multi‑label). arxiv   F1 multi‑label significativement amélioré vs baselines, surtout pour les codes fréquents ; étude encore algorithmique, sans KPI de temps ni revenus. arxiv  
    CUS-FR-002  France  PMSI MCO  Suite Cod+ (Ospi) – primo‑codage IA, contrôle qualité, optimisation valorisation PMSI. ospi   Gains annoncés : ≈ 46% de temps gagné par dossier, ≈ 50% d’automatisation sur séjours simples, +1500 € de gain par séjour ciblé, >800 règles diagnostics sévérité 1‑3. ospi  
    CUS-FR-003  France  PMSI  Outil CHU Grenoble (Easily + recherche textuelle/IA) pour optimisation PMSI (détection CMA, sous‑valorisation). craim   KPI internes : orientation plus ciblée des contrôles qualité, amélioration de l’identification des CMA ; pas (encore) de chiffres standardisés de temps ou de revenu dans la présentation. craim  
    CUS-FR-004  France  PMSI  Projets ATIH d’IA pour codage automatisé de certaines informations PMSI + enquête flash 2024 sur outils IA de codage diagnostics. atih.sante+3  ATIH signale des travaux en cours sur l’IA pour codage automatisé et lance une enquête flash pour mesurer performances des outils IA sur le marché ; pas d’impacts chiffrés publiés à ce stade. atih.sante+1 
    CUS-EU-001  Nordiques (multi‑pays)  NordDRG  Benchmark NordDRG AI pour LLM : capacités de raisonnement DRG à partir de cas tests, règles et catalogues ICD‑10/NCSP. arxiv   Mesure de la précision d’assignation DRG ; résultats encore insuffisants pour une automatisation, mais utiles pour comparer des copilotes IA avant déploiement. arxiv  
    CUS-EU-002  Grèce  DRG grec (G‑DRG‑like)  Plateforme numérique spécialisée pour fiabiliser le codage DRG dans le déploiement national (audit et correction de codage). pmc.ncbi.nlm.nih   Reclassement significatif d’un nombre de DRG vers des groupes plus rémunérateurs après audit ; augmentation potentielle substantielle du revenu hospitalier (montant exact dépend des hôpitaux). pmc.ncbi.nlm.nih  
    CUS-ROW-001  Taïwan  Tw‑DRG  Autocodage et assistant DIM (GPT‑2, HAN) pour ICD‑10‑CM et Tw‑DRG : suggestion de codes, principal, MDC, intégration workflow. jmir   F1 global ≈ 0,67, F1 main code ≈ 0,58–0,62, ≈ 60–75% de séjours avec principal correct, κ MDC jusqu’à >0,81 pour certaines MDC ; déploiement local intégré au flux DIM. jmir  
    CUS-ROW-002  États‑Unis  MS‑DRG  DRG‑LLaMA : prédiction automatisée MS‑DRG à partir des notes (MIMIC‑IV). pmc.ncbi.nlm.nih   Amélioration relative ≈ +35–40% macro‑F1 vs modèles antérieurs ; top‑1 accuracy ≈ 67% pour DRG base et CC/MCC ; preuve de concept, pas de KPI de productivité. pmc.ncbi.nlm.nih  
    CUS-ROW-003  États‑Unis  MS‑DRG, RCM  Plateformes RCM avec IA (Auburn Community Hospital) : codage, DNFB, CMI. aha   –50% dossiers DNFB, +40% productivité des codeurs, +4,6% de CMI après intégration IA/RPA pour codage et cycle de facturation. aha 

    En Europe, les systèmes DRGlike sont largement répandus, mais avec des déclinaisons nationales (NordDRG, GDRG en Allemagne, groupes DRG nationaux en Grèce, pays d’Europe centrale, etc.), chacune avec ses règles et sa gouvernance. Le benchmark NordDRG AI illustre une approche structurée : il expose les tables de définition DRG et les workflows de mise à jour, et propose une suite de tests pour évaluer la capacité des LLM à suivre ces règles, avec une forte insistance sur la transparence et la reproductibilité. 

    Dans les pays nordiques, la combinaison d’un casemix partagé (NordDRG), de données hospitalières très structurées et d’une culture de benchmarking facilite les expérimentations IA sur le groupage, le contrôle qualité et l’analyse de coûts. L’IA est utilisée pour tester la robustesse du groupage, identifier des cas limites, et simuler l’impact de modifications tarifaires. Dans d’autres pays (Allemagne, Grèce, etc.), des initiatives émergent autour du codage assisté ICD10/OPS et de la détection d’anomalies de facturation, mais la littérature publique détaillée reste moins riche que pour les ÉtatsUnis ou les pays nordiques. 

    Comparée à la France, l’Europe “hors France” semble davantage centrée sur le DRG et la logique casemix comme objet principal de l’IA, là où la France reste concentrée sur la chaîne PMSI interne et les besoins spécifiques des DIM. Les différences de gouvernance (centralisée vs plus décentralisée) et de modèles de financement expliquent une partie de ces écarts. 

    ÉtatsUnis, Taïwan et autres pays : impacts financiers et opérationnels 

    ÉtatsUnis : RCM comme terrain d’élection 

    Aux ÉtatsUnis, le couple MSDRG / ICD10CM et un environnement de payeurs multiples font du RCM un terrain privilégié pour l’IA. Des solutions d’IA en codage et RCM rapportent : 

    • Réductions de 30–50% des rejets de codage ICD10 et des gains de 35% sur le taux de “firstpass yield”.  
    • Accélération de 25% des cycles de remboursement et baisse de 30% de la charge de travail manuelle des codeurs. 
    • Gains de revenu additionnel pouvant représenter 0,3–0,5 points de marge sur le chiffre d’affaires hospitalier, et plusieurs millions de dollars par an pour des systèmes multiétablissements. 

    Ces chiffres proviennent majoritairement de communications d’éditeurs et nécessitent prudence, mais ils indiquent un ordre de grandeur de l’impact potentiel lorsque l’IA est intimement intégrée au RCM (détection des risques de rejet, préscrubbing des demandes, recodage proactif). 

    Taïwan et TwDRG : étude structurée d’un système NLPdriven 

    L’étude de 2024 sur un système NLPdriven d’assistance au codage ICD10CM dans le contexte TwDRG fournit une évaluation rigoureuse : 

    • Les modèles HAN et GPT2 sont comparés à des modèles de référence et au codage humain, avec GPT2 atteignant un F1 global autour de 0,67 et des F1 supérieurs à 0,85 sur les 50 codes les plus fréquents. 
    • L’outil permet de réduire la charge de travail des codeurs et d’accélérer l’assignation TwDRG, tout en restant loin d’un remplacement complet de l’humain, notamment sur les codes rares et les cas complexes.  

    Cette étude met en lumière l’importance d’évaluer à la fois la performance globale et la performance par catégorie de codes, et d’intégrer l’IA comme support plutôt que substitut complet. 

    Autres contextes 

    Dans d’autres pays, l’IA en codage apparaît souvent couplée à des initiatives plus larges de digitalisation hospitalière : 

    • Utilisation de l’IA pour améliorer la qualité du codage en vue de comparaisons internationales et d’études d’efficience, dans des systèmes DRG déjà matures. 
    • Intérêt croissant des régulateurs pour des outils permettant d’auditer les performances des LLM et de vérifier la conformité aux règles de groupage et de tarification. 

    Ces expériences peuvent servir de référence haute pour l’Europe et la France, sous réserve d’adapter les cas d’usage aux contraintes locales (règles de financement, gouvernance des données, acceptabilité des parties prenantes). 

    Typologie des solutions observées 

    On peut distinguer plusieurs familles de solutions sur la période récente : 

    • Autocodage et codage assisté ICD10 / ICD10CM / CIM10 à partir des comptes rendus et données cliniques, utilisant des architectures deep learning (CNN, RNN, Transformers) et désormais des LLM généralistes ou spécialisés. 
    • Outils d’aide au codage pour les équipes DIM : suggestions de codes, listes de travail priorisées, contrôle qualité (détection d’atypies, codes incohérents, manques), souvent intégrés dans les plateformes PMSI ou les applications de codage. 
    • IA pour le groupage DRGlike : assistance au choix ou à la vérification du DRG, simulations d’impact de recodage, et plus récemment benchmarks type NordDRG AI pour tester la capacité des LLM à suivre la logique de groupers complets. 
    • Solutions RCM intégrées : moteurs d’IA appliqués au cycle de facturation, avec extraction sémantique des diagnostics/actes, détection de risques de rejet, prédiction des denials et workflows de correction avant émission de la facture. 

    Les cas d’usage couvrent ainsi la chaîne complète : de la production primaire du codage jusqu’à la valorisation financière et à la réduction des pertes de revenu. 

    Niveaux de maturité 

    Les niveaux de maturité varient : 

    • Preuves de concept académiques : essais d’autocodage sur bases anonymisées, souvent monocentriques, évaluant des modèles de deep learning ou de LLM sur des tâches ICD10/ICD10CM, avec des F1 globaux encore limités sur l’ensemble des codes, mais très honorables sur les codes fréquents. 
    • Pilotes intégrés dans 1–2 hôpitaux : par exemple, des systèmes NLPdriven d’assistance ICD10CM et TwDRG déployés dans des hôpitaux taïwanais, avec mesure de la charge de travail des codeurs, de la cohérence avec le codage humain et de la rapidité de traitement. 
    • Déploiements multisites et offres industrielles : solutions nordaméricaines et européennes intégrant IA de codage et RCM, avec claims de gains quantifiés sur les rejets, la productivité et le revenu net, parfois sur des réseaux hospitaliers complets. 

    La tendance majeure est le passage d’outils de codage “isolés” à des plateformes intégrées de revenue cycle, où l’IA est une couche transverse de détection, de recommandation et de contrôle. 

    Tendances technologiques 

    Trois évolutions technologiques se détachent : 

    • Montée en puissance des LLM spécialisés santé, capables de raisonner sur des combinaisons complexes de diagnostics et procédures et de générer des rationales de codage exploités pour la vérification et l’explicabilité. 
    • Intégration de l’IA dans les pipelines DRG : benchmarks comme NordDRG AI qui encapsulent les tables de définition DRG dans des cadres d’évaluation pour tester la capacité des modèles à reproduire une logique de groupage conforme aux règles nationales. 
    • Hybridation règles + IA : utilisation de moteurs de règles (editeurs/groupers) pour encadrer l’espace des codes possibles, l’IA venant proposer, prioriser et vérifier, plutôt que décider seule, ce qui est clé pour la conformité et l’audit. 

    Les différences de nomenclature/systèmes DRG par pays 

    Diversité des PMSI et nomenclatures : une même logique, des architectures radicalement différentes 

    Si tous les pays industrialisés partagent la même ambition fondatrice — mesurer l’activité médicale pour financer les établissements de santé et piloter les politiques de santé —, les systèmes mis en place divergent profondément dans leur architecture, leur granularité et leur histoire. La France constitue un cas particulier avec son PMSI, dispositif intégré et centralisé articulé autour de la CIM-10-FR (version enrichie d’extensions nationales par l’ATIH chaque année) pour les diagnostics et de la CCAM pour les actes (8 000+ codes, propre à la France, sans équivalent direct à l’étranger) : cette double nomenclature alimente la classification en GHM, réalisée par le logiciel de groupage de l’ATIH, aboutissant à un GHS tarifé — une cha ine entière qui n’existe sous cette forme dans aucun autre pays. L’Allemagne s’appuie sur un binôme comparable (ICD-10-GM + OPS), mais avec une logique différente : l’OPS est structuré en 6 chapitres et ~18 700 classes à six chiffres, là où la CCAM française est organisée par topographie anatomique et acte technique ; le groupage G-DRG est calculé annuellement par l’InEK à partir de données réelles de coûts hospitaliers, alors que les tarifs GHM français sont fixés administrativement par le ministère. Le Royaume-Uni se distingue par l’emploi de trois couches distinctes : SNOMED CT comme terminologie de saisie au point de soin (350 000+ concepts), ICD-10 pour le codage rétrospectif post-sortie, et OPCS-4 pour les procédures — un triptyque sans équivalent ailleurs, où la traduction SNOMED CT → ICD-10/OPCS-4 constitue elle-même un métier et une source d’erreurs. Les États-Unis poussent la complexité à son paroxysme : ICD-10-CM pour les diagnostics, ICD-10-PCS (77 000+ codes à 7 caractères) pour les procédures hospitalières, CPT (10 000+ codes) pour les actes ambulatoires, et HCPCS pour les fournitures, soit jusqu’à quatre nomenclatures superposées selon le contexte de soin — un éclatement qui s’explique par la fragmentation du système assurantiel (Medicare, Medicaid, assureurs privés) et le fait que le CPT est une propriété privée de l’AMA, générant des droits de licence. Le Canada, via le CIHI, a développé l’ICD-10-CA (version enrichie de l’ICD-10 au-delà du 4ᵉ caractère, couvrant aussi les risques occupationnels et environnementaux) couplée à la CCI, classification à 10 caractères alphanumériques conçue pour être neutre vis-à-vis du lieu et du type de prestataire — une approche délibérément pan-canadienne pour réconcilier 13 systèmes de santé provinciaux. Enfin, Taïwan présente le modèle le plus unifié : ayant migré vers l’ICD-10-CM PCS en 2016 (le même système qu’aux États-Unis), il bénéficie d’un payeur unique (NHIA) qui impose des règles de codage homogènes à l’ensemble des 18 000 établissements contractés, permettant un téléchargement quotidien automatisé des données et des coûts administratifs inférieurs à 1%. Au fond, cette diversité reflète moins des choix techniques qu’des histoires institutionnelles : là où la France a construit un système étatique centralisé avec une nomenclature d’actes souveraine (la CCAM), les États-Unis ont laissé le marché produire une pluralité de nomenclatures concurrentes ; là où l’Allemagne a délégué le calcul des tarifs à un organe paritaire (InEK), le Royaume-Uni a choisi de séparer la terminologie clinique du codage administratif. La transition vers l’ICD-11, premier vrai standard mondial commun, représente donc bien plus qu’une mise à jour technique : elle est un défi de convergence institutionnelle sans précédent


  • Éclairage terrain d’un DIM de Centre Hospitalier

    Qualité du DPI et traçabilité comme prérequis absolus

    L’IA de codage n’est pas une “couche magique” au-dessus du PMSI, mais un amplificateur de la qualité du dossier patient informatisé: observations médicales, dossier de soins, biologie, imagerie, avis spécialisés, etc. Un investissement important et continu est nécessaire sur la traçabilité, impliquant non seulement le DIM/TIM, mais aussi la DSI, les secrétariats médicaux, les médecins et les métiers transverses. Sans ce socle, la performance des algorithmes et la fiabilité des prédictions restent limitées.

    Place de l’humain au DIM et supervision structurée

    Les solutions disponibles, lorsqu’elles sont utilisées, s’inscrivent dans une logique d’automatisation supervisée, avec validation systématique par les équipes DIM/TIM. Les obligations de traçabilité (certification des comptes, contrôles Assurance maladie, audits internes) rendent indispensable la conservation d’une décision humaine documentée sur les modifications de codage. Cela suppose une réorganisation des flux au sein du DIM: idéalement un seul passage sur le dossier, avec à disposition les données consolidées et les propositions de l’IA au bon moment, et une distinction explicite entre séjours courts/peu complexes (automatisation forte) et séjours longs/complexes (assistance + supervision). 

    ROI réel, contraintes budgétaires et volonté institutionnelle

    Dans les Centre Hospitaliers sous tension financière et sous contrats de performance, la question “ROI ou pas ?” est centrale, et constitue un frein majeur au passage à l’échelle. Les retours terrain indiquent que les directions sont souvent sceptiques face à des promesses de ROI très élevées ou mal étayées, d’autant que la phase de test est chronophage et consomme des ressources rares. Pour le DIM, l’enjeu n’est pas prioritairement la suppression de postes, mais la reconfiguration du travail entre validation de codage et amélioration de la qualité/complétude des dossiers. Dans ce contexte, la réussite d’un projet IA suppose une volonté institutionnelle explicite, des responsables solides côté établissement et une équipe capable d’accompagner le changement. 

    Cadre PMSI évolutif et maintenance des algorithmes

    L’éclairage terrain rappelle que le codage évolue chaque année au rythme des modifications PMSI, des PLFSS et de l’ONDAM: nouveaux codes, nouvelles règles, fermeture de niches d’optimisation, nouveaux besoins de suivi (ex. crises sanitaires). Les solutions IA doivent donc intégrer une capacité de mise à jour et de réentraînement réguliers, ce qui a un impact direct sur le coût total de possession et sur la pérennité des gains. Dans un système à enveloppe contrainte, une partie des gains obtenus par optimisation de codage peut être partiellement résorbée à moyen terme, ce qui plaide pour des scénarios de ROI prudents et dynamiques. 

    KPI DIM jugés vraiment utiles pour piloter un projet IA

    Du point de vue d’un DIM de CH, les indicateurs les plus pertinents pour évaluer une solution d’IA de codage ne sont pas uniquement les métriques de performance algorithmiques, mais des KPI opérationnels de chaîne PMSI: 

    • Délai moyen entre sortie, codage, validation et facturation. 
    • Volume de dossiers traités par jour et par ETP, par typologie de séjour (séances, HDJ, hospitalisation complète, séjours avec suppléments). 
    • Pourcentage de séjours codés en automatisation IA et poids de ces séjours dans les recettes. 
    • Pourcentage de séjours modifiés par le TIM/DIM par rapport aux suggestions IA et impact associé sur les recettes. 
    • Taux de séjours codés avec aide IA retoqués en cas de contrôle (CAC, Assurance maladie). 

    Cet éclairage terrain, issu d’un DIM de CH non utilisateur d’IA à ce jour, souligne que la décision d’investir dans une solution d’IA de codage ne peut être dissociée ni de la maturité du DPI et de l’organisation DIM, ni du contexte budgétaire et réglementaire, ni d’un dispositif de mesure du ROI ancré dans les KPI opérationnels réels des établissements. 

    Tableau – KPI à suivre dans un pilote d’IA de codage PMSI 

    KPI suivi  Définition opérationnelle (DIM)  Usage dans le pilote IA 
    Délai sortie → codage  Nombre de jours entre la sortie du patient et le premier codage PMSI complet.   Objectiver l’impact de l’IA sur la rapidité de traitement des dossiers. 
    Délai sortie → validation / facturation  Nombre de jours entre sortie et validation/facturation effective.   Mesurer la capacité à approcher une facturation “au fil de l’eau”. 
    Volume de dossiers / jour / ETP DIM/TIM  Nombre moyen de séjours codés/validés par agent et par jour, par type de séjour.  Suivre les gains de productivité et les redistributions de charge. 
    Typologie des séjours traités  Répartition % séances, HDJ, hospit complète, séjours à suppléments, etc.  Vérifier que l’IA apporte un gain là où le volume et l’enjeu financier sont forts. 
    % de séjours codés en automatisation IA  Part des séjours entièrement codés par IA, sans intervention humaine.  Quantifier le “périmètre d’automatisation” réellement atteint. 
    Poids recettes des séjours automatisés  Part des recettes associées aux séjours automatisés IA.  Évaluer si l’IA touche les segments à fort enjeu financier. 
    % de séjours modifiés par TIM/DIM  Part des séjours où le codage IA est corrigé (ajouts, suppressions, modifications).  Suivre la pertinence pratique de l’IA et la charge de supervision. 
    Impact recettes des modifications humaines  Différence de recettes entre codage IA brut et codage final après intervention DIM.   Mesurer la valeur ajoutée humaine résiduelle et ajuster le discours ROI. 
    Taux de séjours invalidés en contrôle  Part des séjours codés avec IA (ou aide IA) faisant l’objet de corrections en contrôle.  Sécuriser le projet visàvis des CAC / Assurance maladie. 
    Temps consacré à l’amélioration de la traçabilité DPI  Temps DIM/TIM consacré à la formation et à l’amélioration de la qualité de saisie.  Intégrer dans le ROI le “coût” positif de montée en qualité des données. 


  • PNMR4 : un levier numérique pour structurer les données et les parcours en maladies rares

    Le numérique comme colonne vertébrale du PNMR4

    Le PNMR4 positionne les outils numériques comme supports centraux de ses objectifs, notamment pour réduire les délais diagnostiques, améliorer l’orientation et suivre les parcours des personnes vivant avec une maladie rare. Il articule les registres et bases existantes autour de la Banque nationale de données maladies rares, en cherchant à mieux exploiter ces données pour la recherche, la santé publique et l’évaluation des produits de santé.

    Des données numériques au service des enjeux économiques

    En structurant et en centralisant les données dans la BNDMR, le plan vise à rendre plus efficaces la production d’indicateurs et l’évaluation médico‑économique des thérapies innovantes, dans un contexte de coûts élevés et de faible volumétrie de patients. L’interopérabilité avec les systèmes d’information hospitaliers et la réduction de la double saisie doivent préserver le temps médical, diminuer les coûts de collecte et améliorer la qualité des données utilisées pour la décision et l’attractivité de la France en recherche clinique.

    Un écosystème d’acteurs structuré autour de la BNDMR

    Le PNMR4 consolide un écosystème centré sur la BNDMR, qui fédère filières maladies rares, centres de référence, laboratoires de biologie et établissements de santé contribuant aux bases via BaMaRa ou des flux connectés. Il associe également des acteurs patients et associatifs, ainsi que des partenaires académiques et industriels qui s’appuient sur ces données pour concevoir et évaluer des projets de recherche, des essais ou des dispositifs numériques.

    Un cadre réglementaire renforcé pour les usages numériques

    Le plan insiste sur la qualité, la standardisation et la gouvernance des données, avec des référentiels structurants pour les laboratoires et les centres cliniques, afin de sécuriser la réutilisation des données à des fins de recherche et de santé publique. Il prévoit un dispositif renforcé de pharmacovigilance, notamment pour les prescriptions hors AMM, et articule les projets numériques maladies rares avec les cadres nationaux existants, en intégrant les exigences de protection des données, de consentement et de conformité réglementaire.

    France Maladies Rares : une application pivot pour les patients

    Le PNMR4 prévoit le développement de l’application mobile France Maladies Rares, connectée à la BNDMR, pensée comme point d’entrée unique pour les patients et leurs aidants. Cette application doit leur permettre de contrôler leurs données et leurs consentements, de participer à la production de données (questionnaires, retours d’expérience) et de s’orienter vers des ressources fiables, selon une démarche de co‑conception avec patients, associations, filières et acteurs publics.

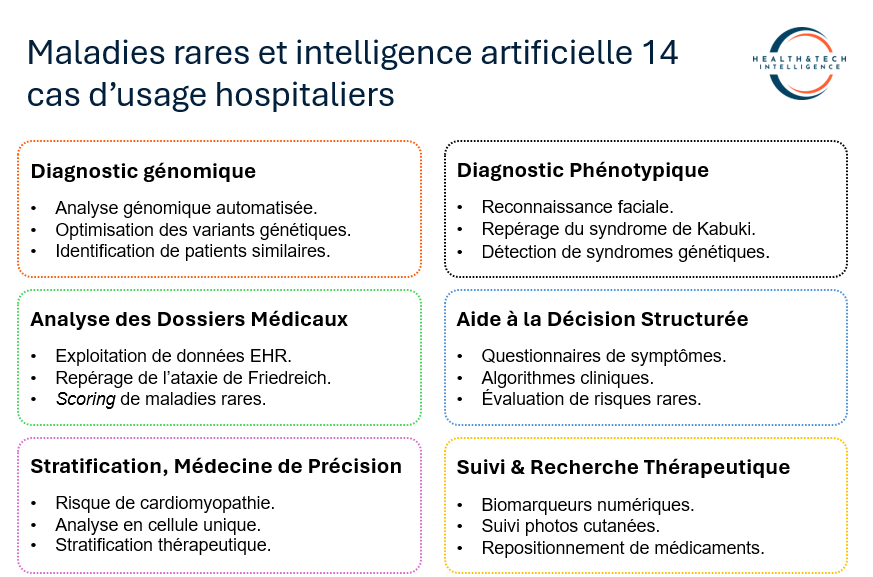
  • Intelligence Artificielle et Maladies Rares : Innovations, Défis et Trajectoires de Recherche dans l’Écosystème de Santé Numérique

    Les maladies rares représentent un défi sanitaire d’envergure mondiale, affectant entre 300 et 400 millions de personnes à travers le monde[3]. Malgré cette prévalence collective considérable, plus de 90% de ces pathologies demeurent sans thérapie efficace[1], et la majorité des patients restent non diagnostiqués ou insuffisamment traités en raison de délais diagnostiques prolongés et de l’absence de traitements spécifiques[3]. Dans ce contexte, l’intelligence artificielle offre des perspectives transformatrices pour accélérer la détection, optimiser le développement thérapeutique et améliorer la prise en charge clinique des maladies rares.

    Le présent article synthétise un corpus de 35 publications scientifiques récentes couvrant la période 2024-2026, issues de revues internationales de référence incluant Journal of Chemical Information and Modeling, Trends in Pharmacological Sciences, Nature, Orphanet Journal of Rare Diseases, JMIR AI, et NEJM AI. Ces travaux proviennent d’institutions académiques et cliniques situées en Europe (Université de Coimbra au Portugal, University College London au Royaume-Uni, Charité-Universitätsmedizin Berlin en Allemagne, Università degli Studi di Milano en Italie), en Amérique du Nord (Mayo Clinic et U.S. Food and Drug Administration aux États-Unis, Boston Children’s Hospital et Harvard Medical School), et en Asie (Showa University Northern Yokohama Hospital au Japon). L’analyse couvre les applications de l’intelligence artificielle dans la découverte de médicaments, le diagnostic précoce, la pharmacovigilance, la gestion clinique et les infrastructures de recherche, en mettant l’accent sur les innovations méthodologiques, les résultats quantitatifs et les implications stratégiques pour le secteur de la santé numérique.

    Découverte de Médicaments et Repositionnement Thérapeutique

    État des Lieux et Potentiel Transformateur

    Le développement de médicaments pour les maladies rares présente des obstacles structurels majeurs. Gangwal et Lavecchia, chercheurs en Inde et en Italie, soulignent que les modèles traditionnels de découverte pharmaceutique, caractérisés par des cycles de développement prolongés et des taux d’échec élevés, génèrent des retours sur investissement insuffisants pour ces pathologies[1]. L’adoption de techniques d’intelligence artificielle, englobant le machine learning et le deep learning, permet de surmonter ces limitations en accélérant l’identification de cibles thérapeutiques, le repositionnement de médicaments existants, la découverte de biomarqueurs et l’optimisation des essais cliniques[1].

    Amorim et collaborateurs, affiliés à l’Université de Coimbra et à l’entreprise PURR.AI au Portugal, démontrent que l’intelligence artificielle intègre des données génomiques, cliniques et d’imagerie pour accélérer la détection et la découverte thérapeutique dans le domaine des maladies rares[3]. Cependant, ces auteurs constatent une persistance du fossé entre l’innovation algorithmique et l’impact clinique réel, la plupart des outils d’intelligence artificielle demeurant confinés au stade de preuve de concept[3]. Les avancées récentes dans les modèles génératifs, l’apprentissage fédéré et l’intelligence artificielle explicable ont commencé à surmonter les barrières liées à la rareté des données, aux préoccupations de confidentialité et aux biais algorithmiques[3].

    Infrastructures et Données pour la Recherche Thérapeutique

    Dette et collaborateurs, issus de l’Université de la Sarre en Allemagne et d’institutions internationales, examinent l’application des jumeaux numériques dans le développement de médicaments pour les maladies rares[5]. Leur analyse de 16 études identifie plusieurs techniques de modélisation sous-jacentes, incluant la modélisation pharmacocinétique physiologique, la modélisation pharmacocinétique de population, la modélisation pharmacologique des systèmes quantitatifs et la modélisation du physiome[5]. Bien que ces approches facilitent la stratégie thérapeutique, la modélisation de la progression de la maladie et le support décisionnel clinique, l’implémentation des jumeaux numériques dans le domaine des maladies rares demeure à un stade précoce de développement[5].

    L’intégration de données issues de registres et de dossiers de santé électroniques constitue un levier stratégique pour l’enrichissement des bases de données thérapeutiques. Yadaw et collaborateurs, du National Center for Advancing Translational Sciences aux États-Unis, ont développé un workflow semi-automatisé permettant d’identifier 357 codes ICD-10 et 12 081 codes SNOMED-CT représentant 6 342 maladies rares répartis en 30 classes de linéarisation Orphanet[21]. Cette approche systématique a permis d’identifier 404 735 patients atteints de maladies rares dans une cohorte de 4 835 718 individus positifs à la COVID-19, soit 8,37% de la population étudiée[21]. Les ratios de risque de mortalité et d’hospitalisation pour les différentes classes de maladies rares variaient de 0,23 à 5,28 et de 0,93 à 3,13 respectivement[21].

    Diagnostic Précoce et Reconnaissance Phénotypique

    Technologies de Reconnaissance Faciale et Multimodale

    L’identification précoce des maladies rares constitue un enjeu clinique majeur, les délais diagnostiques prolongés entraînant une progression pathologique et des coûts sanitaires substantiels. Rudy et collaborateurs, représentant des institutions américaines, géorgiennes et italiennes, présentent 17 cas cliniques impliquant 19 patients pour lesquels la technologie DeepGestalt, intégrée dans l’application Face2Gene, a modifié les décisions de tests génétiques des médecins généticiens en temps réel[13]. Cette technologie de reconnaissance faciale avancée permet d’orienter une stratégie de test plus efficace dans les situations où les défis cliniques incluent l’étendue limitée de l’expérience du clinicien, l’absence de dysmorphologie distinctive ou chevauchante, les présentations atypiques et les difficultés d’identification phéno typique à travers différentes ancestralités[13].

    Wang et collaborateurs, du Shanghai Health Development Research Center en Chine, identifient des applications de l’intelligence artificielle centrées sur le support décisionnel diagnostique, le phénotypage, le suivi de la progression et la stratification des risques[14]. Les algorithmes d’apprentissage few-shot, conçus pour surmonter la rareté des données, et les modèles fondamentaux validés cliniquement améliorent la cohérence diagnostique entre institutions[14]. Les frameworks d’intelligence artificielle multimodaux, intégrant imagerie, données génomiques et phénotypiques, augmentent la précision diagnostique[14].

    Performance Comparative et Intégration Clinique

    Sendtner et collaborateurs, de l’Hôpital Universitaire de Bonn en Allemagne, ont comparé les performances de l’outil de diagnostic différentiel Isabel Healthcare DDx companion avec celles de conférences de cas interdisciplinaires sur une cohorte de 100 patients d’âge moyen de 44 ans[24]. L’outil et les conférences ont généré un total de 727 suggestions diagnostiques[24]. Parmi les dix premiers diagnostics suggérés par Isabel Healthcare DDx companion, 28% correspondaient à au moins un diagnostic identifié lors des conférences de cas interdisciplinaires[24]. Les diagnostics suggérés comme plus probables par l’outil présentaient une corrélation plus élevée avec les diagnostics différentiels et les procédures identifiés lors des conférences, suggérant un alignement potentiel dans les processus de prise de décision clinique[24].

    Frias et collaborateurs, de l’Hôpital Sant Joan de Déu en Espagne, abordent le défi de l’utilisation de techniques d’intelligence artificielle dans le diagnostic de la dystrophie musculaire congénitale liée au collagène VI à partir d’images de microscopie confocale[17]. Leur étude démontre qu’en utilisant des procédures appropriées de gestion et d’entraînement des données, il est possible de dériver un classificateur hautement précis même avec une quantité limitée de données d’entraînement, en appliquant à la fois des techniques classiques de machine learning et des approches modernes de deep learning[17].

    Pharmacovigilance et Surveillance des Effets Indésirables

    Limites des Systèmes Conventionnels

    La pharmacovigilance pour les maladies rares présente des lacunes considérables dans les mesures conventionnelles, susceptibles d’entraîner des problèmes de sécurité significatifs, particulièrement dans le monitoring de l’efficacité des médicaments orphelins[2]. Jain et Adenwala, chercheurs chez Curis Inc. et Seres Therapeutics Inc. aux États-Unis, identifient les systèmes de notification d’événements indésirables inefficaces, le faible taux d’enrôlement de patients et la surveillance faible des signaux comme obstacles à l’évaluation efficace de la sécurité des maladies rares[2].

    Potentiel de l’Intelligence Artificielle et du Machine Learning

    Les technologies d’intelligence artificielle et de machine learning offrent la possibilité d’automatiser la notification des événements indésirables en intégrant des données provenant de sources multiples et en augmentant la sensibilité de la détection des risques[2]. Les auteurs identifient des préoccupations techniques et réglementaires telles que la confidentialité et l’explicabilité des modèles comme obstacles à l’adoption de l’intelligence artificielle dans la pharmacovigilance[2]. Toutefois, si elle est correctement intégrée dans le système, cette technologie présente le potentiel d’améliorer le monitoring du traitement des maladies rares et d’augmenter le taux de développement de nouvelles thérapies[2].

    Technologies de Santé Numérique et Essais Cliniques

    Adoption des Technologies de Santé Numérique

    Mao et collaborateurs, affiliés à la Tsinghua University en Chine, aux institutions australiennes, américaines et européennes, ont conduit une revue systématique de 262 études identifiées via ClinicalTrials.gov et d’autres registres internationaux jusqu’au 26 juin 2024[9]. Les applications de technologies de santé numérique ont été classifiées en recrutement de patients, traitement numérique, surveillance et collecte de données, évaluation des résultats, suivi à distance et gestion des soins à long terme[9].

    Application DHT Proportion Description
    Surveillance et collecte de données 31,3% Suivi continu des paramètres physiologiques pertinents pour des conditions spécifiques de maladies rares
    Traitement numérique 21,8% Principalement physiothérapie numérique


    Table 1: Distribution des applications de technologies de santé numérique dans les essais cliniques de maladies rares

    Une augmentation notable de l’adoption des technologies de santé numérique a été observée entre les périodes 2017-2020 et 2021-2024 dans la quasi-totalité des dix maladies étudiées[9]. Entre 2021 et 2024, la mucoviscidose présentait la proportion la plus élevée d’essais intégrant des technologies de santé numérique par rapport à toutes les études menées pour cette pathologie, soit 29,7%[9]. Les auteurs proposent un cadre conceptuel 4A incluant l’accessibilité, l’agilité, la sensibilisation et l’adaptabilité pour accélérer le développement thérapeutique et élargir l’accès aux soins pour ces populations de maladies rares sous-desservies[9].

    Cas d’Usage Spécifique : Maladie de Fabry

    Pankow et collaborateurs, de la Charité-Universitätsmedizin Berlin et de l’Hannover Medical School en Allemagne, ont évalué l’intégration de vignettes cliniques dérivées d’experts dans des symptom checkers alimentés par intelligence artificielle pour améliorer la précision diagnostique et la satisfaction utilisateur dans la maladie de Fabry[19]. Trois experts médicaux spécialisés dans les maladies de surcharge lysosomale ont contribué à la création de cinq vignettes cliniques intégrées dans le symptom checker[19]. L’étude a comparé les versions originale et optimisée sur six patients atteints de la maladie de Fabry[19]. La version optimisée a amélioré la précision diagnostique, avec la maladie de Fabry identifiée comme suggestion principale dans 33% des cas, comparativement à 17% avec le modèle original[19]. La satisfaction utilisateur globale était supérieure pour la version optimisée, les participants l’évaluant plus favorablement en termes de couverture des symptômes et d’exhaustivité[19].

    Biocuration Assistée et Représentation Structurée des Connaissances

    Automatisation de l’Annotation Ontologique

    Niyonkuru et collaborateurs, du Jackson Laboratory for Genomic Medicine aux États-Unis et institutions internationales, présentent AutoMAxO, un workflow semi-automatisé exploitant les modèles de langage de grande taille pour rationaliser la biocuration de la Medical Action Ontology[11]. AutoMAxO utilise d’abord les modèles de langage de grande taille pour récupérer des curations candidates à partir de résumés de publications pertinentes, puis les curations candidates sont appariées aux termes ontologiques de MAxO, Human Phenotype Ontology et MONDO disease ontology via une combinaison de modèles de langage de grande taille et de techniques de post-traitement[11]. L’approche a été utilisée pour traiter des résumés liés à 37 maladies génétiques rares et a identifié 958 nouvelles annotations de traitement transférées vers l’ensemble de données d’annotations MAxO[11].

    Implications pour la Standardisation des Données

    Wang et collaborateurs, de l’Institut Imagine en France, démontrent que l’enrichissement des bases de données structurées avec du texte clinique non structuré augmente de 73,5% le nombre de patients éligibles pour l’analyse longitudinale, élargit de 189% les mesures disponibles et étend significativement la durée médiane de suivi de 3,2 à 6,6 ans dans l’étude de la progression de la maladie rénale chronique chez les patients atteints de ciliopathies[23]. L’utilisation de la régression mixte linéaire pour modéliser les trajectoires individuelles du taux de filtration glomérulaire estimé en fonction de l’âge a révélé que l’enrichissement des données réduisait les erreurs standard de 30%, indiquant une augmentation substantielle de la précision et de la fiabilité[23].

    Considérations Éthiques, Réglementaires et Organisationnelles

    Enjeux Éthiques dans l’Ère de la Santé Numérique

    Siderius et collaborateurs, représentant des institutions néerlandaises, australiennes, lituaniennes, indiennes et portugaises, soulignent que pour améliorer les résultats de santé et de bien-être des personnes atteintes de conditions rares, il est nécessaire d’intégrer tous les aspects de la santé et du bien-être[6]. Les technologies de santé numérique peuvent capturer et partager de manière appropriée des données harmonisées entre les prestataires de soins et les personnes concernées[6]. La qualité de la santé numérique dépend de points de données définis reflétant la situation médicale et sociétale réelle et enregistrant les changements lorsque de nouveaux diagnostics ou thérapies deviennent disponibles[6]. Les expériences de vie des individus vivant avec une condition, individuellement ou en groupe, sont sous-représentées dans le monde en voie de digitalisation[6]. Les auteurs considèrent la notion kantienne de noumènes : seuls les individus atteints de conditions rares invalidantes peuvent véritablement transmettre la réalité de vivre avec ces conditions[6].

    Cadre Réglementaire et Défis Techniques

    Refolo et collaborateurs, de l’Università Cattolica del Sacro Cuore en Italie et d’institutions espagnoles, roumaines et italiennes, identifient treize problématiques supplémentaires et leurs questions correspondantes dans l’évaluation éthique, légale et sociale des technologies basées sur l’intelligence artificielle pour la prévention et le diagnostic des maladies rares[20]. Les préoccupations éthiques liées aux maladies rares incluent la connaissance insuffisante de l’historique de la maladie, le manque de données cliniques robustes, l’absence d’outils d’efficacité validés, les risques de surdiagnostic et sous-diagnostic et les seuils ICER inconnus[20]. La médecine défensive a été identifiée comme une problématique légale[20]. Pour les technologies basées sur l’intelligence artificielle, les préoccupations incluent les résultats discriminatoires, l’explicabilité et l’impact environnemental sur le plan éthique, la responsabilité et le remboursement sur le plan légal, et l’implication des patients et les pertes d’emplois sur le plan social[20].

    Papadopoulou et collaborateurs, de l’Université Ionienne en Grèce, soulignent que malgré les avancées, les préoccupations éthiques concernant l’intelligence artificielle dans la médecine de précision demeurent un défi[16]. Aborder ces problématiques nécessite une recherche transdisciplinaire impliquant des praticiens médicaux, des éthiciens et des scientifiques des données pour développer des cadres de validation robustes et des méthodologies de certification[16]. L’objectif est d’assurer une gouvernance algorithmique responsable garantissant des innovations médicales sûres, transparentes et équitables[16].

    Défis de Données et Stratégies d’Atténuation

    Poddar et collaborateurs, de la U.S. Food and Drug Administration, examinent les défis liés aux données limitées dans le développement de médicaments pour les maladies rares et proposent des stratégies d’intégration de l’intelligence artificielle[22]. Les problématiques liées aux petites populations de patients, aux informations limitées sur l’histoire naturelle et à l’hétérogénéité clinique au sein des maladies rares peuvent être abordées par diverses stratégies, incluant l’utilisation de l’intelligence artificielle et de méthodes analytiques avancées, l’exploitation de données détaillées au niveau individuel et l’exploration de la génération de données synthétiques pour surmonter les limitations des petits ensembles de données[22]. L’établissement de bases de données centralisées et la promotion de partenariats public-privé peuvent contribuer à construire un référentiel plus complet des données disponibles[22].

    Cas d’Usage en Vie Réelle et Validation Clinique

    Implémentation dans les Systèmes de Santé

    Greco et collaborateurs, de la Harvard Medical School et du Boston Children’s Hospital, proposent WEST, un transformer faiblement supervisé pour le diagnostic et le sous-phénotypage des maladies rares à partir de dossiers de santé électroniques[33]. Au cœur de WEST se trouve un transformer faiblement supervisé entraîné sur un ensemble limité d’étiquettes validées par des experts et d’étiquettes silver-standard probabilistes extensives dérivées de caractéristiques structurées et non structurées des dossiers de santé électroniques, qui sont itérativement raffinées à travers les cycles d’entraînement pour améliorer la calibration du modèle[33]. L’évaluation de WEST sur deux conditions pulmonaires rares utilisant des données de dossiers de santé électroniques du Boston Children’s Hospital démontre qu’il surpasse les méthodes existantes en termes de classification de phénotype, d’identification de sous-phénotypes cliniquement pertinents et de prédiction de la progression de la maladie[33].

    Abugabah et collaborateurs, de la Zayed University aux Émirats Arabes Unis et d’institutions indiennes, présentent un framework de santé multimodal intelligent intégrant dossiers de santé électroniques, séquences génomiques et imagerie médicale pour améliorer la détection des maladies rares[26]. Le framework utilise Swin Transformer pour extraire des caractéristiques visuelles hiérarchiques dans les scans radiographiques, Med-BERT et Transformer-XL pour apprendre les relations sémantiques et temporelles à long terme dans les narratifs longitudinaux de dossiers de santé électroniques, et un encodeur basé sur Graph Neural Network pour apprendre les relations fonctionnelles et structurelles dans les séquences génomiques[26]. L’alignement de la représentation cross-modale est renforcé par un mécanisme de Knowledge-Guided Contrastive Learning exploitant les ontologies de maladies rares d’Orphanet pour améliorer l’interprétabilité du modèle et l’infusion de connaissances[26]. Le Nutcracker Optimization Algorithm est proposé pour optimiser les hyperparamètres, calibrer les mécanismes d’attention et améliorer la fusion multimodale[26]. Les résultats expérimentaux sur les ensembles de données MIMIC-IV, ClinVar et CheXpert montrent que le framework surpasse significativement les références multimodales de l’état de l’art en termes de précision et de robustesse du diagnostic précoce des maladies rares[26].

    Confidentialité et Sécurité des Données

    Rajaganapathy et collaborateurs, de la Mayo Clinic et de l’University of Texas Health Science Center aux États-Unis, développent un framework de diagnostic assisté par modèles de langage de grande taille préservant la confidentialité des patients en exploitant le chiffrement homomorphe, avec le diagnostic de maladies rares comme application représentative[30]. Les textes des antécédents des patients et d’une base de connaissances sur les maladies rares ont été intégrés par les modèles de langage de grande taille dans des vecteurs, puis chiffrés en utilisant le chiffrement homomorphe pour obscurcir les informations privées tout en conservant les nuances sémantiques[30]. Les recommandations diagnostiques ont été générées en calculant et classant les similitudes entre l’historique du patient et les vecteurs de maladies rares dans l’espace chiffré[30]. Le système a été évalué en utilisant 50 rapports de cas synthétiques couvrant cinq maladies rares avec dix rapports chacune[30]. L’application du chiffrement homomorphe a protégé les informations privées contre les attaques de reverse-embedding[30]. Le chiffrement homomorphe a imposé peu de perturbations à la précision diagnostique, avec des valeurs de normalized discounted cumulative gains de 0,6108 ± 0,3412 pour les données chiffrées contre 0,6083 ± 0,3415 pour les données non chiffrées[30].

    Stratégies d’Intégration dans les Systèmes de Santé Africains

    Gamba et Magili, de l’Université de Liverpool au Royaume-Uni et de la Tanzania Human Genetics Organization en Tanzanie, soulignent la nécessité d’intégrer les maladies rares dans les stratégies de santé numérique de l’Afrique[18]. Cette perspective met en lumière les disparités géographiques dans l’accès aux technologies d’intelligence artificielle et la nécessité de stratégies d’implémentation contextualisées tenant compte des infrastructures sanitaires locales, des capacités techniques et des cadres réglementaires spécifiques aux contextes à ressources limitées.

    Discussion et Implications Stratégiques

    Synthèse des Acquis et Trajectoires de Recherche

    L’analyse du corpus de 35 publications scientifiques révèle une dynamique d’innovation soutenue dans l’application de l’intelligence artificielle aux maladies rares, avec des avancées significatives dans quatre domaines structurants : la découverte de médicaments et le repositionnement thérapeutique, le diagnostic précoce par reconnaissance phénotypique, la pharmacovigilance automatisée et l’optimisation des essais cliniques via les technologies de santé numérique. Les données quantitatives extraites des études démontrent des gains d’efficience substantiels, incluant une augmentation de 73,5% du nombre de patients éligibles pour les analyses longitudinales, une réduction de 30% des erreurs standard dans la modélisation de la progression pathologique, et une amélioration de la précision diagnostique passant de 17% à 33% avec l’intégration de vignettes cliniques expertes dans les symptom checkers.

    Les modèles génératifs, l’apprentissage fédéré et l’intelligence artificielle explicable émergent comme solutions technologiques prioritaires pour surmonter les contraintes structurelles de rareté des données, de confidentialité et de biais algorithmiques[3]. L’adoption de techniques d’apprentissage few-shot et de frameworks multimodaux intégrant données génomiques, cliniques et d’imagerie constitue une réponse méthodologique adaptée à la dispersion et à la faible prévalence caractéristiques des maladies rares[14].

    Lacunes Actuelles et Impératifs de Développement

    Malgré ces avancées, un fossé persistant sépare l’innovation algorithmique de l’impact clinique tangible, la majorité des outils d’intelligence artificielle demeurant confinés au stade de preuve de concept[3]. Amorim et collaborateurs identifient des priorités techniques, éthiques et infrastructurelles incluant l’équité, les données FAIR et la coordination globale comme conditions nécessaires à la traduction de l’intelligence artificielle pour les maladies rares en bénéfices cliniques tangibles[3].

    Les défis méthodologiques identifiés incluent l’hétérogénéité des approches de validation, l’absence d’essais contrôlés randomisés publiés spécifiques aux maladies rares, et la prédominance d’études observationnelles mono-centriques de petite taille[29]. Cette situation limite les inférences sur l’efficacité et l’implémentation routinière des technologies d’intelligence artificielle dans les parcours de soins. L’établissement d’infrastructures de données interopérables, la disponibilité de données de haute qualité, les évaluations prospectives multicentriques et la transparence dans le reporting des algorithmes et workflows constituent des priorités pour une adoption sûre, équitable et scalable alignée avec les priorités européennes et globales en matière de maladies rares[29].

    Implications pour les Acteurs de la Santé Numérique

    Pour les professionnels de santé, l’intégration de l’intelligence artificielle dans les processus diagnostiques et thérapeutiques des maladies rares nécessite une formation spécifique aux outils numériques, une compréhension des limites et biais algorithmiques, et le maintien d’une garantie humaine dans la prise de décision clinique[4]. Germain et collaborateurs, de l’Université de Versailles-Saint-Quentin-en-Yvelines en France, soulignent que l’utilisation de technologies d’intelligence artificielle dans les soins de santé peut générer des risques éthiques spécifiques, ce qui incite à l’établissement de nouveaux cadres réglementaires en Europe et aux États-Unis visant à aborder ces problématiques tout en assurant que l’implication humaine reste au centre des soins aux patients durant cette révolution technologique[4].

    Pour les dirigeants du secteur de la santé numérique, les opportunités stratégiques incluent le développement de partenariats public-privé pour la constitution de bases de données centralisées, l’investissement dans des infrastructures cloud sécurisées permettant l’apprentissage fédéré, et la conception de modèles économiques adaptés aux spécificités réglementaires et de remboursement des technologies d’intelligence artificielle pour les maladies rares. Les résultats démontrant une réduction des temps de revue de 24,29 ± 12,62 minutes avec ChatGPT comparativement à 42,54 ± 20,43 minutes avec les matériaux de revue traditionnels[19] illustrent le potentiel d’efficience opérationnelle de ces technologies.

    Perspectives d’Évolution et Convergence Technologique

    L’émergence de l’Internet of Medical Things représente une nouvelle frontière à l’ère numérique pour les essais cliniques de maladies rares et le développement pharmaceutique global[34]. L’intégration de biomarqueurs numériques dans le développement thérapeutique pour les maladies rares constitue une perspective identifiée par l’International Rare Diseases Research Consortium[32]. Les avancées dans l’intelligence artificielle génomique, illustrées par les développements de DeepMind[28], offrent des perspectives pour résoudre les mystères des maladies rares en améliorant l’interprétation des variants génétiques et l’identification de mutations pathogènes.

    Conclusion

    L’intelligence artificielle représente un levier transformateur pour surmonter les défis structurels des maladies rares, affectant collectivement des centaines de millions de personnes dans le monde. Les 35 publications analysées, provenant d’institutions académiques et cliniques de référence en Europe, Amérique du Nord et Asie, documentent des avancées significatives dans la découverte de médicaments, le diagnostic précoce, la pharmacovigilance et l’optimisation des essais cliniques. Les données quantitatives extraites démontrent des gains d’efficience substantiels et des améliorations de précision diagnostique mesurables.

    Toutefois, le fossé persistant entre innovation algorithmique et implémentation clinique nécessite une attention stratégique aux priorités techniques, éthiques et infrastructurelles. L’établissement de données FAIR, le développement de cadres réglementaires adaptés, la promotion de partenariats public-privé et la garantie d’une gouvernance algorithmique responsable constituent des conditions nécessaires à la traduction de l’intelligence artificielle en bénéfices cliniques tangibles pour les patients atteints de maladies rares.

    Pour les professionnels de santé et les dirigeants du secteur de la santé numérique, les trajectoires d’innovation documentées offrent des perspectives d’amélioration des parcours diagnostiques et thérapeutiques, tout en imposant une vigilance continue quant aux enjeux éthiques, de confidentialité et d’équité d’accès. La convergence des technologies d’intelligence artificielle, des infrastructures de données interopérables et des modèles organisationnels collaboratifs définit l’horizon stratégique pour l’écosystème de la santé numérique appliqué aux maladies rares.


    Références

    [1] Gangwal, A., & Lavecchia, A. (2025). AI-Driven Drug Discovery for Rare Diseases. Journal of Chemical Information and Modeling, 65(5), 2214-2231. https://doi.org/10.1021/acs.jcim.4c01966

    [2] Jain, A., & Adenwala, Z. (2025). The role of artificial intelligence in pharmacovigilance for rare diseases. Expert Opinion on Drug Safety, 24(8), 893-898. https://doi.org/10.1080/14740338.2025.2474645

    [3] Amorim, A. M. B., Orzeł, U., Caniceiro, A. B., Rosário-Ferreira, N., & Moreira, I. S. (2025). Artificial intelligence in rare diseases: toward clinical impact. Trends in Pharmacological Sciences, 46(12), 1241-1268. https://doi.org/10.1016/j.tips.2025.10.010

    [4] Germain, D. P., Gruson, D., Malcles, M., & Garcelon, N. (2025). Applying artificial intelligence to rare diseases: a literature review highlighting lessons from Fabry disease. Orphanet Journal of Rare Diseases, 20(1), 186. https://doi.org/10.1186/s13023-025-03655-x

    [5] Dette, C. M. U., Alberg, V., Rüdesheim, S., Selzer, D., Marok, F. Z., Bragazzi, N. L., Fuhr, L. M., Brunak, S., Pearson, E. R., Zahn, T., Kiritsi, D., Schwab, M., & Lehr, T. (2025). Advancing rare disease therapeutics through digital twins: Opportunities in drug development and precision dosing. Computational and Structural Biotechnology Journal, 28, 592-608. https://doi.org/10.1016/j.csbj.2025.11.047

    [6] Siderius, L., Perera, S. D., Jankauskaite, L., Bhattacharya, A., & Gonçalves, P. (2025). Rare diseases: ethical challenges in the era of digital health. Frontiers in Digital Health, 7, 1539841. https://doi.org/10.3389/fdgth.2025.1539841

    [9] Mao, X., Zeng, D., Wang, X., Pearce, D. A., Baynam, G., Chavannes, N. H., Chung, W. K., Wu, H., Tham, Y. C., Zhang, S., Li, G., & Wong, T. Y. (2025). Digital health technology use in clinical trials of rare diseases: a systematic review. Communications Medicine, 5(1), 449. https://doi.org/10.1038/s43856-025-01137-6

    [11] Niyonkuru, E., Caufield, J. H., Carmody, L. C., Gargano, M. A., Toro, S., Whetzel, P. L., Blau, H., Soto Gomez, M., Casiraghi, E., Chimirri, L., Reese, J. T., Valentini, G., Haendel, M. A., Mungall, C. J., & Robinson, P. N. (2025). Leveraging generative AI to assist biocuration of medical actions for rare disease. Bioinformatics Advances, 5(1), vbaf141. https://doi.org/10.1093/bioadv/vbaf141

    [13] Rudy, N. L., Gomes, A., Tkemaladze, T., Abdul-Rahman, O., Cratsenberg, D., Pascolini, G., Di Zenzo, G., Castiglia, D., Black, E., Washington, C., Chad, L., Curry, C., Del Campo, M., Fleischer, N., Bird, L. M., & Hurst, A. C. E. (2025). Artificial Intelligence Software Changes Rare Disease Testing Strategy in Real Time: An International Case Series Using Face2Gene. American Journal of Medical Genetics Part A, 197(11), e64171. https://doi.org/10.1002/ajmg.a.64171

    [14] Wang, X., He, D., & Jin, C. (2025). AI-driven enhancements in rare disease diagnosis and support system optimization. Intractable & Rare Diseases Research, 14(4), 306-308. https://doi.org/10.5582/irdr.2025.01079

    [16] Papadopoulou, E., Adam, S., & Exarchos, T. (2026). Precision Medicine Bioethics and AI Ethics: The Case of Rare Diseases. Advances in Experimental Medicine and Biology, 1490, 165-171. https://doi.org/10.1007/978-3-032-03402-1_18

    [17] Frías, M., Badosa, C., Jimenez-Mallebrera, C., Porta, J. M., & Roldán, M. (2025). The artificial intelligence challenge in rare disease diagnosis: A case study on collagen VI muscular dystrophy. Computers in Biology and Medicine, 196(Pt A), 110610. https://doi.org/10.1016/j.compbiomed.2025.110610

    [18] Gamba, S. F., & Magili, M. (2025). Integrating rare diseases into Africa’s digital health strategies. PLOS Digital Health, 4(11), e0001073. https://doi.org/10.1371/journal.pdig.0001073

    [19] Pankow, A., Meißner-Bendzko, N., Kaufeld, J., Fouquette, L., Cotte, F., Gilbert, S., Türk, E., Das, A., Terkamp, C., Burmester, G. R., & Wagner, A. D. (2025). Medical Expert Knowledge Meets AI to Enhance Symptom Checker Performance for Rare Disease Identification in Fabry Disease: Mixed Methods Study. JMIR AI, 4, e55001. https://doi.org/10.2196/55001

    [20] Refolo, P., Raimondi, C., Astratinei, V., Battaglia, L., Borràs, J. M., Closa, P., Lo Scalzo, A., Marchetti, M., Muñoz-López, S., Sampietro-Colom, L., & Sacchini, D. (2025). Ethical, Legal, and Social Assessment of AI-Based Technologies for Prevention and Diagnosis of Rare Diseases in Health Technology Assessment Processes. Healthcare, 13(7), 829. https://doi.org/10.3390/healthcare13070829

    [21] Yadaw, A. S., Sid, E., Sidky, H., Zeng, C., Zhu, Q., & Mathé, E. A. (2025). Systematic identification of rare disease patients in electronic health records enables evaluation of clinical outcomes. medRxiv. https://doi.org/10.1101/2025.05.02.25325348

    [22] Poddar, A., Innes, G. K., Liu, Q., Saha, A., Hanger, M., Franzetti, K., ElZarrad, M. K., & Fakhouri, T. H. (2025). Mitigating Limited Data Challenges to Improve Artificial Intelligence Integration in Rare Disease Drug Development. NEJM AI, 2(12), AIp2500802. https://doi.org/10.1056/AIp2500802

    [23] Wang, X., Faviez, C., Douillet, M., Knebelmann, B., Garcelon, N., Burgun, A., & Chen, X. (2025). Enhancing Longitudinal Data Analysis with Unstructured EHRs: A Case Study of Renal Function Evaluation in Rare Disease. Studies in Health Technology and Informatics, 327, 1270-1274. https://doi.org/10.3233/SHTI250602

    [24] Sendtner, G. W., Muecke, M., Grigull, L., Bender, T., Behning, C., & Schäfer, V. S. (2025). Cracking the code: a head-to-head comparison of expert clinicians and artificial intelligence in diagnosing rare diseases. Orphanet Journal of Rare Diseases, 20(1), 564. https://doi.org/10.1186/s13023-025-04112-5

    [26] Abugabah, A., Shukla, P. K., Shukla, P. K., & Pandey, A. (2025). An intelligent healthcare system for rare disease diagnosis utilizing electronic health records based on a knowledge-guided multimodal transformer framework. BioData Mining, 18(1), 70. https://doi.org/10.1186/s13040-025-00487-0

    [28] Callaway, E. (2026). How DeepMind’s genome AI could help solve rare-disease mysteries. Nature. https://doi.org/10.1038/d41586-026-00302-8

    [29] Spreafico, A. M. C., Neri, L., Angel, K., Bellettato, C. M., & Scarpa, M. (2026). Digital Health for Rare Diseases: A Scoping Review of Artificial Intelligence, Connected Care, and Enabling Digital Technologies for Lysosomal Storage Disorders. Journal of Medical Internet Research. https://doi.org/10.2196/73612

    [30] Rajaganapathy, S., St Sauver, J., Pinto E Vairo, F., Iyer, P. G., Liu, H., & Fan, J. W. (2026). Hide and Seek: Privacy-Preserving Artificial Intelligence with a Feasibility Study in Rare Disease Diagnosis. medRxiv. https://doi.org/10.64898/2026.01.15.26344228

    [32] Krishna, R., Jonker, A. H., Morel, T., Sakushima, K., Pasmooij, A. M. G., & O’Connor, D. (2025). IRDiRC perspectives on the application of digital biomarkers in therapeutic development for rare diseases. Nature Reviews Drug Discovery, 24(4), 233-234. https://doi.org/10.1038/d41573-024-00196-z

    [33] Greco, K. F., Yang, Z., Li, M., Tong, H., Morini Sweet, S., Geva, A., Mandl, K. D., Raby, B. A., & Cai, T. (2026). A weakly supervised transformer for rare disease diagnosis and subphenotyping from EHRs with pulmonary case studies. npj Digital Medicine. https://doi.org/10.1038/s41746-026-02406-x

    [34] Kendirci, A. (2025). Letter: The Internet of Medical Things (IoMT): A New Frontier in the Digital Age for Rare Disease Clinical Trials and Global Drug Development. OMICS: A Journal of Integrative Biology. https://doi.org/10.1177/15578100251394593

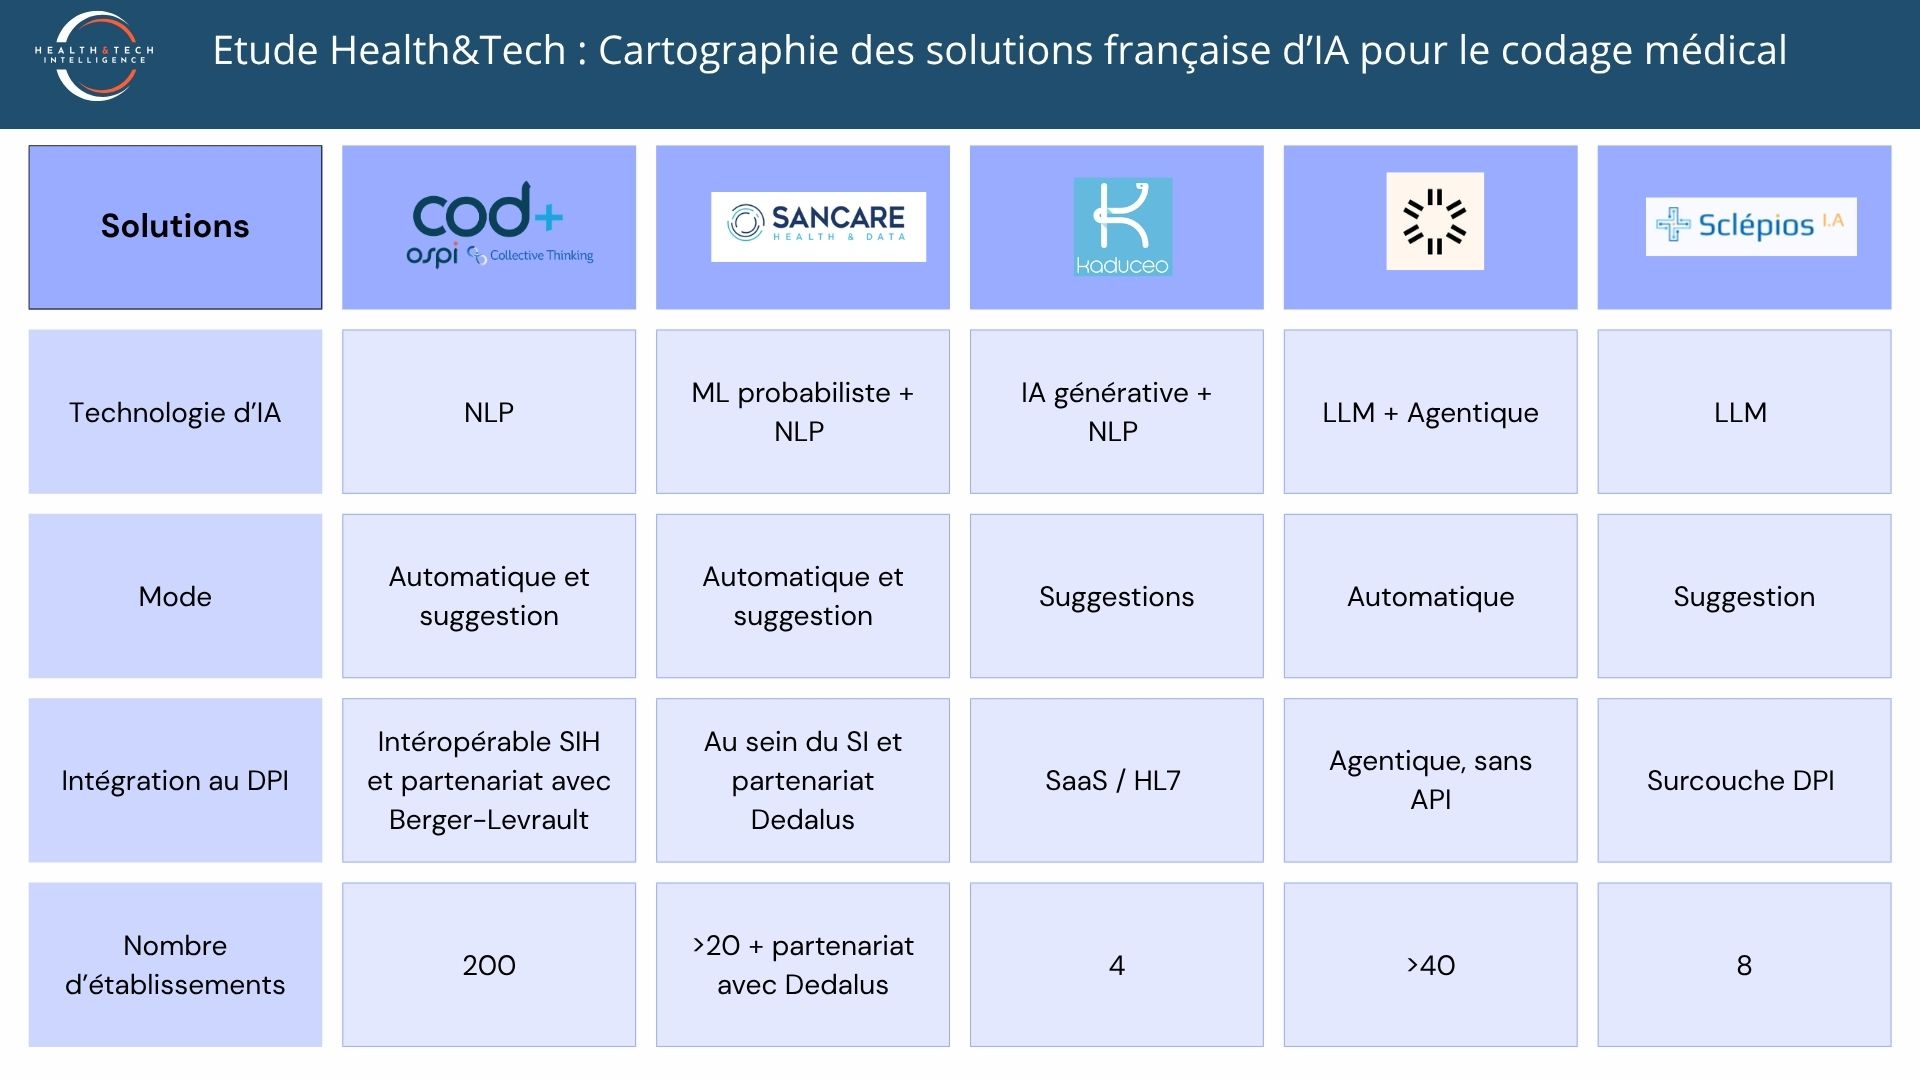
  • Maladies rares : 14 cas d’usage d’IA structurés en 6 catégories, du diagnostic génomique au repositionnement thérapeutique

    Diagnostic génomique automatisé : réduire le temps d’interprétation

    L’analyse des données issues du séquençage haut débit constitue un point de friction dans le diagnostic des maladies rares. Plusieurs solutions visent à automatiser la priorisation des variants génétiques en les comparant à de larges bases de connaissances et en classant les mutations selon leur probabilité de pathogénicité.

    Des plateformes comme SeqOne Platform, STARVar, Congenica AI ou PhenoTips permettent aux équipes de génétique et de médecine interne de converger plus rapidement vers un diagnostic en réduisant la dépendance à l’expertise manuelle dossier par dossier. Dans la même logique, Emedgene optimise l’interprétation des variants en éliminant les variants bénins et en mettant en avant un ensemble restreint de mutations susceptibles d’expliquer le tableau clinique. L’objectif est d’accélérer la confirmation diagnostique et l’orientation vers une prise en charge adaptée.

    Diagnostic phénotypique par analyse d’images : reconnaître les motifs rares

    L’analyse automatisée de photographies cliniques constitue un second levier pour identifier des syndromes rares à partir de caractéristiques morphologiques.

    À l’Hôpital Necker-Enfants malades, le Projet AIDY assiste le diagnostic du syndrome de Kabuki à partir de séries de photographies standardisées du visage et des oreilles. L’algorithme extrait des motifs morphologiques compatibles, afin d’aider les équipes de génétique et de chirurgie maxillo-faciale à repérer plus précocement certains phénotypes. Une publication dans Nature (28 janvier 2024) documente ces travaux.

    Toujours à Necker, DeepGestalt analyse des photographies faciales pour repérer des motifs dysmorphiques associés à différentes maladies rares et proposer des diagnostics à envisager, notamment lorsque l’expertise en génétique clinique est limitée. Face2Gene (aussi de FDNA) combine analyse d’images et données cliniques pour suggérer une liste de syndromes génétiques compatibles avec le profil du patient et homogénéiser l’évaluation phénotypique.

    Enfin, Belle 1k Skin AI exploite des images prises au smartphone par des soignants de première ligne afin de comparer des lésions cutanées à une base de référence couvrant de nombreuses affections rares ou négligées. L’outil génère des diagnostics possibles et aide à décider d’une orientation spécialisée.

    Repérage automatisé dans les dossiers médicaux : détecter les signaux faibles

    Plusieurs projets exploitent les données structurées et non structurées des dossiers médicaux électroniques pour réduire l’errance diagnostique.

    À l’Hôpital Foch et à Gustave Roussy, des algorithmes comme AccelRare et l’Algorithme Codoc analysent comptes rendus, examens et antécédents pour repérer des combinaisons de signes compatibles avec des maladies rares. Au CHU d’Angers, le Projet AXIA parcourt les entrepôts de données hospitaliers, notamment les notes rédactionnelles et comptes rendus d’urgences, afin d’identifier des signaux compatibles avec l’ataxie de Friedreich ou d’autres pathologies apparentées.

    D’autres solutions, comme FindEHR, Saventic Med Platform ou EDS-NLP, calculent des scores de risque à partir des dossiers médicaux électroniques pour signaler des patients susceptibles de présenter une maladie rare systémique. Une étude sur la détection de la maladie de Fabry à partir des EHR rapporte un AUC de 0,998. Un algorithme a également été développé pour repérer des formes suspectes d’iMCD.

    À l’Hôpital Bichat, le moteur « Patient similaire » rapproche un patient de cas déjà documentés en combinant données textuelles, imagerie et informations génétiques, afin d’affiner le diagnostic et d’identifier des cohortes homogènes pour la recherche clinique.

    Aide à la décision clinique structurée : formaliser le raisonnement

    Certains outils visent à structurer la collecte des symptômes et à générer des hypothèses diagnostiques à partir de questionnaires standardisés.

    Des solutions comme MedVir ou SymptomMatcher recueillent les symptômes via un questionnaire structuré, analysent les réponses et proposent une liste de diagnostics potentiels à explorer dans le contexte des maladies rares. Cette approche standardise la collecte de données cliniques et permet de réévaluer périodiquement les hypothèses diagnostiques.

    Stratification du risque et médecine de précision : personnaliser les décisions

    Au-delà du diagnostic initial, l’IA est mobilisée pour affiner la stratification du risque et orienter les décisions thérapeutiques.

    À l’Hôpital Pitié-Salpêtrière, le Projet CardI-HACK intègre données cardiologiques détaillées et informations génétiques, dont des scores de risque polygénique, afin d’estimer le risque individuel de complications chez des patients atteints de cardiomyopathie hypertrophique. Cette estimation aide à décider d’interventions comme l’implantation d’un défibrillateur et à adapter la fréquence du suivi.

    La solution One Biosciences est déployée à l’Hôpital Tenon, à l’Hôpital Necker-Enfants malades, à l’Hôpital Bicêtre, à l’Hôpital Henri-Mondor et à l’Institut Curie. L’analyse de données single-cell permet de caractériser finement la biologie tumorale ou rénale, notamment dans certaines maladies rares du rein et le glioblastome, afin d’identifier des cibles thérapeutiques et de sélectionner des traitements personnalisés.

    Suivi longitudinal et recherche thérapeutique : monitorer et repositionner

    Le suivi des maladies rares s’appuie également sur des biomarqueurs numériques collectés via applications ou capteurs connectés. MSCopilot analyse ces indicateurs cliniques et fonctionnels pour détecter des variations de l’état du patient, ajuster les traitements et améliorer la qualité des données pour la recherche.

    Dans le champ de la recherche hospitalière, des modèles comme TxGNN, Healnet ou Benevolent Platform explorent des jeux de données pharmacologiques, génomiques et cliniques afin d’identifier des similarités entre mécanismes de maladies rares et pathologies déjà traitées. L’objectif est de suggérer des médicaments existants susceptibles d’être repositionnés et de prioriser des pistes à tester.

    Une structuration progressive des usages hospitaliers

    Ces six catégories, du diagnostic génomique à la recherche thérapeutique, montrent que l’IA ne se limite plus à un outil d’aide ponctuel. Elle s’insère à différentes étapes du parcours, du repérage précoce à la décision thérapeutique et au suivi longitudinal. Si les niveaux de validation scientifique et de déploiement restent variables selon les projets, l’ensemble traduit une transformation progressive des pratiques hospitalières autour de l’exploitation systématique des données cliniques, génomiques et phénotypiques.

    <span data-mce-type= »bookmark » style= »width: 0px;overflow: hidden;line-height: 0″ class= »mce_SELRES_start »></span>