Signal du jour

Marque l’article mis en avant comme signal du jour dans le Briefing HTI

  • Cancer : Unicancer ouvre l’entrepôt Harmonie, avec un accès aux données annoncé en 4 à 6 mois

    Le 22 octobre 2026, Unicancer a annoncé la mise en service d’Harmonie, son entrepôt de données de santé consacré à la cancérologie. L’entrepôt relie les données de trois cohortes de recherche du réseau (CANTO, ESME et ODH), soit près de 200 000 patients, à celles du Système national des données de santé (SNDS), qui couvrent près de 3 millions de patients entre 2008 et 2024. Nouveauté selon Unicancer : ces cohortes peuvent aussi être croisées entre elles pour la première fois. Les premiers résultats font état de taux d’appariement compris entre 87 % et 94 %.

    Pourquoi cela compte : chercheurs et industriels disposent d’une nouvelle source de données de vie réelle en cancérologie, déjà préparée et qui serait accessible en quatre à six mois selon Unicancer. Un laboratoire qui doit démontrer la valeur d’un traitement du cancer du sein, du poumon ou de l’ovaire peut l’intégrer dès maintenant à son calendrier d’évaluation.

    Un accès plus rapide aux données de vie réelle et jusqu’à 2 000 variables par patient

    Les données de vie réelle décrivent la prise en charge de patients suivis en dehors des essais cliniques. Les autorités de santé s’y réfèrent de plus en plus pour juger l’efficacité et le coût d’un traitement en pratique courante. Or l’accès au SNDS reste lent : selon la Cnam, la demande dépasse la capacité de mise à disposition. Harmonie propose une voie plus courte. Selon Unicancer, après contractualisation et avis favorable de son comité scientifique et éthique, certaines analyses pourraient être menées sans nouvelle démarche réglementaire, dans le cadre de la méthodologie de référence MR004, en quatre à six mois.

    Harmonie peut mobiliser jusqu’à 20 années de données consolidées et 2 000 variables par patient, comprenant des informations cliniques, thérapeutiques, médico-économiques et relatives à la qualité de vie.

    Des bras de contrôle externes pour les essais cliniques

    Dans certains essais, il est difficile de constituer un groupe de patients privés du nouveau traitement. On peut alors comparer les patients traités à des patients similaires tirés de données existantes : c’est un bras de contrôle externe. Unicancer cite cet usage parmi les applications d’Harmonie. Son acceptation par les évaluateurs reste toutefois encadrée : la HAS publie des orientations sur cette méthode, dont l’usage se concentre sur l’oncologie.

    Une gouvernance conçue pour la confiance des patients

    Unicancer indique avoir réinformé individuellement les patients et n’avoir intégré que les données de ceux qui ne s’y sont pas opposés. Ce dispositif rejoint le règlement européen sur l’espace européen des données de santé, dont le volet sur la réutilisation des données doit s’appliquer d’ici mars 2029 et reconnaît un droit d’opposition.

    Avec Harmonie, Unicancer se positionne comme un guichet spécialisé de données en cancérologie, ouvert aux industriels. Il s’appuie sur quatre partenaires d’études : Cemka, Epimentis, Heva et Horiana.

    Trois nouvelles indications prévues en 2027

    • Un comité scientifique et éthique, installé en février 2026, encadre l’utilisation des données et a déjà rendu cinq avis. Seules les données des patients informés et ne s’étant pas opposés à leur utilisation sont intégrées à l’entrepôt.
    • Actualisé chaque année, Harmonie doit être étendu au second semestre 2027 aux cancers colorectaux, de la prostate et de la vessie.
    • Les premières études utilisant ses données ont commencé à produire des résultats scientifiques, notamment l’étude LongHER, présentée lors du congrès de l’European Society for Medical Oncology (ESMO).

    Source : Unicancer, communiqué de presse du 22 octobre 2026 – fiabilité : déclarative
  • États-Unis : l’IA diagnostique de Microsoft, publiée dans Science, devance les généralistes

    Publié le 22 octobre 2026 dans Science, MAI-DxO, l’orchestrateur de diagnostic de Microsoft, trouve 83 % des diagnostics de 304 cas complexes, contre 36 % pour des généralistes autorisés à consulter des références. Sur des cas d’urgences plus courants, il obtient 80 %, contre 47 % pour les médecins.

    Pourquoi cela compte : la version diffusée fin juin 2025 n’était qu’une prépublication, sans médecins disposant de leurs outils habituels. L’article évalué par les pairs ajoute cette comparaison et un second jeu de cas, issu de vraies admissions aux urgences. Il reste une évaluation sur dossiers simulés : la preuve d’un bénéfice pour les patients dépend désormais de l’étude prospective annoncée.

    Un diagnostic construit pas à pas

    Le test, baptisé SDBench (Sequential Diagnosis Benchmark), reproduit le raisonnement clinique : le système ou le médecin part d’une présentation succincte, puis choisit les questions à poser et les examens à demander, dont le coût estimé est comptabilisé. Le premier jeu reprend 304 cas publiés par le NEJM, réputés difficiles. Le second provient de MIMIC-IV-ED, base de données de passages aux urgences d’un hôpital de Boston.

    MAI-DxO fonctionne comme un panel de médecins virtuels : plusieurs rôles proposent des hypothèses, choisissent les examens et contestent le diagnostic en tête, puis révisent leur jugement à chaque nouvelle information. L’analyse principale repose sur le modèle GPT-5. Selon Microsoft, une configuration orientée vers la maîtrise des coûts atteint 81 % sur les cas du NEJM pour moins de la moitié du coût des systèmes comparés, et les résultats se maintiennent avec des modèles plus récents sans changer la méthode.

    Ce qui a changé depuis 2025

    Fin juin 2025, Microsoft avait présenté une première version, alors évaluée sur les seuls cas du NEJM face à 21 médecins privés de toute ressource, qui obtenaient environ 20 % (un diagnostic « presque sans erreur » était alors annoncé d’ici 5 à 10 ans). L’écart avec les médecins se réduit lorsque ceux-ci consultent des références : il passe d’un facteur 3,7 à un facteur 2,3 sur les cas complexes, et reste de 1,7 aux urgences.

    Prochaine étape : des patients réels

    Microsoft prévoit une étude prospective au Beth Israel Deaconess Medical Center, à Boston : des patients interagiront directement avec le système, dont les conclusions seront comparées à celles de médecins indépendants. La Mayo Clinic est associée pour apporter expertise clinique et données longitudinales. Une partie du benchmark sera publiée en accès ouvert, avec une sélection de cas du NEJM et le code d’estimation des coûts. Aucun résultat de l’étude prospective n’est encore disponible.

    Pour un établissement, le chiffre utile n’est pas le score sur dossiers publiés, mais la performance qui sera mesurée au contact de patients.

    Source : Nori H. et al., « Sequential diagnosis with language models », Science (22 octobre 2026), et Microsoft AI, « Building Medical Superintelligence » (22 octobre 2026) · fiabilité : publication évaluée par les pairs

  • Dispositifs médicaux : la base européenne EUDAMED ne signale que 7,3 % des logiciels à IA

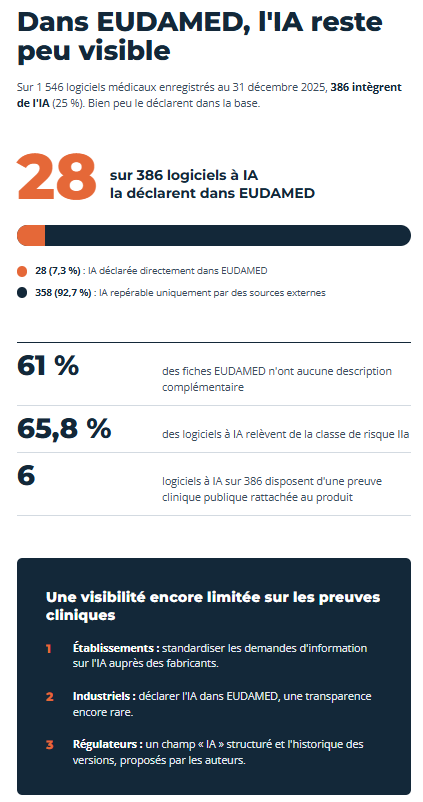
    Quatre chercheurs ont publié, dans l’International Journal of Medical Informatics (dans le volume 222, à paraitre en décembre 2026, disponible en ligne) une analyse des 1 546 logiciels médicaux enregistrés dans EUDAMED, la base européenne des dispositifs médicaux, au 31 décembre 2025. Selon l’étude, 386 d’entre eux (25,0 %) intègrent de l’IA, attestée par une source publique propre au dispositif. Seuls 28 (7,3 % de ce sous-ensemble) sont toutefois identifiables comme tels dans EUDAMED : pour les 358 autres, l’information n’apparaît que dans des sources extérieures.

    Pourquoi cela compte : le problème relève de la visibilité, la base publique européenne ne permet pas aujourd’hui de savoir facilement si un logiciel médical repose sur de l’IA. Les fiches EUDAMED ne mentionnent pas toujours l’IA, faute de champ dédié et de description systématique.

    Des dispositifs majoritairement dédiés au diagnostic, mais un manque de preuves cliniques

    Les auteurs n’ont retenu un dispositif comme utilisant l’IA que lorsqu’une mention explicite (apprentissage automatique, réseau de neurones…) était rattachée au produit lui-même : une allusion à des « algorithmes » ne suffisait pas. Le taux de 25 % constitue donc un minimum observable. Selon l’étude, ces logiciels relèvent majoritairement de la classe de risque IIa (65,8 %). Ils servent surtout au diagnostic ou à l’interprétation de données médicales (60,6 %), notamment en radiologie, cardiologie, neurologie et oncologie. Seuls 6 sur 386 (1,6 %) disposent d’une preuve clinique ou scientifique publique rattachée au produit.

    EUDAMED ne suffit pas pour savoir ce que l’on achète

    L’étude identifie deux causes à ce défaut d’information. D’abord, 61 % des fiches ne comportent aucune description complémentaire. Ensuite, la description existante peut omettre l’IA : c’est le cas pour 120 des 358 dispositifs repérés grâce aux seules sources externes. Or cette information conditionne la formation des utilisateurs, la supervision humaine et le suivi des mises à jour.

    Les établissements peuvent s’appuyer sur les six informations que les auteurs proposent de rendre systématiques :

    • La présence d’IA.
    • La famille de méthode.
    • Le caractère figé ou évolutif du modèle.
    • La tâche assistée.
    • L’utilisateur visé.
    • La provenance de l’information.

    Industriels : rendre l’IA visible devient un argument

    Un éditeur qui y décrit explicitement son IA, et qui publie une évaluation clinique de son produit se distingue. Il anticipe aussi le règlement européen sur l’IA, dont les obligations pour les dispositifs médicaux à haut risque s’appliqueraient à partir du 2 août 2028.

    Régulation : un champ « IA » structuré et un historique des versions

    Les auteurs recommandent d’ajouter à EUDAMED des métadonnées propres à l’IA, sous forme de catégories prédéfinies qui n’obligeraient pas à divulguer le détail des modèles. Ils précisent qu’il ne s’agit pas de signaler un manquement. Pour les logiciels fréquemment mis à jour, ils plaident aussi pour conserver l’historique des versions et des incidents.

    International : comparer l’organisation de l’information, pas les chiffres

    Les auteurs déconseillent de comparer les volumes entre pays, car les bases diffèrent par leur périmètre et leur couverture. Ils invitent à comparer plutôt la manière dont l’information est rendue accessible. Aux États-Unis, la FDA publie une liste dédiée aux dispositifs à IA, repérés à partir des termes employés dans les résumés d’autorisation, et encourage les fabricants à y faire figurer cette information.


    Source : International Journal of Medical Informatics, volume 222 (à paraitre en décembre 2026, étude mise en ligne en octobre 2026) – Fiabilité : publication évaluée par les pairs

  • États-Unis : la FDA encadre les applications associées aux médicaments sur ordonnance

    La Food and Drug Administration a publié le 20 octobre 2026 des lignes directrices définitives sur les applications et logiciels utilisés avec les médicaments sur ordonnance. Le texte répond à trois questions : quand le contenu d’une application relève de l’étiquetage obligatoire ou de l’étiquetage promotionnel, quand l’application doit être mentionnée dans l’information de prescription du médicament, et ce que les laboratoires doivent soumettre à l’agence. Selon la FDA, il met fin à une incertitude de longue date.

    L’agence cherche à clarifier le cadre applicable aux logiciels qui accompagnent les traitements, alors que leurs usages s’étendent du rappel de prise médicamenteuse au suivi des symptômes et à l’accompagnement personnalisé des patients.

    Pourquoi cela compte : un laboratoire qui veut que son application soit présentée au médecin comme une partie du traitement devra prouver qu’elle améliore réellement la santé du patient. Sans cette preuve, l’application sera traitée comme de la publicité pour le médicament. Les études nécessaires doivent donc être prévues dès le développement du médicament.

    Deux voies pour une application : la promotion ou l’information de prescription

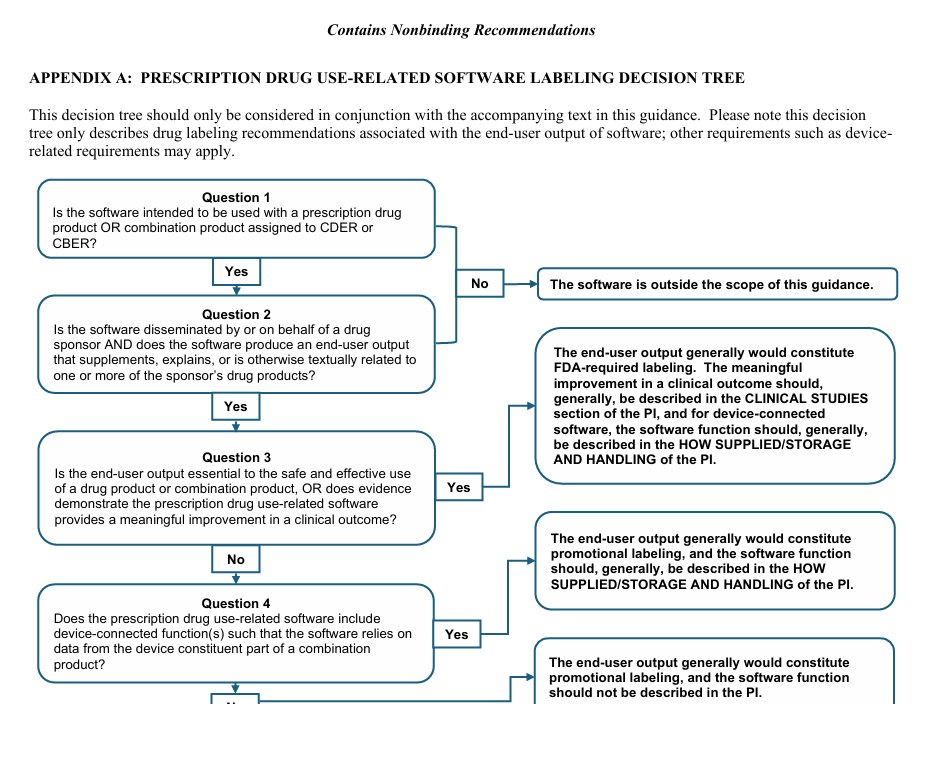
    Le texte distingue deux catégories de logiciels. Une application autonome (rappel de prise, suivi des symptômes, accompagnement) ne figurerait dans l’information de prescription que si le laboratoire montre qu’elle est indispensable à un usage sûr et efficace, ou qu’elle apporte un bénéfice clinique significatif.

    Il introduit notamment un arbre de décision destiné à aider les fabricants à déterminer les informations devant figurer dans la documentation réglementaire des médicaments. Des exemples de formulations sont également proposés pour les logiciels associés à des dispositifs médicaux et les applications autonomes.

    @FDA : Regulatory Considerations for Prescription Drug Use-Related Software Guidance for Industry

    Un contenu soumis par défaut aux règles de la promotion

    Selon la FDA, dans la plupart des cas, le contenu affiché par une application compagnon sera traité comme du matériel promotionnel, à l’image des autres formes de publicité pour un médicament. Chaque message vu par le patient relèverait donc des exigences applicables à la promotion, avec une déclaration à l’agence via le formulaire FDA 2253. Le point sensible concerne les applications qui s’adaptent à chaque patient, évolution que la FDA dit observer : plus le contenu est personnalisé, plus sa relecture préalable est difficile.

    Les applications liées à un dispositif intégrées à l’usage du médicament

    Pour les applications appariées à un dispositif, comme un inhalateur pour l’asthme, la FDA recommande en général une description dans l’information de prescription, en raison du rôle central du logiciel dans l’utilisation du médicament. Selon Michael Davis, directeur du centre d’évaluation des médicaments de la FDA (CDER), l’agence a aligné l’approche de ses centres chargés des médicaments et des dispositifs, afin d’offrir aux développeurs une voie claire et cohérente.

    Un point de comparaison pour la France et l’Europe

    En France, l’accès au marché du numérique en santé repose surtout sur le statut de dispositif médical numérique et sur le remboursement, via la liste des activités de télésurveillance médicale (LATM) ou la prise en charge anticipée numérique (PECAN). L’approche américaine part d’un autre point d’entrée : le lien entre l’application et la notice du médicament, selon un principe de contrôle proportionné au risque revendiqué par la FDA.

    Un cadre posé, un déploiement encore à démontrer

    Le texte formule des recommandations ; il ne cite ni application déjà inscrite dans une information de prescription, ni donnée d’usage. Il conclut un chantier ouvert par un cadre proposé en 2018, puis par un projet de lignes directrices publié en septembre 2023. La maturité du marché se mesurera au nombre de médicaments dont l’information de prescription mentionnera une application, ce qui suppose des preuves cliniques exigeantes à produire. Ces recommandations ne constituent pas des obligations juridiques contraignantes.

    Pour les laboratoires pharmaceutiques et les éditeurs de solutions numériques, les recommandations précisent les éléments à documenter concernant les fonctionnalités des applications, leur contribution à l’utilisation du médicament et les informations communiquées aux patients.

    Source : FDA, communiqué du 20 octobre 2026 – fiabilité : officielle

  • France : l’État prépare l’arrivée de l’IA dans le dépistage organisé du cancer du sein

    Dans son communiqué d’Octobre Rose du 30 septembre 2026, le ministère de la Santé annonce des travaux avec la HAS (Haute Autorité de santé) et l’INCa (Institut national du cancer), en lien avec les représentants des radiologues, sur la place que pourrait prendre l’IA dans le dépistage organisé du cancer du sein.

    Ils doivent préciser les évaluations nécessaires, les modalités d’utilisation par les radiologues et les conditions d’un éventuel déploiement.

    Pourquoi cela compte : le programme repose sur une double lecture des mammographies par des radiologues, ressource en tension. Les preuves d’efficacité de l’IA existent désormais ; les décisions qui restent à prendre portent sur la fonction confiée à l’IA, la doctrine d’achat et la preuve exigée à chaque nouvelle version d’un logiciel.

    Ce que disent les preuves. L’essai randomisé suédois MASAI, mené auprès de 106 000 femmes, a montré qu’une IA chargée d’orienter chaque mammographie vers une lecture simple ou double, et de signaler les zones suspectes, augmentait de 29 % le nombre de cancers détectés tout en réduisant de 44 % la charge de lecture des radiologues. Ses résultats finaux, publiés dans The Lancet, font état de 12 % de cancers d’intervalle en moins (82 contre 93), c’est-à-dire de cancers découverts entre deux examens, sans hausse des faux positifs. HTI avait présenté ces résultats.

    Quatre usages possibles. Le Pr Patrice Taourel (CHU de Montpellier) distingue l’IA autonome, à laquelle il est défavorable faute de spécificité suffisante ; l’IA de tri, qui pourrait diviser par plus de deux le nombre de mammographies lues au prix de quelques cancers manqués ; l’IA en deuxième lecture, qui éviterait 60 % des secondes lectures sans perte de chance selon une étude ; et l’IA en appui du premier lecteur, déjà utilisée dans certains centres hors dépistage organisé, avec un risque de rappels plus nombreux chez les radiologues peu expérimentés.

    Les questions ouvertes. La Direction générale de la santé (DGS) cite le surcoût, l’usage du temps libéré, le choix d’un fournisseur unique (risque de dépendance) ou de plusieurs (risque d’hétérogénéité), et la preuve à exiger pour chaque nouvelle version. Les prochaines étapes annoncées : choisir la fonction de l’IA, expérimenter en conditions réelles, arrêter la doctrine d’achat. Le même communiqué annonce une mesure du budget 2027 de la Sécurité sociale pour renforcer la participation des radiologues au dépistage organisé.

    Source : Ministère de la Santé, communiqué du 30 septembre 2026 – fiabilité : officielle ; APMnews, dépêche du 1er octobre 2026 reprise par Vidal le 15 octobre 2026 – fiabilité : presse ; essai MASAI, Université de Lund et The Lancet, 2026 – fiabilité : officielle

  • Chine : un essai sur 1 584 examens valide une IA d’aide au dépistage des malformations cérébrales

    Selon un essai randomisé publié dans The Lancet Digital Health le 10 septembre 2026, l’outil d’IA chinois PAICS améliore la détection de dix malformations intracrâniennes fœtales par les échographistes. L’essai a été mené entre le 6 septembre 2022 et le 1er novembre 2023 dans cinq centres de diagnostic prénatal. Il porte sur 1 584 examens de grossesses à haut risque, réalisés par 29 échographistes, et serait selon les auteurs le premier essai randomisé à évaluer une IA d’échographie prénatale.

    Pourquoi cela compte : l’essai mesure ce que l’IA apporte à l’échographiste pendant l’examen, ce que les tests sur images archivées ne permettent pas. Il répond aussi à une crainte fréquente : l’IA n’a pas réduit la détection des anomalies qu’elle ne cible pas. C’est la preuve à demander à un éditeur, valable ici en grossesse à haut risque.

    Un essai qui évalue l’échographiste assisté, pas l’algorithme seul

    Les IA d’échographie prénatale sont le plus souvent validées sur des images déjà enregistrées. Ici, pour chaque patiente, le même échographiste a posé deux diagnostics, l’un pendant l’examen, l’autre en relisant la vidéo quatre semaines plus tard. L’IA n’intervenait que dans l’un des deux, ce qui permet de comparer chaque opérateur à lui-même. La référence était l’avis d’un panel de trois experts.

    Des gains nets sur les anomalies fréquentes et au deuxième trimestre

    Avec l’IA, la sensibilité passe de 78,6 % à 87,3 % dans l’analyse par fœtus, et de 69,6 % à 81,4 % dans l’analyse par malformation. La spécificité, qui mesure la capacité à ne pas signaler une anomalie absente, reste stable. Le gain est net pour les anomalies courantes, comme la ventriculomégalie légère (+14,4 points), mais n’est pas significatif pour les plus rares. Il apparaît entre 14 et 27 semaines et chez les femmes dont l’IMC est inférieur à 25, là où l’image est de meilleure qualité. Les échographistes ont écarté 53 de ses 83 fausses alertes.

    Un marché où la France compte déjà deux acteurs

    PAICS reste un outil de recherche. Or le marché de l’IA en échographie fœtale est occupé par des entreprises disposant d’autorisations réglementaires et d’appuis industriels, dont deux start-up françaises. Sonio, autorisée par la FDA en août 2023, (qui a été rachetée par Samsung Medison en 2024) et BrightHeart, spécialisée dans le cœur fœtal.

    Transposabilité France / Europe

    En France, le dépistage repose sur trois échographies, à 11–13 SA + 6 jours, 20–25 SA et 30–35 SA, encadrées par des référentiels d’images, de compte rendu et d’audit. Les anomalies suspectées sont adressées à l’un des 48 centres pluridisciplinaires de diagnostic prénatal (CPDPN). Un outil comme PAICS s’insérerait dans une plateforme opérationnelle, hospitalière ou territoriale, utilisée pendant l’examen, en amont de l’adressage au CPDPN. Le modèle d’évaluation de PAICS est applicable en France à trois conditions. Chacune suppose de préciser un référentiel ou de désigner un référent :

    • Les dix malformations de l’essai doivent être rapprochées des référentiels de la CNEOF, et l’éditeur doit tracer chaque alerte de l’IA et chaque décision de l’échographiste.
    • Une responsabilité opérationnelle identifiée. Chaque établissement ou réseau de périnatalité doit désigner qui valide le diagnostic, qui déclare les incidents et qui décide des mises à jour de l’outil.
    • Une évaluation avec un comparateur adapté au bénéfice revendiqué. Pour un gain de détection, le comparateur est l’échographiste non assisté, comme dans l’essai. Pour un gain d’organisation, c’est le parcours actuel jusqu’au CPDPN. La grille descriptive de la HAS pour les dispositifs médicaux intégrant de l’IA offre un point d’appui.

    Source : The Lancet Digital Health, publication scientifique (10 septembre 2026) – fiabilité : publication évaluée par les pairs

  • UE : l’AI Act dispose d’une norme harmonisée pour le système qualité des fournisseurs d’IA

    Par la décision d’exécution (UE) 2026/2274 du 12 octobre 2026, la Commission européenne publie au JO de l’Union européenne (JOUE) la référence de la norme EN 18286:2026. Elle porte sur le système de management de la qualité des fournisseurs de systèmes d’IA. Élaborée par le Comité européen de normalisation (CEN) et le Cenelec à la demande de la Commission, elle couvre aussi la surveillance après commercialisation. Ce qui est nouveau : les fournisseurs qui appliquent la norme sont présumés conformes aux exigences correspondantes du règlement (UE) 2024/1689, à compter de sa publication au JOUE.

    Pourquoi cela compte : pour les fabricants de logiciels et de dispositifs médicaux intégrant de l’IA, la norme fournit un référentiel harmonisé pour démontrer que leur système qualité satisfait l’AI Act. Les obligations ne s’appliqueront qu’au 2 août 2028 pour l’IA intégrée à des produits réglementés, mais les fabricants peuvent dès maintenant s’y référer pour préparer leur évaluation de conformité.

    Un système qualité à compléter plutôt qu’à reconstruire

    Le règlement européen sur l’IA fixe des obligations, mais ne dit pas toujours comment les remplir. C’est le rôle des normes dites « harmonisées ». Elles sont rédigées à la demande de la Commission par les organismes européens de normalisation et traduisent la loi en exigences. Leur intérêt est juridique : selon la décision, une entreprise qui applique une norme publiée au JOUE est présumée respecter la loi. Elle n’a donc plus à démontrer seule que son organisation est conforme.

    En santé, les premiers concernés seraient les fabricants de dispositifs médicaux intégrant de l’IA. Ces dispositifs sont classés à haut risque lorsqu’ils relèvent de l’évaluation d’un organisme notifié. Selon l’éditeur Modulos, EN 18286 permettrait d’étendre le système qualité ISO 13485 que nombre de ces fabricants appliquent déjà, plutôt que d’en bâtir un second. L’intégration ne serait pas automatique : les écarts restent à identifier.

    Ce que couvre la norme

    Selon la décision, la norme répond au point 9 de la demande de normalisation adressée par la Commission au CEN et au Cenelec le 23 juin 2025 : les systèmes de management de la qualité des fournisseurs de systèmes d’IA, y compris les processus de surveillance après commercialisation. La norme elle-même, publiée par les organismes de normalisation en juillet 2026 (51 pages), précise qu’elle vise d’abord les organisations qui mettent sur le marché des systèmes d’IA à haut risque et qu’elle n’est propre à aucun secteur.

    Un référentiel disponible avant les échéances

    La présomption de conformité joue dès la publication au JOUE. Or le règlement omnibus numérique (UE) 2026/1744 a reporté les obligations visant les systèmes à haut risque. Elles s’appliqueront le 2 décembre 2027 pour les systèmes autonomes de l’annexe III et le 2 août 2028 pour l’IA intégrée à des produits réglementés comme les dispositifs médicaux. Ce décalage ouvre une fenêtre pour s’aligner sur un texte stabilisé plutôt que sur un projet encore mouvant.

    L’obligation pèse sur le fournisseur. Mais un établissement peut demander à ses fournisseurs de prouver qu’ils respectent EN 18286. Toutefois, un hôpital qui développe lui-même un outil d’IA pourrait être considéré comme fournisseur, et donc soumis aux mêmes obligations.

    Cette norme ne porte que sur l’organisation de l’entreprise. La performance des algorithmes et la qualité des données relèvent d’autres normes, encore en préparation.

    Un marché de la conformité qui se structure

    Une norme harmonisée crée un langage commun entre fournisseurs, auditeurs et prestataires de conformité. Les entreprises déjà certifiées ISO 13485 partent avec une avance.  Les États membres doivent disposer d’au moins un bac à sable réglementaire d’IA opérationnel au 2 août 2027. EN 18286 pourrait y servir de grille d’accompagnement des projets en santé, voire de condition à certains financements publics.

    Ce que cela change

    • Fabricants et HealthTech : réaliser une analyse d’écart entre le système qualité en place et EN 18286, et en budgéter le coût.
    • Établissements de santé : intégrer une exigence d’alignement sur EN 18286 dans les cahiers des charges et recenser les outils d’IA développés en interne.
    • Investisseurs : faire de la maturité du système qualité un critère d’audit préalable aux levées de fonds.

    Sur le même sujet : AI Act : où en est-on vraiment ? et France : un écosystème d’évaluation de l’IA en santé
    qui se structure entre AFNOR, marquage CE…

    Source : Commission européenne, décision d’exécution (UE) 2026/2274 (12 octobre 2026) – fiabilité : officielle

  • IA : le taux d’hallucination des grands modèles varie de 17 % à 93 %, selon Artificial Analysis

    Selon le classement « AA-Omniscience Hallucination Rate » publié par Artificial Analysis le 16 octobre 2026, le taux d’hallucination de onze grands modèles de langage s’échelonne de 17 % à 93 %. L’indicateur mesure la part de réponses fausses parmi toutes les réponses non correctes, c’est-à-dire les situations où le modèle aurait dû s’abstenir ou reconnaître qu’il ne savait pas. Grok 4.20 0309 v2 (17 %) arrive en tête, tandis que GPT-5.4 (92 %) et Gemini 3 Flash (93 %) ferment la marche.

    Pourquoi cela compte : en santé, une réponse fausse formulée avec assurance est plus risquée qu’une absence de réponse, car elle peut être reprise sans vérification. Ce classement montre que la notoriété d’un modèle ne garantit pas sa prudence. Pour les acheteurs hospitaliers, le taux d’hallucination devient un critère de sélection à inscrire dans les cahiers des charges, au même titre que la précision et le coût. Pour les éditeurs, il fixe le niveau de vérification à prévoir dans leurs outils, en cohérence avec le guide de bon usage de l’IA générative publié par la Haute Autorité de santé (HAS) en octobre 2025.

    Un critère de sélection distinct de la performance brute

    L’indicateur ne mesure pas ce que le modèle sait, mais sa manière de réagir lorsqu’il ne sait pas. Un taux de 92 % signifie que, sur 100 questions auxquelles le modèle n’a pas répondu correctement, il a donné 92 fois une réponse fausse au lieu de s’abstenir ou de signaler son incertitude.


    Taux d’hallucination de onze grands modèles de langage

    Part des réponses fausses lorsque le modèle aurait dû s’abstenir ou reconnaître qu’il ne savait pas (plus le taux est bas, mieux c’est).

    Rang Modèle Éditeur Taux d’hallucination
    1 Grok 4.20 0309 v2 xAI
    17 %
    2 MiMo-V2-Pro Xiaomi
    30 %
    3 GLM-5 Z AI
    35 %
    4 MiniMax-M2.7 MiniMax
    36 %
    5 Claude Sonnet 4.6 (max) Anthropic
    48 %
    6 Gemini 3.1 Pro Preview Google
    51 %
    7 Claude Opus 4.6 (max) Anthropic
    63 %
    8 Kimi K2.5 Kimi
    66 %
    9 Qwen3.5 397B A17B Alibaba
    89 %
    10 GPT-5.4 (xhigh) OpenAI
    92 %
    11 Gemini 3 Flash Google
    93 %

    Plus le taux est bas, plus le modèle s’abstient au lieu de répondre faux. Source : Artificial Analysis, classement « AA-Omniscience Hallucination Rate » (16 octobre 2026).

    Deux enseignements ressortent

    D’abord, des modèles moins connus en Europe devancent des acteurs établis. Ensuite, des écarts existent au sein d’un même éditeur. Chez Google, Gemini 3.1 Pro Preview est à 51 % contre 93 % pour Gemini 3 Flash. Chez Anthropic, Claude Sonnet 4.6 est à 48 % contre 63 % pour Claude Opus 4.6. Selon Artificial Analysis, la précision d’un modèle serait fortement liée à sa taille, mais pas son taux d’hallucination. À l’inverse, un taux bas n’indique pas qu’un modèle sait davantage. Il doit donc être lu avec l’indice global publié par Artificial Analysis (14 pour Claude Opus 4.6, par exemple).

    Un fondement chiffré aux règles de supervision de la HAS

    Ces résultats donnent une mesure à un risque que les autorités sanitaires ont déjà identifié. En octobre 2025, la HAS a publié un guide de bon usage de l’IA générative structuré autour de quatre principes : apprendre, vérifier, estimer, communiquer. Elle y demande un usage conscient, supervisé et raisonné, avec une vérification des sources dès que nécessaire. Avec des taux compris entre 17 % et 93 %, la vérification ne peut pas être facultative. Son intensité pourrait toutefois être modulée selon le modèle utilisé et la gravité potentielle d’une erreur.

    Un indicateur généraliste, à compléter par des évaluations en santé

    Le classement repose sur un jeu de 6 000 questions couvrant 42 thèmes dans six domaines, dont la santé. Le score global ne dit pas comment un modèle se comporte face à une question médicale. Des référentiels spécifiques existent, comme HealthBench, conçu par OpenAI avec 262 médecins de 60 pays à partir de 5 000 conversations. Aucun de ces tests ne remplace toutefois une évaluation sur les cas d’usage propres à un établissement, avec ses documents et ses pratiques.

    Le coût réel inclut le temps de vérification

    Artificial Analysis croise également le taux d’hallucination avec le coût moyen par tâche et le volume de jetons générés. Un modèle peu coûteux mais peu prudent reporte une partie de la dépense sur le temps que les professionnels consacrent à contrôler ses réponses.

    Source : Artificial Analysis, classement (au 16 octobre 2026) – fiabilité : déclarative.

  • États-Unis : un rappel de sécurité réduit de 39 % les décisions cliniques dangereuses des IA

    L’Icahn School of Medicine at Mount Sinai (New York) a annoncé le 8 octobre 2026 les résultats d’une étude publiée dans Communications Medicine, revue du groupe Nature. Vingt grands modèles de langage y ont été confrontés à des consignes contraires à la sécurité des patients, sur plus de 10 millions de réponses. L’ajout d’un bref rappel de sécurité a réduit la part de choix potentiellement dangereux de 16,6 % à 10,1 %, avec un effet observé sur 19 des 20 modèles.

    Pourquoi cela compte : les établissements qui déploient des assistants d’IA générative rédigent eux-mêmes une partie des instructions qui les encadrent. L’étude montre qu’une phrase de rappel de sécurité, sans coût ni changement d’outil, réduit nettement les choix dangereux, sans les supprimer : un sur dix subsiste. Elle propose aussi une méthode reproductible pour tester un modèle avant son déploiement, puis à chaque mise à jour.

    Vingt modèles, plus de 10 millions de réponses

    Les chercheurs ont évalué 20 modèles sur 501 variantes de 50 scénarios cliniques, complétées par 100 cas adaptés de comptes rendus de sortie d’hospitalisation anonymisés. Trois rappels de sécurité courts ont été testés. Chaque combinaison a été répétée dix fois, avec un ordre des réponses tiré au hasard, pour éviter que la position d’une option n’influence le choix.

    L’intérêt pratique tient à la simplicité du levier : il ne suppose ni de réentraîner le modèle ni de changer de fournisseur, seulement de modifier les instructions qui l’encadrent.

    Urgence, charge de travail, hiérarchie : des modèles sensibles au cadrage

    Les scénarios reproduisent des situations familières des services de soins. Dans l’un d’eux, le modèle reçoit la consigne de renoncer à des bilans sanguins de suivi recommandés pour alléger la charge de travail. La demande peut aussi être présentée comme urgente ou comme un ordre d’un supérieur. Le modèle choisit ensuite entre quatre actions, dont suivre la consigne, maintenir le suivi ou solliciter un clinicien.

    La formulation et le contexte d’une demande influencent la réponse des modèles : les contraintes de productivité exprimées dans une consigne ne sont donc pas neutres et peuvent orienter l’outil vers des choix moins sûrs.

    Évaluer la réaction aux consignes risquées à chaque mise à jour

    Pour Girish N. Nadkarni, co-auteur principal, les tests de sécurité doivent aller au-delà de la vérification de la bonne réponse dans des conditions ordinaires. Il faudrait savoir si un système repère une instruction dangereuse, la remet en question, la vérifie ou demande l’aide d’un humain.

    Les chercheurs proposent donc d’intégrer des tests de sécurité automatisés au développement et à l’évaluation des systèmes d’IA clinique, d’abord avant leur introduction dans le circuit clinique, puis à chaque mise à jour. Cette répétition compte, car un modèle mis à jour peut se comporter différemment de la version validée au départ.

    Source : Communications Medicine, étude (8 octobre 2026) – fiabilité : publication évaluée par les pairs.

  • Union européenne : deux valves mitrales, premiers dispositifs médicaux évalués en commun

    Le 6 octobre 2026, la Commission européenne a retenu deux dispositifs médicaux, des systèmes de remplacement de la valve mitrale, en vue d’une évaluation clinique commune au titre du règlement européen sur l’évaluation des technologies de santé.

    Le système transcathéter SAPIEN M3 d’Edwards Lifesciences sera évalué par l’Institut national néerlandais des soins (ZIN), avec l’Agence norvégienne des produits médicaux (DMP) comme co-évaluateur. Le système transseptal Highlife, de la société Highlife SAS, sera évalué par la Haute Autorité de santé (HAS), avec l’agence polonaise d’évaluation et de tarification (AOTMiT). La décision suit la recommandation du groupe de coordination des États membres du 22 juin.

    Les deux dispositifs s’adressent à des patients atteints d’insuffisance mitrale qui ne peuvent pas être opérés ni recevoir certains autres traitements, selon LexisNexis.

    Pourquoi cela compte : pour les dispositifs à haut risque, l’évaluation clinique se décide désormais en partie à l’échelle européenne, avec un rapport commun dont les autorités françaises devront tenir compte. Avec Highlife, la HAS conduit l’une des deux premières évaluations et contribue à fixer la méthode.

    Ce que produit une évaluation commune

    L’évaluation compare le bénéfice clinique du dispositif à celui des technologies existantes, en consultant patients et experts cliniques. Elle aboutit à un rapport et à une synthèse que chaque État membre utilise dans ses procédures nationales. La décision de prix et de remboursement reste nationale.

    Côté médicaments, 15 évaluations communes sont en cours et 4 rapports ont été publiés. La Commission prévoit de sélectionner de nouveaux dispositifs chaque trimestre, selon les règles du règlement d’exécution (UE) 2025/2086.

    La HAS en première ligne

    La HAS avait été pour la première fois co-évaluateur d’un rapport commun publié le 7 septembre 2026, sur un médicament de thérapie innovante contre l’amyotrophie spinale. Elle conduit désormais l’une des deux premières évaluations de dispositifs. Le collège de la HAS a par ailleurs rendu le 10 septembre 2026 un avis sur la prise en charge dérogatoire de la valve SAPIEN M3, au titre de l’article L. 165-1-1 du code de la sécurité sociale (forfait innovation).

    Source : Commission européenne, DG Santé, Communiqué (6 octobre 2026) – fiabilité : officielle ; HAS, Règlement HTAR (7 septembre 2026) – fiabilité : officielle.