
LLM en santé : trop d’évaluations automatisées
Les LLM ont déjà largement pénétré le domaine de la santé. Aide à la décision clinique, surveillance des patients, évaluation des risques… en traitant et en analysant de grandes quantités de données de santé, leurs applications sont multiples. Par conséquent, leur évaluation est cruciale. Et des évaluations humaines s’avèrent essentielles pour garantir leur sécurité et leur efficacité. C’est pourquoi des chercheurs américains de l’université de Pittsburgh ont passé en revue 142 articles scientifiques sur les méthodes d’évaluation des LLM en santé, dont les résultats ont été publiés le 28 septembre dans Nature Digital Medicine.
Les études examinées dans le cadre de cette revue de la littérature ont présenté un éventail diversifié d’applications des LLM dans le domaine de la santé, de la recherche fondamentale à la pratique clinique et au-delà, visant chacune à améliorer différents aspects :
- des soins aux patients et de la pratique clinique ;
- de la recherche en sciences biomédicales et de la santé ;
- ainsi que de l’éducation.
Une revue systématique sur 142 articles :
Les types et tailles d’échantillons, la sélection et le recrutement des évaluateurs, les cadres et les métriques, le processus d’évaluation et le type d’analyse statistique sont passés au peigne fin. La littérature scientifique actuelle montre que l’évaluation des LLM dans le domaine de la santé repose essentiellement sur des métriques automatisées. Des d’analyses complètes avec des évaluateurs humains font clairement défaut. Plusieurs équipes de recherche ont donc déjà proposé d’améliorer ces méthodes d’évaluation, proposant un cadre standardisé. Cependant, aucune de ces directives n’aborde spécifiquement l’évaluation humaine des LLM en santé.
C’est pourquoi cette équipe de chercheurs américains (Tam, T.Y.C., Sivarajkumar, S., Kapoor, S. et al.) a mené une revue systématique de la littérature existante sur le sujet.
Résultats : la radiologie, 1re consommatrice de LLM
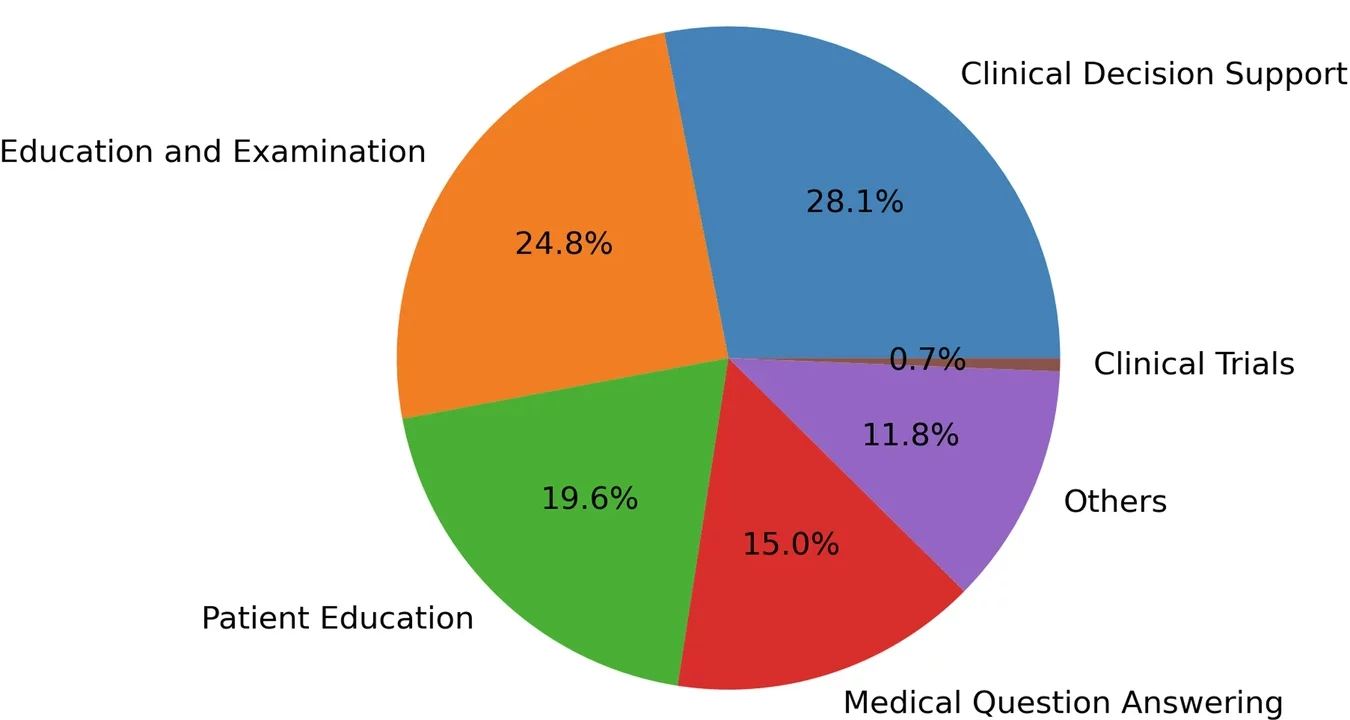
- Les LLM sont surtout utilisés en santé dans les domaines suivants : 28,1% aide à la décision, 24,8% examens, 19,6% éducation des patients, 15% questions-réponses entre patients et médecins
- Les tâches administratives et le soutien en santé mentale, représentent chacune moins de 11,8 % du total.
- La radiologie est la spécialité qui utilise le plus les LLM, suivie de l’urologie et de la chirurgie générale.
- En radiologie, l’évaluation humaine joue un rôle crucial dans l’évaluation de la qualité et de la précision des rapports générés. Elle permet également d’évaluer l’utilité clinique et l’interprétabilité des résultats produits par les LLM.
- En chirurgie générale, l’évaluation humaine se concentre sur l’application pratique des LLM dans la planification préopératoire, les simulations chirurgicales et les soins postopératoires.
- En médecine d’urgence, l’évaluation humaine se concentre souvent sur la prise de décision critique et le soutien au triage.
Des “boîtes noires” qui restent obscures :
Par ailleurs, les chercheurs ont observé que le fonctionnement interne de ces modèles reste opaque, autrement dit, ce sont encore des “boîtes noires”. Les articles que nous avons examinés montrent que les évaluations de ces modèles “boîtes noires” reposent généralement sur des tests manuels via une évaluation humaine, ce qui met en lumière un problème majeur : le manque de traçabilité, de fiabilité et de confiance. « Les sources des textes, les processus de raisonnement utilisés dans les réponses générées, et la fiabilité des preuves à des fins médicales ne sont souvent pas transparents », regrettent les auteurs de l’étude. La plupart des études ont utilisé de petits échantillons et une diversité limitée d’évaluateurs, ce qui affecte la robustesse des évaluations, en particulier pour les applications à haut risque comme le soutien à la décision clinique. Il n’est donc pas toujours possible de savoir clairement d’où viennent les informations, comment les modèles prennent leurs décisions, ou si ces informations sont fiables pour un usage médical. De telles lacunes présentent « un risque d’évaluations incohérentes et peu fiables, ce qui pourrait compromettre la sécurité des patients ».
A la recherche d’un cadre d’évaluation des LLM :
De plus, les méthodes traditionnelles d’évaluation en traitement automatique du langage sont jugées « sous optimales » et « inadéquates » pour les LLM. Par conséquent, les chercheurs de Pittsburgh proposent des lignes directrices pour l’évaluation humaine des LLMs. Ils suggèrent de mettre en place une méthode d’évaluation standardisable. QUEST est conçue sur cinq principes d’évaluation : Qualité de l’information, Compréhension et Raisonnement, Style d’expression et Persona, Sécurité et Risques, et Confiance et Assurance. Les auteurs reconnaissent que ce cadre présente malgré tout des limites, notamment liées aux contraintes spécifiques des sous-spécialités et/ou des institutions susceptibles de l’adopter. Sa généralisation n’est donc pas évidente, d’autant que « les politiques institutionnelles, les infrastructures technologiques, les ressources et la disponibilité du personnel qualifié en informatique varient considérablement, compliquant davantage la mise en œuvre », concluent ces derniers.
* A framework for human evaluation of large language models in healthcare derived from literature review.
Tam, T.Y.C., Sivarajkumar, S., Kapoor, S. et al.
npj Digit. Med. 7, 258 (2024). https://doi.org/10.1038/s41746-024-01258-7