VERDU BISSI Alexandre

  • Données de santé synthétiques : une promesse à l’épreuve du réel

    Données de santé synthétiques : une promesse à l’épreuve du réel

    Article 1 – Données de santé synthétiques : d’un concept de laboratoire à une priorité nationale

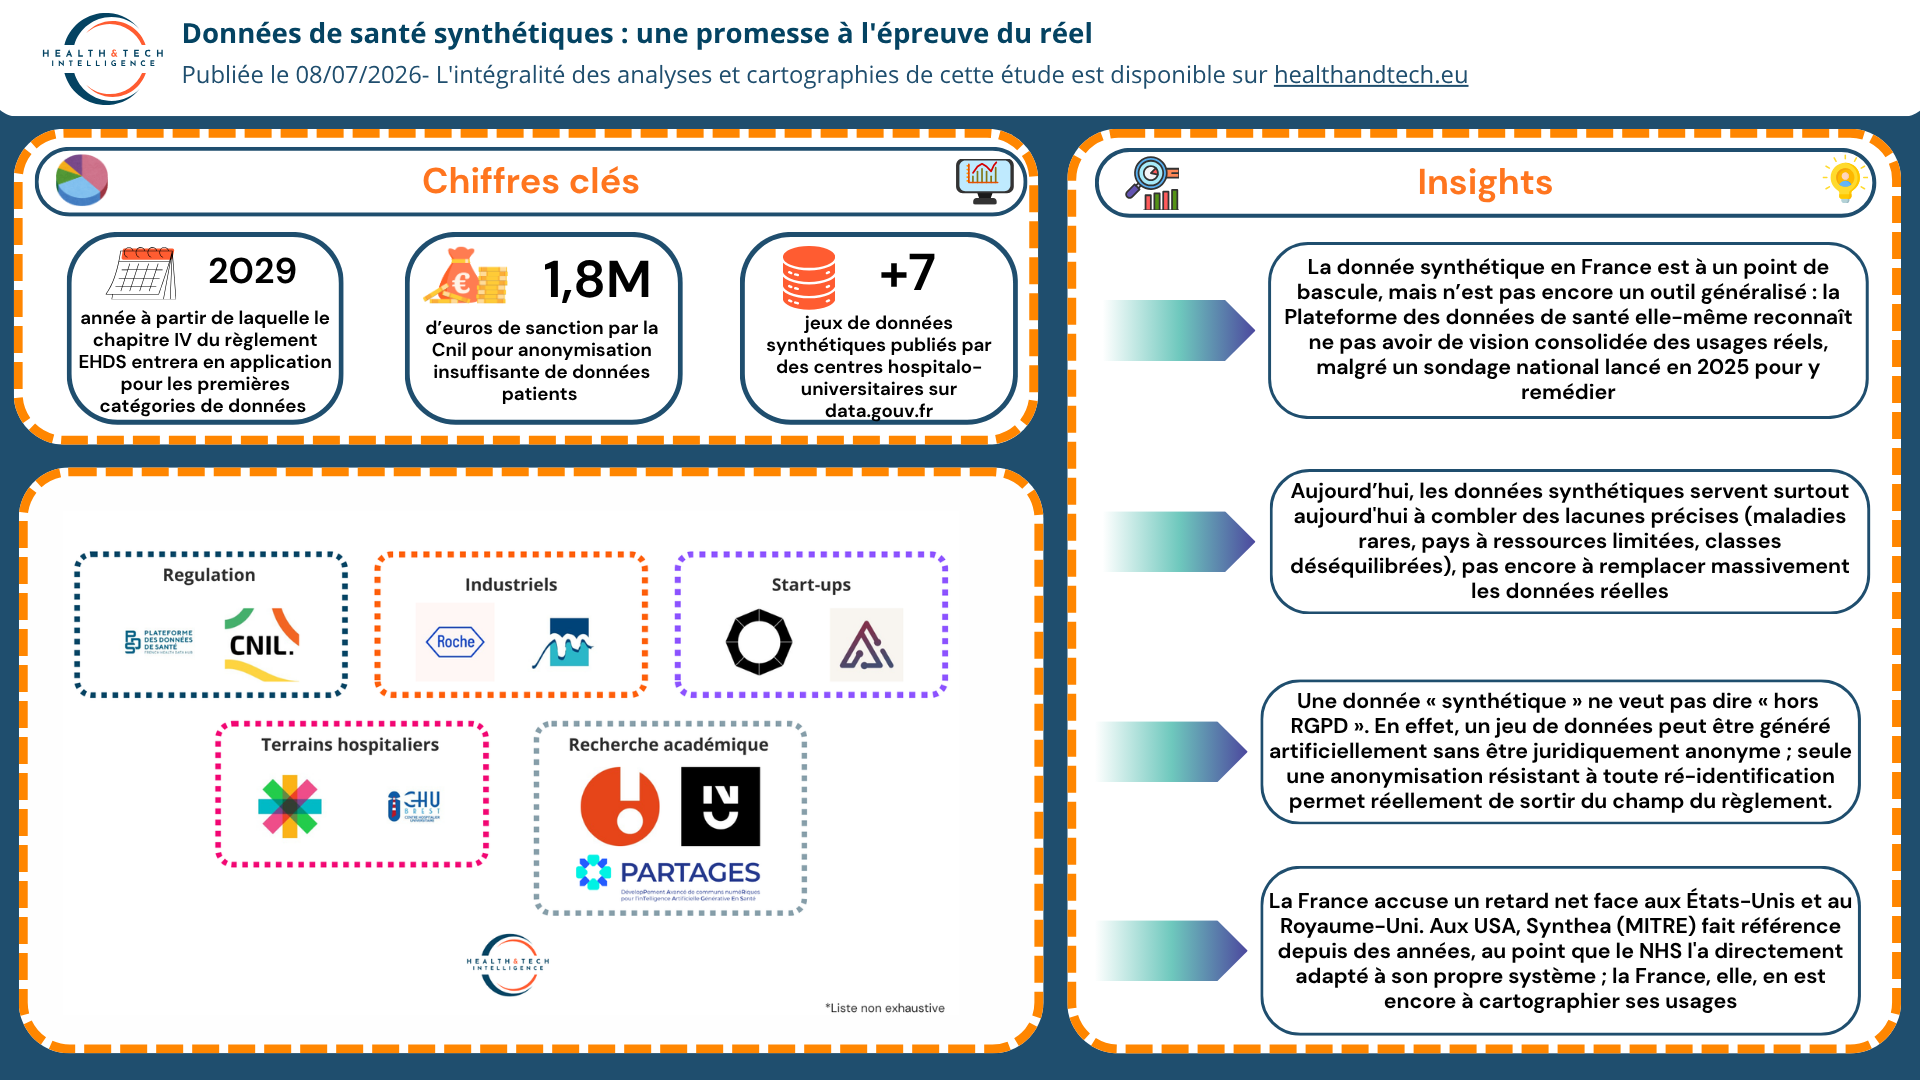
    Pendant des années, la donnée de santé synthétique n’était qu’une curiosité de laboratoire. En 2025, elle est devenue une priorité affichée par les institutions françaises. Premiers jeux de données ouverts sur data.gouv.fr, sondage national lancé par la Plateforme des données de santé, entrée en vigueur du règlement européen EHDS : cet article dresse l’état des lieux d’un sujet encore jeune, mais en pleine accélération ; et révèle pourquoi la France, malgré cette dynamique, reste en retard face aux États-Unis et au Royaume-Uni, qui ont plusieurs années d’avance.

    👉 Pour en savoir plus : consulter l’article.

    Article 2 – Données de santé synthétiques : un cadre juridique encore à construire

    « La donnée synthétique échappe au RGPD » : l’argument séduit, mais le droit ne suit pas encore. Cet article démonte cette fausse promesse à travers un cas concret et récent : une décision du Conseil d’État confirmant 1,8 million d’euros de sanctions pour anonymisation insuffisante de données patients. Entre une Cnil qui n’a toujours pas tranché et un règlement européen EHDS dont les dispositions clés n’entreront en vigueur qu’en 2029, découvrez pourquoi le cadre juridique de la donnée synthétique reste, pour l’instant, un chantier largement ouvert.

    👉 Pour en savoir plus : consulter l’article.

    Article 3 – Comment fabrique-t-on les données synthétiques ?

    La donnée synthétique ne se créée pas avec une méthode unique, mais deux logiques radicalement différentes : simuler une logique clinique à la main, ou laisser un modèle génératif (GAN, diffusion, LLM) apprendre seul les régularités des données réelles. Cet article décortique le fonctionnement de Synthea et des approches génératives, leurs forces et leurs angles morts respectifs. La leçon centrale qui s’en dégage : une donnée peut être statistiquement irréprochable – mêmes moyennes, mêmes distributions – tout en étant cliniquement absurde dans le détail. Un défi qui explique pourquoi l’évaluation d’un jeu de données synthétique est loin d’être triviale.

    👉 Pour en savoir plus : consulter l’article.

    Article 4 – 7 études démontrent l’intérêt des données de santé synthétiques pour la recherche (revue de littérature)

    Maladies rares, pays à ressources limitées, classes de patients sous-représentées : sept études récentes, publiées dans Nature, JAMIA ou le Journal of Biomedical Informatics, documentent déjà des cas concrets où la donnée synthétique comble un vrai manque pour la recherche. Mais un chiffre résume l’angle mort de cette littérature : 17 méthodes existent pour évaluer son utilité, contre seulement 5 pour évaluer ses risques de confidentialité. Cet article fait le bilan scientifique le plus à jour sur ce que la donnée synthétique apporte vraiment à la recherche, et sur ce qu’elle ne garantit pas encore.

    👉 Pour en savoir plus : consulter l’article.

    Article 5 – Cartographie des acteurs de la donnée synthétique en France

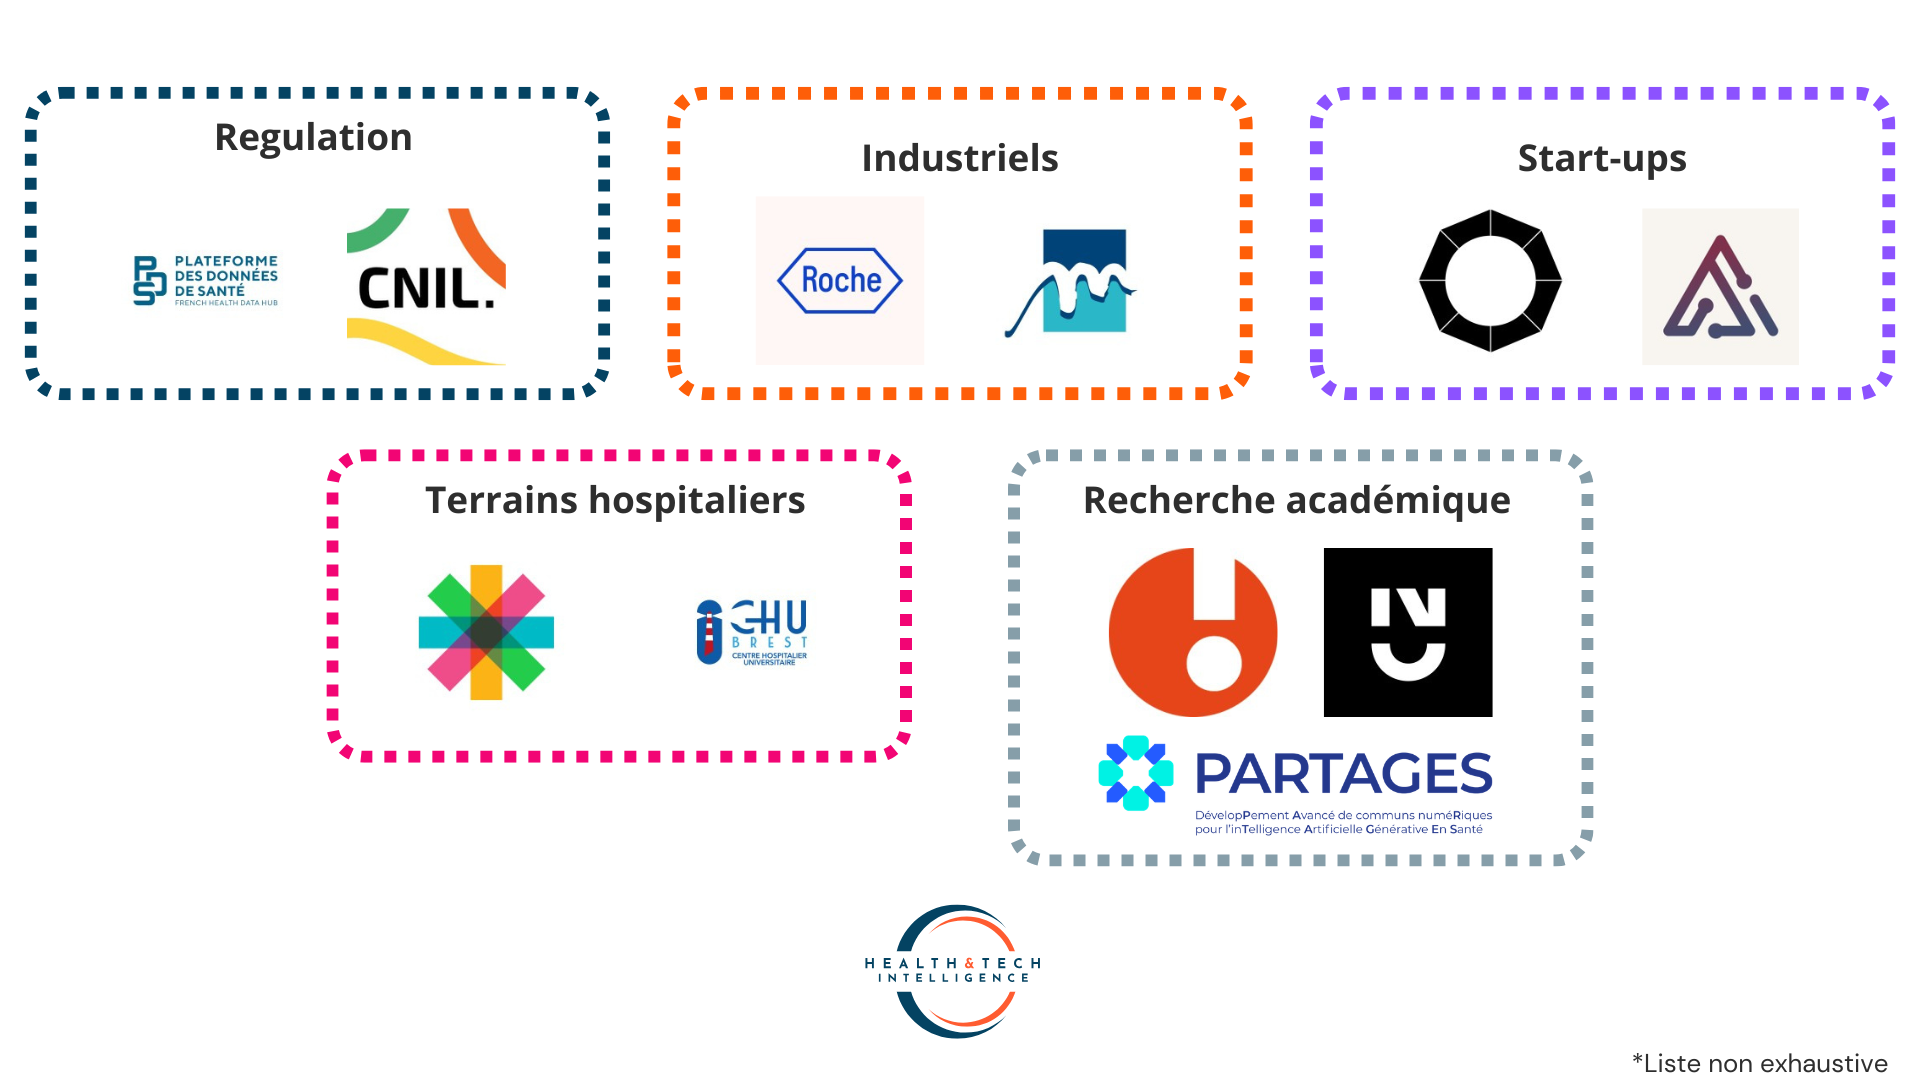
    Qui fabrique vraiment la donnée synthétique en France ? Cet article dresse la carte d’un écosystème encore restreint : une plateforme publique qui finance et catalyse, deux start-ups qui portent l’essentiel de la visibilité (mais avec un niveau de preuve très inégal), et deux CHU pionniers qui servent de bancs d’essai. Au centre de cette carte, une pépite nantaise dont la méthode est validée par une publication dans Nature, de quoi devenir un point d’appui pour toute la filière française, encore loin des écosystèmes américain et britannique.

    👉 Pour en savoir plus : consulter l’article.
    Données de santé synthétiques : une promesse à l'épreuve du réel - @H&TI
    Données de santé synthétiques : une promesse à l’épreuve du réel – @H&TI
  • Cartographie des acteurs de la donnée synthétique en France

    Le Health Data Hub, le chef d’orchestre public

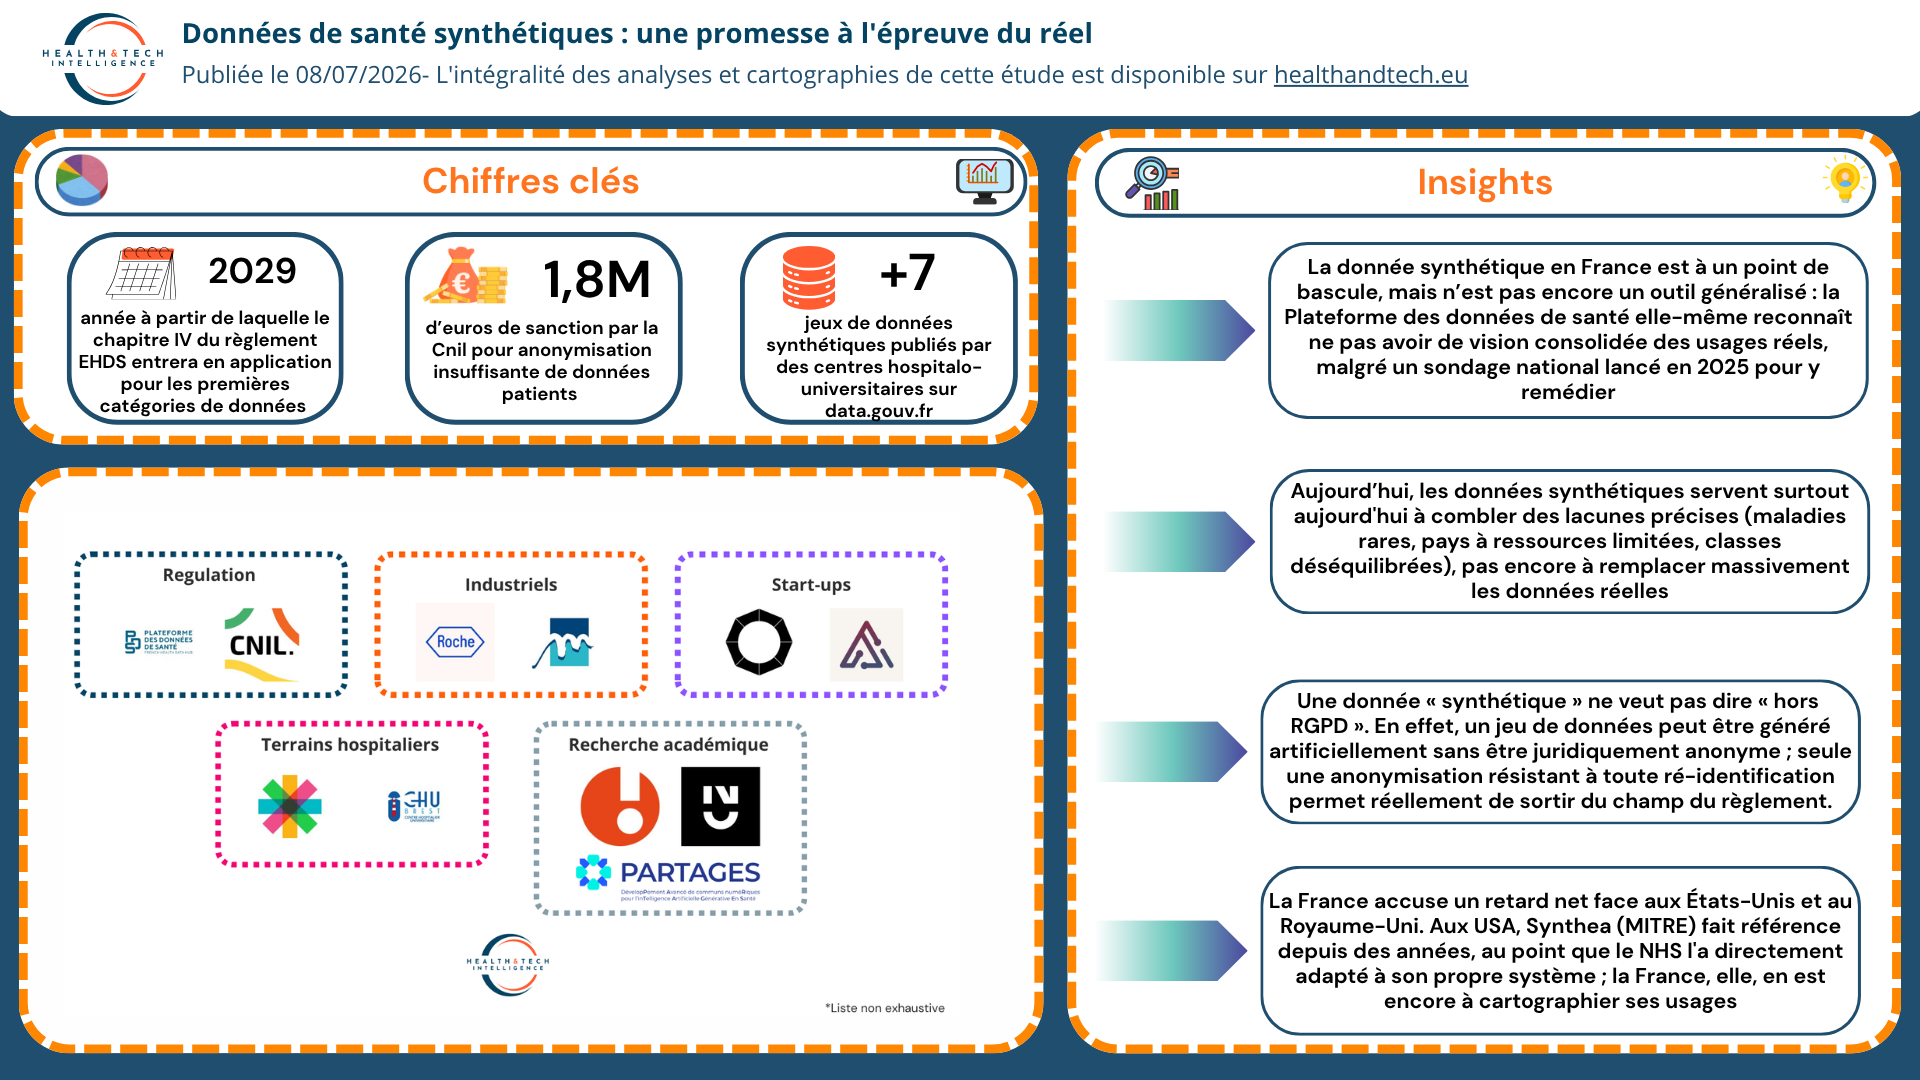
    Sans surprise, la Plateforme des données de santé (PDS – ex Health Data Hub) occupe une position centrale. La plateforme publique finance et accompagne directement des projets concrets qui utilisent des données synthétiques pour la recherche.

    Le projet “Oncoval” est l’un d’eux. Porté par la start-up Octopize, il a été primé en fin d’année 2024 dans le cadre de l’appel à manifestation d’intérêt « Partage de données industrielles » soutenu par Roche et Medipath, avec pour objectif de favoriser l’exploitation de bases de données grâce à la génération de données de synthèse. Le HDH a également publié dès 2022, en open source, un générateur de données fictives respectant la structure formelle d’une base de données de santé : un outil pédagogique destiné à familiariser les chercheurs avec ces méthodes. Le sujet a par ailleurs fait l’objet d’un « Livre blanc des données synthétiques » dès 2023, project répertorié parmi les projets lauréats du Hub.

    Le HDH coordonne également le projet Partages (pour déveloPpement Avancé de communs numéRiques pour l’inTelligence Artificielle Générative En Santé), un consortium d’une trentaine de partenaires – dont les laboratoires du CNRS et d’Inria, des établissements de santé, et des entreprises deeptech – lauréat de l’appel à projets France 2030 sur l’IA générative. Si son périmètre dépasse la seule donnée synthétique, le projet illustre la dynamique française plus large dans laquelle s’inscrit le sujet.

    Octopize, la deeptech nantaise qui vise l’Europe

    Le principal acteur privé français identifiable sur ce marché est Octopize (anciennement Mimethik Data), une start-up fondée à Nantes en 2018 par Olivier Breillacq, ancien fondateur de MethodOmics. Sa technologie brevetée, baptisée “Avatar”, génère à partir de données personnelles des « avatars », des données de synthèse qui conservent les propriétés statistiques des données d’origine sans permettre de ré-identifier les individus. La méthode a obtenu une reconnaissance de la Cnil dès juin 2020, et Octopize revendique une véritable anonymisation, et non une simple pseudonymisation

    Octopize a validé sa méthode par la publication scientifique : un article paru le 10 mars 2023 dans npj Digital Medicine (groupe Nature), co-écrit avec le CHU de Nantes, Nantes Université et l’Inserm, démontre la capacité de la méthode à préserver à la fois la confidentialité et la qualité statistique des données transformées, avec des métriques dédiées pour prouver l’impossibilité de ré-identification. L’entreprise a depuis multiplié les partenariats avec des acteurs hospitaliers (CHU de Nantes, CHU de Brest, AP-HP) et industriels (Roche, dans le cadre de l’initiative Coalition Next), tout en élargissant sa clientèle au-delà de la santé (automobile, télécommunications). Elle a levé 1,5 million d’euros en 2021 et bénéficié d’un financement de 500 000 euros via le concours i-Nov 2022, avec l’ambition assumée de devenir « le leader européen de la donnée de synthèse ».

    Alia Santé, un second acteur privé plus discret :

    Toulouse abrite un second acteur identifié sur ce marché : Alia Santé, une start-up spécialisée dans les algorithmes d’IA appliqués à la santé, dont la solution phare, Alia DataGen, propose de générer des données synthétiques en volume pour accélérer les projets d’IA en biotech et medtech. L’entreprise revendique un positionnement de « pionnier de la génération de données synthétiques dans le domaine de la santé » et a remporté le pitch start-ups de La French Care en 2024. Elle communique sur des collaborations avec des laboratoires pharmaceutiques et des établissements hospitaliers.

    Les hôpitaux universitaires, premiers terrains d’expérimentation

    Au-delà des éditeurs de technologie, plusieurs centres hospitaliers universitaires jouent un rôle actif de terrain d’expérimentation. Le CHU de Nantes a publié sept jeux de données synthétiques issus de son entrepôt de données hospitalier sur data.gouv.fr, dans le cadre d’un projet pilote sur les facteurs de rupture d’anévrisme, et s’est associé à Octopize pour la validation scientifique de la méthode Avatar. Le CHU de Brest, de son côté, a expérimenté cette même technologie aux côtés de Roche France dans le cadre de l’appel à projets Coalition Next, avec l’objectif explicite de simplifier la transmission de données de cohortes de patients pour la recherche clinique sans devoir recueillir un nouveau consentement écrit à chaque réutilisation.

    Un écosystème encore concentré, mais qui se structure

    Ce panorama, à ce stade, tient davantage de la short-list que du foisonnement : une plateforme publique qui finance et catalyse, deux start-ups qui portent l’essentiel de la visibilité française sur le sujet (avec un niveau de preuve nettement plus solide pour l’une que pour l’autre) et deux CHU pionniers qui servent de bancs d’essai. C’est nettement moins fourni que les écosystèmes américain (autour de Synthea) ou britannique (NHS, CPRD), mais la France dispose d’un atout distinctif avec Octopize, dont la méthode d’anonymisation prouvée scientifiquement pourrait devenir un point d’appui pour structurer davantage la filière, à condition de passer d’une logique de projets pilotes isolés à une adoption plus large par l’écosystème hospitalier et industriel.

    Cartographie des acteurs de la donnée synthétique en France :

    Cartographie des acteurs de la donnée synthétique en France - @H&TI
    Cartographie des acteurs de la donnée synthétique en France – @H&TI
  • 7 études démontrent l’intérêt des données de santé synthétiques pour la recherche (revue de littérature)

    7 études démontrent l’intérêt des données de santé synthétiques pour la recherche (revue de littérature)

    Un corpus de 7 études (2023–2026) sur la donnée de santé synthétique en recherche

    La pénurie chronique de données de santé exploitables — pour cause de rareté clinique, de confidentialité ou de coût de collecte — freine depuis longtemps la recherche biomédicale et le développement de modèles d’intelligence artificielle en santé. Cet article synthétise les résultats de sept études publiées entre 2025 et 2026, incluant des travaux méthodologiques, une revue systématique, une revue de portée (scoping review) et un éditorial scientifique, hébergés sur PubMed/PMC, ScienceDirect et Nature. Ces travaux, menés par des équipes de recherche internationales, visent à évaluer l’apport réel des données synthétiques lorsque les données réelles font défaut ou sont insuffisantes.

    Les études retenues couvrent trois thématiques structurantes :

    • L’usage des données synthétiques pour combler des lacunes de données dans des contextes à ressources limitées ou pour des pathologies rares ;
    • Leur capacité à égaler ou renforcer la performance de modèles cliniques par rapport aux données réelles seules ;
    • Les limites méthodologiques et les risques de gouvernance liés à un usage encore peu standardisé.

    Combler les lacunes de données : maladies rares et pays à ressources limitées

    L’un des apports les plus documentés des données synthétiques est de pallier l’insuffisance structurelle de données dans certains contextes. Une étude publiée dans Frontiers in Digital Health (2025) montre que la recherche sur les maladies rares se heurte à un manque chronique de patients, à des réglementations de confidentialité strictes et à un besoin de données diversifiées pour développer des outils diagnostiques fondés sur l’IA, les données synthétiques y sont présentées comme un pont permettant l’entraînement de modèles, la simulation d’essais cliniques et la collaboration transfrontalière entre équipes de recherche. Dans un registre proche, une étude menée sur un jeu de données de surveillance démographique et sanitaire (HDSS) en zone rurale du Kenya (2025) démontre, à titre de preuve de concept, que des modèles génératifs open source permettent de produire des données tabulaires synthétiques de haute qualité dans un pays à ressources limitées, ouvrant la voie à une recherche moins dépendante des infrastructures de collecte coûteuses.

    La question du déséquilibre des classes, fréquente en recherche clinique lorsque certains sous-groupes de patients sont sous-représentés, est elle aussi documentée : une étude de référence sur les données anti-rétrovirales pour le VIH utilise des réseaux antagonistes génératifs (GAN) pour générer des données cliniques synthétiques qui préservent la distribution déséquilibrée des classes d’origine, plutôt que de la lisser artificiellement.

    Une utilité comparable aux données réelles, dans certains cas précis

    Au-delà de la simple compensation d’un manque, plusieurs études rapportent des résultats de performance directement comparables aux données réelles. Le projet coréen Healthcare Big Data Showcase (2019-2023), documenté dans une étude publiée par l’agence coréenne de contrôle des maladies (2025), a produit des jeux de données synthétiques évalués selon leur « utilité », soit leur capacité à reproduire des résultats d’analyse comparables à ceux obtenus avec les données réelles correspondantes. Autre exemple concret : une étude sur des modèles de prédiction clinique en gastro-entérologie et hépatologie (hépatite alcoolique, angiocholite aiguë) montre que des données synthétiques générées par IA permettent d’augmenter et de renforcer la performance des modèles prédictifs existants, tout en appelant à des protocoles de validation standardisés avant tout déploiement clinique plus large.

    Des limites méthodologiques et de gouvernance encore non résolues

    La littérature récente met cependant en garde contre une adoption non critique. Une revue de portée (scoping review) parue en 2025, portant sur les publications indexées entre 2018 et 2024, recense pas moins de 17 méthodes différentes utilisées pour évaluer l’utilité des données médicales synthétiques et seulement 5 pour en évaluer les risques de confidentialité, un déséquilibre qui traduit l’absence de standard consolidé pour juger de la fiabilité d’un jeu de données synthétique. Plus préoccupant encore, un éditorial de la revue Nature (2025) alerte sur une dérive de gouvernance : certaines universités et institutions de recherche dispensent déjà des études fondées sur des données synthétiques de tout examen éthique préalable, au motif que ces données ne sont pas directement issues de participants humains, alors même qu’elles dérivent in fine de données réelles et peuvent en hériter les biais.

    Tableau comparatif synthétique des 7 études :

    Réf. Population / Domaine Conclusion principale
    Frontiers in Digital Health, 2025 (PMC11958975) Recherche sur maladies rares Les données synthétiques comblent le manque de patients et permettent essais simulés et collaboration transfrontalière.
    PMC12628187 (2025) Données de surveillance démographique et sanitaire, Kenya rural Les modèles génératifs ouverts sont viables dans des contextes à ressources limitées.
    J Biomed Inform, 2023 (PMID 37451495) Données antirétrovirales VIH Les GAN permettent de générer des données synthétiques fidèles aux déséquilibres réels, plutôt que de les lisser.
    Osong Public Health Res Perspect, 2025 (PMC12066231) Programme national coréen (2019-2023) Les données synthétiques évaluées par leur utilité peuvent se substituer aux données réelles pour certaines analyses.
    PMC12138892 (2025) Hépatite alcoolique, angiocholite aiguë Les données synthétiques renforcent les modèles prédictifs, sous réserve de protocoles de validation standardisés.
    PMC11772694, 2025 (scoping review, 2018-2024) Littérature médicale sur données synthétiques L’absence de standards d’évaluation consolidés reste un frein majeur à la confiance.
    Nature, 2025 (éditorial) Gouvernance de la recherche Les risques de gouvernance et de biais hérités doivent être mieux encadrés avant généralisation.

    Une donnée efficace, mesurable, mais pas encore encadré

    Il ressort de ces sept travaux que l’intérêt des données de santé synthétiques pour la recherche repose sur deux constats convergents, tempérés par un troisième :

    • Un comblement réel des lacunes de données, qu’il s’agisse de maladies rares, de contextes à ressources limitées ou de classes de patients sous-représentées ;
    • Une utilité désormais mesurable et parfois comparable aux données réelles, comme le montrent le projet coréen et l’étude sur les modèles prédictifs en hépatologie, signe que la donnée synthétique dépasse le stade de la preuve de concept pour certains usages ciblés ;
    • Un cadre méthodologique et éthique encore en rattrapage, car l’absence de standards d’évaluation de la confidentialité, couplée à des pratiques de gouvernance parfois trop permissives, rappelle que l’utilité mesurée d’un jeu de données synthétique ne dispense pas d’un examen rigoureux de ses risques. C’est un point qui fait écho aux limites techniques de fidélité clinique déjà abordées dans cette étude, et au flou juridique qui entoure encore leur qualification au regard du RGPD.

    Bibliographie :

    (1) Kimuli A, et al. Synthetic data generation of health and demographic surveillance systems data: a case study in a low- and middle-income country. J Am Med Inform Assoc. 2025. PMCID: PMC12628187.

    (2) Mendes JM, et al. Synthetic data generation: a privacy-preserving approach to accelerate rare disease research. Front Digit Health. 2025;7:1563991. PMCID: PMC11958975.

    (3) Korea National Institute of Health. Synthetic data production for biomedical research. Osong Public Health Res Perspect. 2025;16(2):94-99. PMCID: PMC12066231.

    (4) Use of Artificial Intelligence–Generated Synthetic Data to Augment and Enhance the Performance of Clinical Prediction Models in Patients With Alcohol-Associated Hepatitis and Acute Cholangitis. PMCID: PMC12138892.

    (5) A scoping review of privacy and utility metrics in medical synthetic data. PMC. 2025. PMCID: PMC11772694.

    (6) Synthetic data can benefit medical research — but risks must be recognized [éditorial]. Nature. 2025.

    (7) Kuo NI, Garcia F, Sönnerborg A, Böhm M, Kaiser R, Zazzi M ; EuResist Network study group ; Polizzotto M, Jorm L, Barbieri S. Generating synthetic clinical data that capture class imbalanced distributions with generative adversarial networks: Example using antiretroviral therapy for HIV. J Biomed Inform. 2023 Aug;144:104436. PMID: 37451495.

  • Comment fabrique-t-on les données synthétiques ?

    Deux grandes familles de méthodes

    Générer un dossier médical qui n’existe pas peut se faire de deux façons radicalement différentes : en simulant explicitement une logique clinique, ou en laissant un modèle statistique apprendre seul les régularités d’une base réelle pour en produire une copie plausible.

    La première approche, à base de règles, est illustrée par Synthea, l’outil open source développé par le centre de recherche à but non lucratif américain Mitre. Synthea ne s’entraîne pas sur des données patients réelles : il simule des « parcours de vie » à partir de modules cliniques codés à la main, qui décrivent des maladies chroniques (diabète, hypertension) ou aiguës (fractures, infections) sous forme de machines à états, chaque état représentant une étape du parcours de soin, avec des transitions calibrées sur des données épidémiologiques, des statistiques d’incidence et de prévalence, et de la littérature académique. Le résultat : des populations entières de patients fictifs, avec un historique de soins complet sur toute une vie, sans qu’aucun individu réel n’ait servi de modèle direct.

    La seconde approche, générative, repose sur des modèles de deep learning entraînés sur des données réelles pour en apprendre la distribution statistique, puis en générer de nouvelles occurrences plausibles. Les réseaux antagonistes génératifs (GAN) en sont l’exemple le plus connu : un réseau « générateur » produit des données à partir de bruit aléatoire, tandis qu’un réseau « discriminateur » tente de distinguer ces données synthétiques des vraies. Les deux réseaux s’améliorent en miroir jusqu’à ce que le générateur produise des données quasiment indiscernables des données réelles. En santé, cette approche sert aussi bien à générer des images médicales synthétiques (IRM, radiographies, échocardiographies) qu’à créer des dossiers médicaux électroniques synthétiques structurés, des variantes comme CTGAN sont spécifiquement conçues pour les données tabulaires de santé. Plus récemment, des modèles de diffusion et des grands modèles de langage sont eux aussi mobilisés pour générer ce type de données.

    Une fidélité clinique qui n’est jamais acquise

    Le choix de la méthode n’est pas neutre. Les approches à base de règles, comme Synthea, garantissent une cohérence clinique de départ, puisque la logique médicale est encodée explicitement par des développeurs travaillant avec des cliniciens — mais elles peuvent aussi reproduire des angles morts si cette logique est incomplète. Un rapport américain sur le développement de modules Synthea pour des populations à besoins complexes illustre bien ce risque : lors de la relecture de dossiers synthétiques de patients atteints de sepsis, les développeurs ont constaté une absence de corrélation entre les valeurs de tension artérielle systolique et diastolique généreées — une incohérence physiologique évidente pour un clinicien, mais qu’aucun algorithme ne détecte seul. Le module a dû être corrigé après une revue de littérature complémentaire.

    Les approches génératives (GAN, diffusion, LLM) posent un défi symétrique : elles apprennent une distribution statistique globale, mais rien ne garantit qu’elles respectent les contraintes médicales fines qui n’apparaissent qu’à travers des corrélations rares dans les données d’entraînement. Une revue de littérature récente sur la génération de données patients synthétiques pour la recherche en santé note que ces méthodes sont surtout utilisées aujourd’hui pour pallier un volume insuffisant ou un déséquilibre des classes dans les jeux d’entraînement, un usage d’appoint plutôt qu’un substitut complet aux données réelles. Une synthèse sur les GAN appliqués à la cardiologie pointe dans le même sens : au-delà des progrès techniques, la fidélité médicale des données produites reste un défi non résolu, aux côtés des questions réglementaires et éthiques.

    Fidélité statistique n’est pas fidélité clinique :

    Le point commun à toutes ces méthodes : une donnée peut être statistiquement très ressemblante à la réalité – mêmes moyennes, mêmes distributions, mêmes corrélations générales – sans être cliniquement plausible dans le détail. C’est précisément ce qui rend l’évaluation d’un jeu de données synthétique complexe : il ne suffit pas de vérifier des indicateurs statistiques globaux, il faut aussi une relecture clinique qualitative, comme dans l’exemple de Synthea, pour détecter les incohérences que seule une expertise médicale peut repérer.

  • Données de santé synthétiques : un cadre juridique encore à construire

    La promesse d’un contournement du RGPD, à nuancer

    L’argument revient souvent : une donnée synthétique, ne correspondant à aucun individu réel, échapperait au RGPD. La réalité est plus subtile. Le règlement ne s’applique qu’aux données personnelles, c’est-à-dire se rapportant à une personne identifiée ou identifiable, mais un jeu de données peut être « synthétique » sans être juridiquement anonyme pour autant. La Cnil rappelle que la pseudonymisation, qui consiste à remplacer les identifiants directs par des alias, n’équivaut jamais à une anonymisation : une ré-identification reste possible grâce à des données tierces, ce qui maintient le jeu de données dans le champ du RGPD. Seule une anonymisation véritable, résistant à toute tentative de ré-identification par des moyens raisonnablement disponibles, permet de sortir du cadre réglementaire : ceci est un standard fixé par le considérant 26 du RGPD.

    Or produire une donnée réellement anonyme, y compris lorsqu’elle est générée artificiellement, est loin d’être trivial. Une décision du Conseil d’État rendue en février 2026 l’illustre bien : la haute juridiction a confirmé des sanctions prononcées par la Cnil, pour un montant cumulé de 1,8 million d’euros, contre des sociétés ayant insuffisamment anonymisé des données comportant des informations sur des patients et les actes médicaux qui leur avaient été prodigués. Le Conseil d’État a jugé que la ré-identification des personnes concernées n’avait nécessité que peu de temps et de moyens, un simple tableur et une nomenclature communiquée par les sociétés ont suffi. La leçon vaut aussi pour la donnée synthétique : le seul fait qu’un jeu de données soit généré artificiellement ne garantit rien juridiquement si sa méthode de génération reste trop proche des données sources.

    Ce que dit (et ne dit pas encore) la CNIL

    Sur la donnée synthétique en tant que telle, la Cnil n’a pas publié de doctrine dédiée, mais elle l’évoque déjà dans ses recommandations plus larges sur le développement de systèmes d’intelligence artificielle. Elle y cite les données synthétiques comme une mesure de minimisation possible, aux côtés de l’anonymisation, de la pseudonymisation ou de l’apprentissage fédéré, et recommande leur usage pour des expérimentations à petite échelle avant tout traitement de données personnelles réelles. Cette position reste toutefois générale et transversale à l’IA, sans grille d’analyse spécifique à la santé ni critères précis pour juger si un jeu de données de santé synthétique est effectivement anonyme.

    L’EHDS, un chantier européen encore en rodage

    Le règlement européen sur l’espace européen des données de santé (EHDS), publié au Journal officiel de l’Union européenne le 5 mars 2025 et entré en vigueur le 26 mars suivant, doit structurer à terme la réutilisation des données de santé à l’échelle du continent européen, de la recherche, à l’évaluation des politiques de santé, en passant par l’innovation.

    Mais son volet le plus pertinent pour la donnée synthétique, celui de l’utilisation secondaire des données (chapitre IV), n’entrera en application que progressivement, à partir de mars 2029 pour les premières catégories de données. En attendant, c’est l’initiative TEHDAS2, action commune européenne chargée de préparer la mise en œuvre du règlement, qui a produit dès septembre 2025 les premières lignes directrices concrètes sur la minimisation, la pseudonymisation, l’anonymisation et la génération de données synthétiques par les futurs organismes responsables de l’accès aux données de santé (les HDAB).

    Ce sont, à ce jour, les indications les plus précises disponibles sur la façon dont l’Europe compte encadrer la production de données synthétiques dans le secteur de la santé, mais elles n’ont pas encore de valeur contraignante.

    Un droit encore en construction

    Le tableau qui se dessine est celui d’un cadre juridique par superposition : un socle RGPD strict sur l’anonymisation, une jurisprudence qui rappelle la difficulté technique d’y parvenir, des recommandations Cnil encore génériques, et un règlement européen dont les dispositions les plus directement applicables à la donnée synthétique n’entreront en vigueur que dans plusieurs années. De quoi inciter à la prudence les acteurs qui présentent leurs jeux de données synthétiques comme automatiquement conformes.

  • Données de santé synthétiques : d’un concept de laboratoire à une priorité nationale

    Le passage d’un concept de laboratoire à un besoin concret pour la recherche

    Pendant longtemps, la donnée de santé synthétique est restée un concept de laboratoire : produire des données qui reproduisent les propriétés statistiques d’une base réelle, sans qu’aucun individu réel n’y soit associé. Un principe simple, pensé pour contourner un problème bien concret : les contraintes réglementaires et éthiques qui pèsent sur l’accès aux données de santé réelles (autorisations Cnil, comités d’éthique, délais d’instruction) freinent souvent la recherche, la formation des futurs data scientists ou les phases exploratoires de projets numériques en santé. La Plateforme des données de santé (PDS – ex Health Data Hub) la présente ainsi comme une réponse à ce goulot d’étranglement : un « levier prometteur pour l’expérimentation », qui permet de travailler sans attendre les autorisations nécessaires à l’usage de données réelles.

    En 2025, cette promesse a changé de statut. La PDS et l’Agence du programme santé numérique d’Inria ont lancé cette année-là un sondage national auprès de l’écosystème pour « dresser un état des lieux des pratiques actuelles d’utilisation des données synthétiques » et « identifier les besoins ». Ceci est un signe révélateur de l’intérêt croissant pour les données synthétiques. Cependant, l’institution elle-même reconnaît ne pas encore avoir une vision complète de qui utilise ces données, et comment.

    Des premières briques concrètes :

    Le discours institutionnel s’accompagne déjà de réalisations. Depuis 2024, le HDH a ouvert plusieurs bases sur la plateforme data.gouv.fr : une base synthétique reconstituant le schéma des tables de la base principale du Système national des données de santé (SNDS) à partir d’environ cinquante patients fictifs, ainsi qu’une base dédiée à l’algorithme du « Top Diabète », qui sert à repérer les personnes prises en charge pour un diabète dans le SNDS. Le CHU de Nantes a de son côté publié sept jeux de données synthétiques issus de son entrepôt de données hospitalier, dans le cadre d’un projet pilote sur les facteurs de rupture d’anévrisme. Ce sont, à ce stade, des volumes modestes et des cas d’usage ciblés, loin d’une industrialisation, mais des preuves de concept bien réelles.

    Un contexte institutionnel qui s’accélère

    Cette montée en puissance ne doit rien au hasard. La PDS a récemment annoncé qu’elle a dépassé la barre des 230 projets de recherche accompagnés, dans un contexte où la demande d’accès aux données de santé ne cesse de croître. La donnée synthétique s’inscrit dans cette dynamique plus large aux côtés de projets structurants comme PARTAGES, consacré aux modèles de langage appliqués à la santé, ou SHAIPED, consortium européen pour l’intelligence artificielle médicale. Autre facteur déterminant : 2025 est aussi l’année d’entrée en vigueur du règlement européen sur l’espace européen des données de santé (EHDS), qui doit structurer à l’échelle du continent le partage, et potentiellement la production, de données de santé, réelles comme synthétiques.

    Un usage encore jeune, une confiance à construire :

    Reste que l’adoption est loin d’être généralisée. Le sondage lancé par le HDH et Inria en juillet 2025 vise justement à sortir d’une connaissance parcellaire : aujourd’hui, personne n’a de vision consolidée du nombre d’acteurs qui utilisent réellement ces données, ni des usages qu’ils en font au quotidien. Les autorités elles-mêmes avancent prudemment. La Commission nationale de l’informatique et des libertés (Cnil), qui encadre strictement tout traitement de données de santé en France, n’a pour l’instant pas publié de doctrine spécifique sur la donnée synthétique, signe que le sujet reste, réglementairement, un chantier ouvert, sur lequel nous reviendrons dans le deuxième article de cette étude.

    À ce stade, la donnée de santé synthétique en France se trouve donc à un point de bascule : plus un simple objet de recherche, pas encore un outil déployé à grande échelle. Les prochains mois – et le sondage national en cours – devraient permettre de mesurer si la promesse tient face à l’usage réel.

    Et ailleurs, où en est-on ?

    Comparée à d’autres pays, la France reste en phase d’amorçage. Aux États-Unis, l’outil open source Synthea, développé par le centre de recherche à but non lucratif MITRE, génère depuis plusieurs années des dossiers médicaux complets et synthétiques – historique de soins, traitements, allergies – pour des populations entières, sans restriction d’usage liée à la confidentialité. Le projet est devenu une référence internationale, au point que le Royaume-Uni l’a directement adapté à son propre système de santé.

    Le NHS a en effet multiplié les initiatives ces dernières années : une version britannique de Synthea pour les soins primaires, un jeu de données synthétique reproduisant le registre national du cancer (le « Simulacrum »), ou encore des données synthétiques publiées par le Clinical Practice Research Datalink (CPRD) pour l’entraînement de modèles. Signe que le sujet est pris au sérieux au plus haut niveau, le plan gouvernemental britannique pour l’intelligence artificielle a explicitement identifié la donnée synthétique comme un levier pour partager des données de santé sensibles sans compromettre la vie privée.

    L’Allemagne avance elle aussi de façon structurée, avec le projet KI-FDZ porté notamment par l’institut fédéral du médicament (BfArM), qui combine anonymisation et synthétisation des données de vie réelle au sein d’environnements sécurisés, une approche que la France regarde de près dans le cadre de sa coopération bilatérale sur l’espace européen des données de santé.

    Le point commun de ces initiatives étrangères : plusieurs années d’avance en matière d’outillage et de retour d’expérience concret, quand la France en est encore à cartographier ses propres usages. L’enjeu, pour l’écosystème français, sera de rattraper ce retard sans se contenter d’importer des outils pensés pour d’autres systèmes de santé, le cas britannique, justement contraint d’adapter Synthea à sa réalité locale, illustre bien la limite de l’exercice.

  • Baromètre de la connaissance des données de santé : les Français mieux informés, mais encore en attente de garanties

    Une sensibilisation en hausse, mais des connaissances encore incomplètes

    Réalisée auprès de plus de 2 000 Français par la Plateforme des données de santé, France Assos Santé, la Commission nationale de l’informatique et des libertés, la Délégation au numérique en santé et PariSanté Campus, cette troisième édition montre que les notions générales progressent, sans pour autant se traduire par une véritable appropriation des sujets.

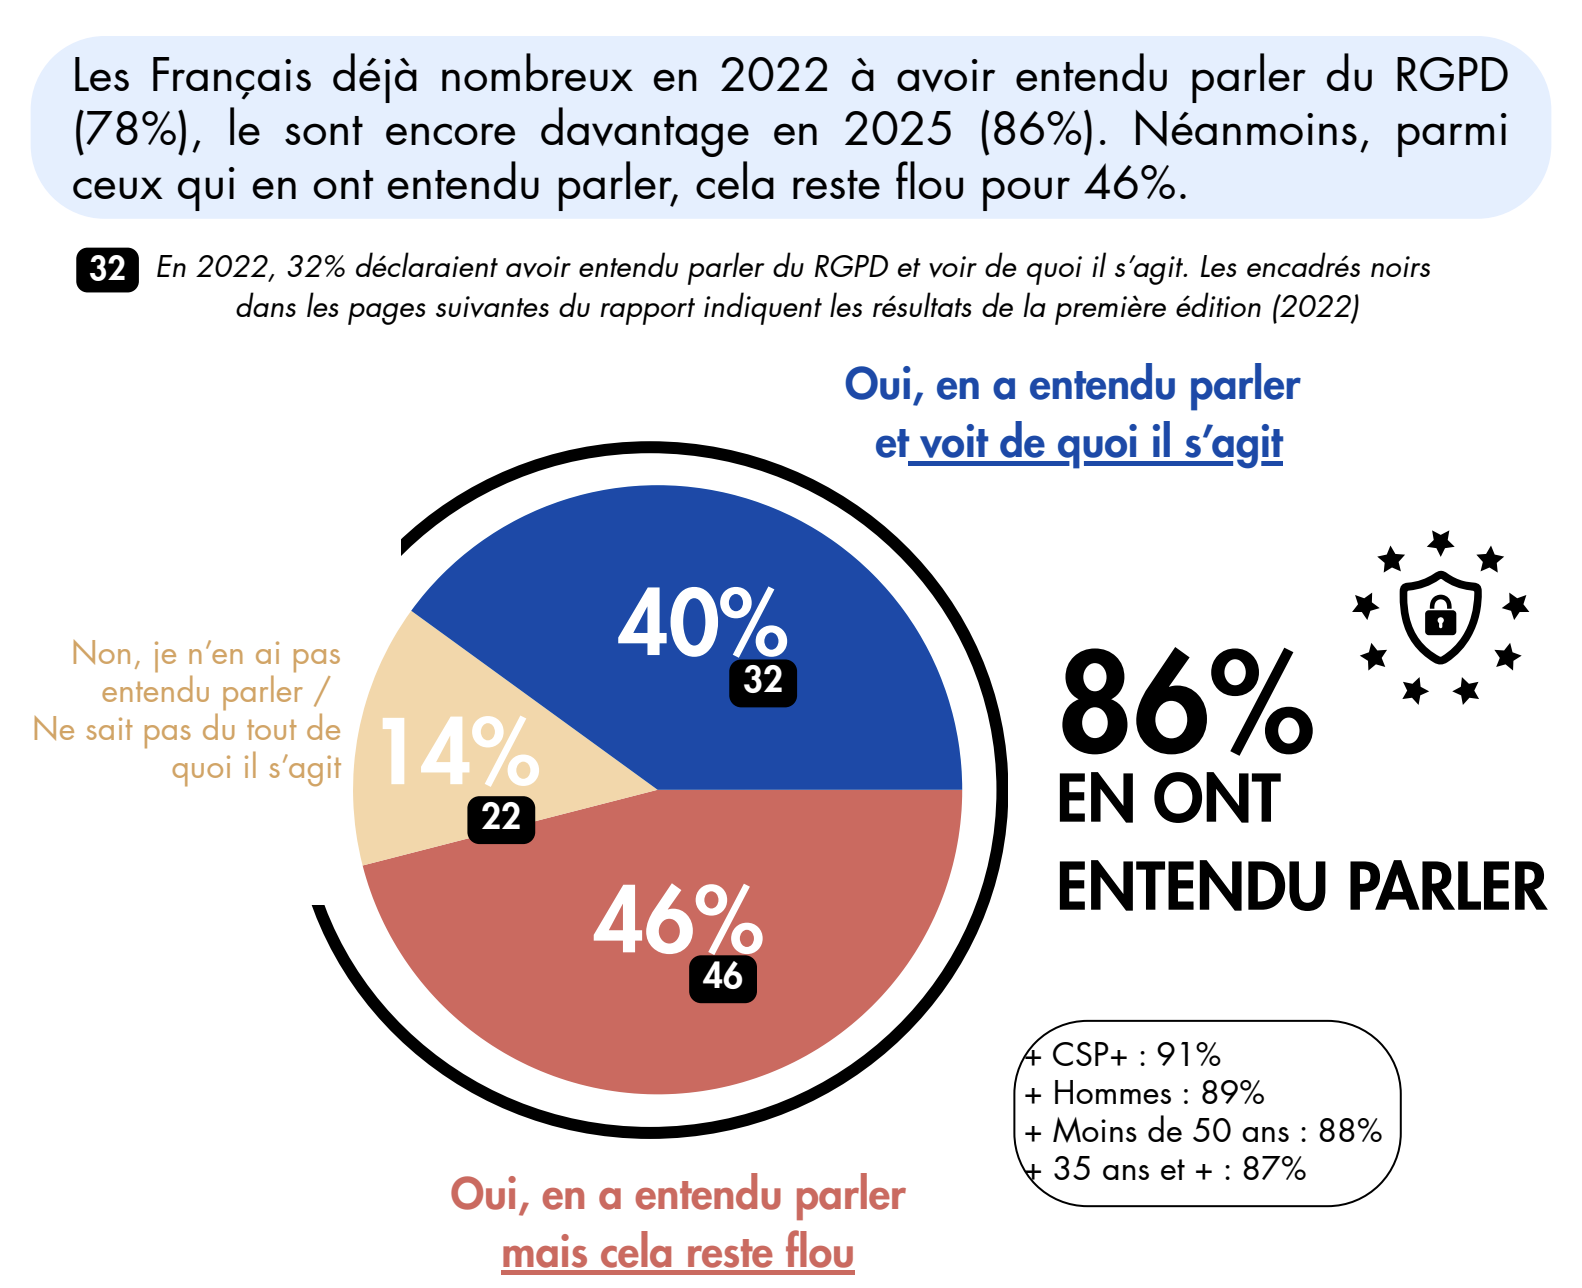
    Ainsi, 86 % des Français déclarent avoir déjà entendu parler du RGPD, contre 78 % lors de la première édition. 82 % savent que les données de santé bénéficient d’un niveau de protection renforcé et 53 % estiment connaître leurs droits, même si cette connaissance reste souvent approximative.

    86% des Français ont entendu parler du RGPD
    86% des Français ont entendu parler du RGPD

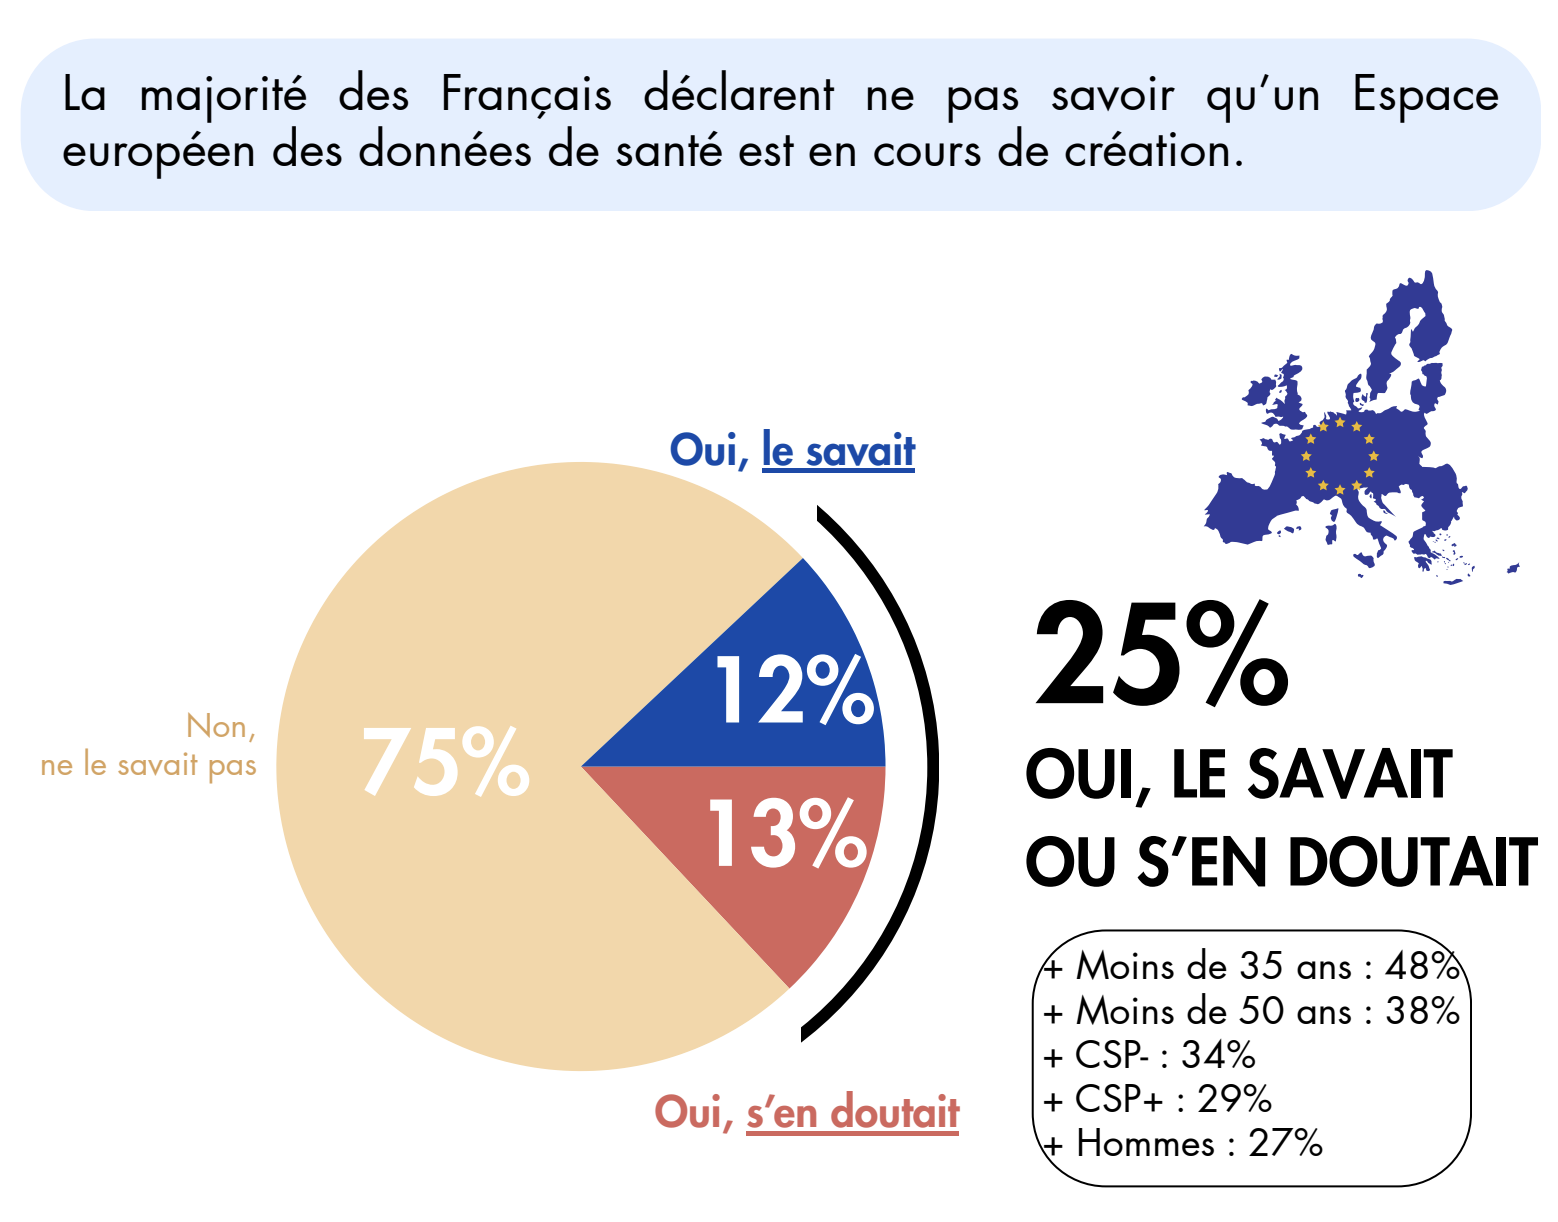
    En revanche, dès que les questions deviennent plus techniques, les résultats se dégradent. Seuls 28 % disent comprendre ce que sont des données anonymisées et 23 % les données pseudonymisées, pourtant au cœur des projets de recherche en santé. Plus marquant encore, 75 % ignorent qu’un Espace européen des données de santé (EHDS) est actuellement en cours de déploiement.

    Seuls 25% des Français connaissent l'existence d'un EHDS
    Seuls 25% des Français connaissent l’existence d’un EHDS

    Une forte demande d’information sur l’usage des données :

    Le principal enseignement du baromètre ne porte finalement pas sur le niveau de connaissance, mais sur les attentes exprimées par les citoyens.

    67 % des Français estiment ne pas être suffisamment informés sur les projets de recherche utilisant les données de santé, même si ce chiffre recule par rapport à 2022 (77 %). Dans le même temps, 58 % souhaitent obtenir davantage d’informations sur l’utilisation de leurs données, une proportion en hausse continue depuis la première édition (48 % en 2022).

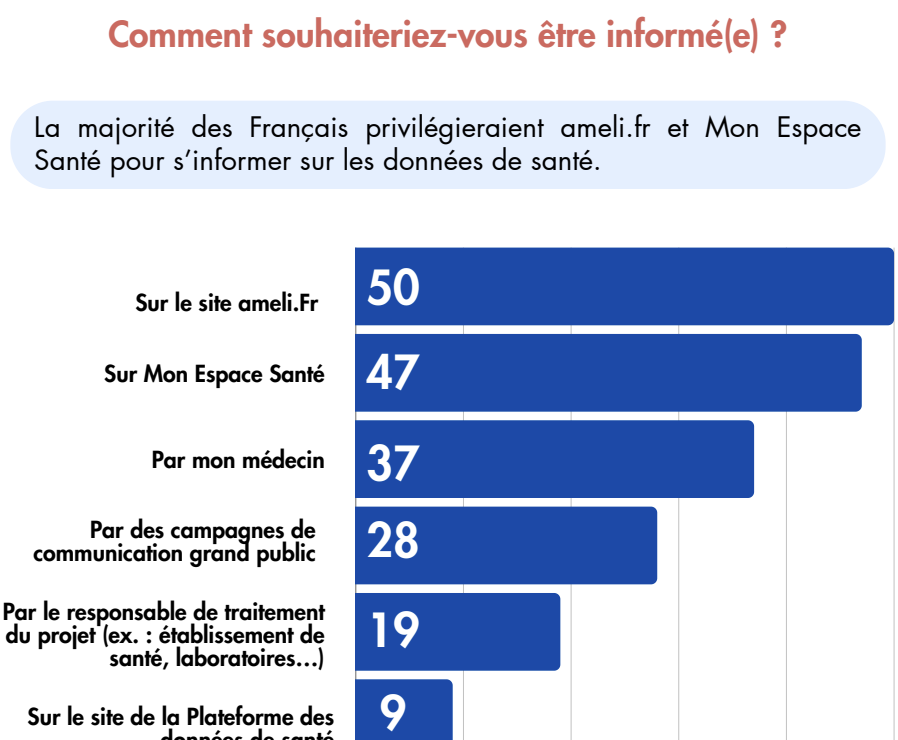
    Interrogés sur les canaux privilégiés, les Français citent en priorité ameli.fr (50 %), Mon espace santé (47 %) puis leur médecin (37 %), confirmant que la confiance repose avant tout sur les acteurs institutionnels et les professionnels de santé.

    Les Français préfèrent être informés sur améli
    Les Français préfèrent être informés sur améli

    Un enjeu stratégique à l’heure de l’EHDS

    Au-delà des chiffres, ce baromètre intervient à un moment charnière. Alors que l’EHDS doit progressivement harmoniser les règles d’accès et de partage des données de santé en Europe, l’adhésion des citoyens apparaît comme une condition essentielle de sa réussite.

    Le rapport souligne ainsi que les efforts doivent désormais porter moins sur la réglementation – déjà largement méconnue – que sur la pédagogie, la transparence et le dialogue avec les citoyens. Les partenaires du baromètre mettent notamment en avant le développement d’actions coordonnées d’information, comme l’Académie citoyenne des données de santé ou de nouveaux espaces de dialogue destinés à mieux expliquer les usages de ces données dans la recherche.

    Le message est clair : à mesure que les données deviennent un levier majeur pour la recherche, l’intelligence artificielle et l’innovation médicale, la confiance des citoyens reposera autant sur la qualité de l’information que sur la robustesse des dispositifs de protection.

  • AI Act : où en est-on vraiment ?

    Ce qui s’applique déjà

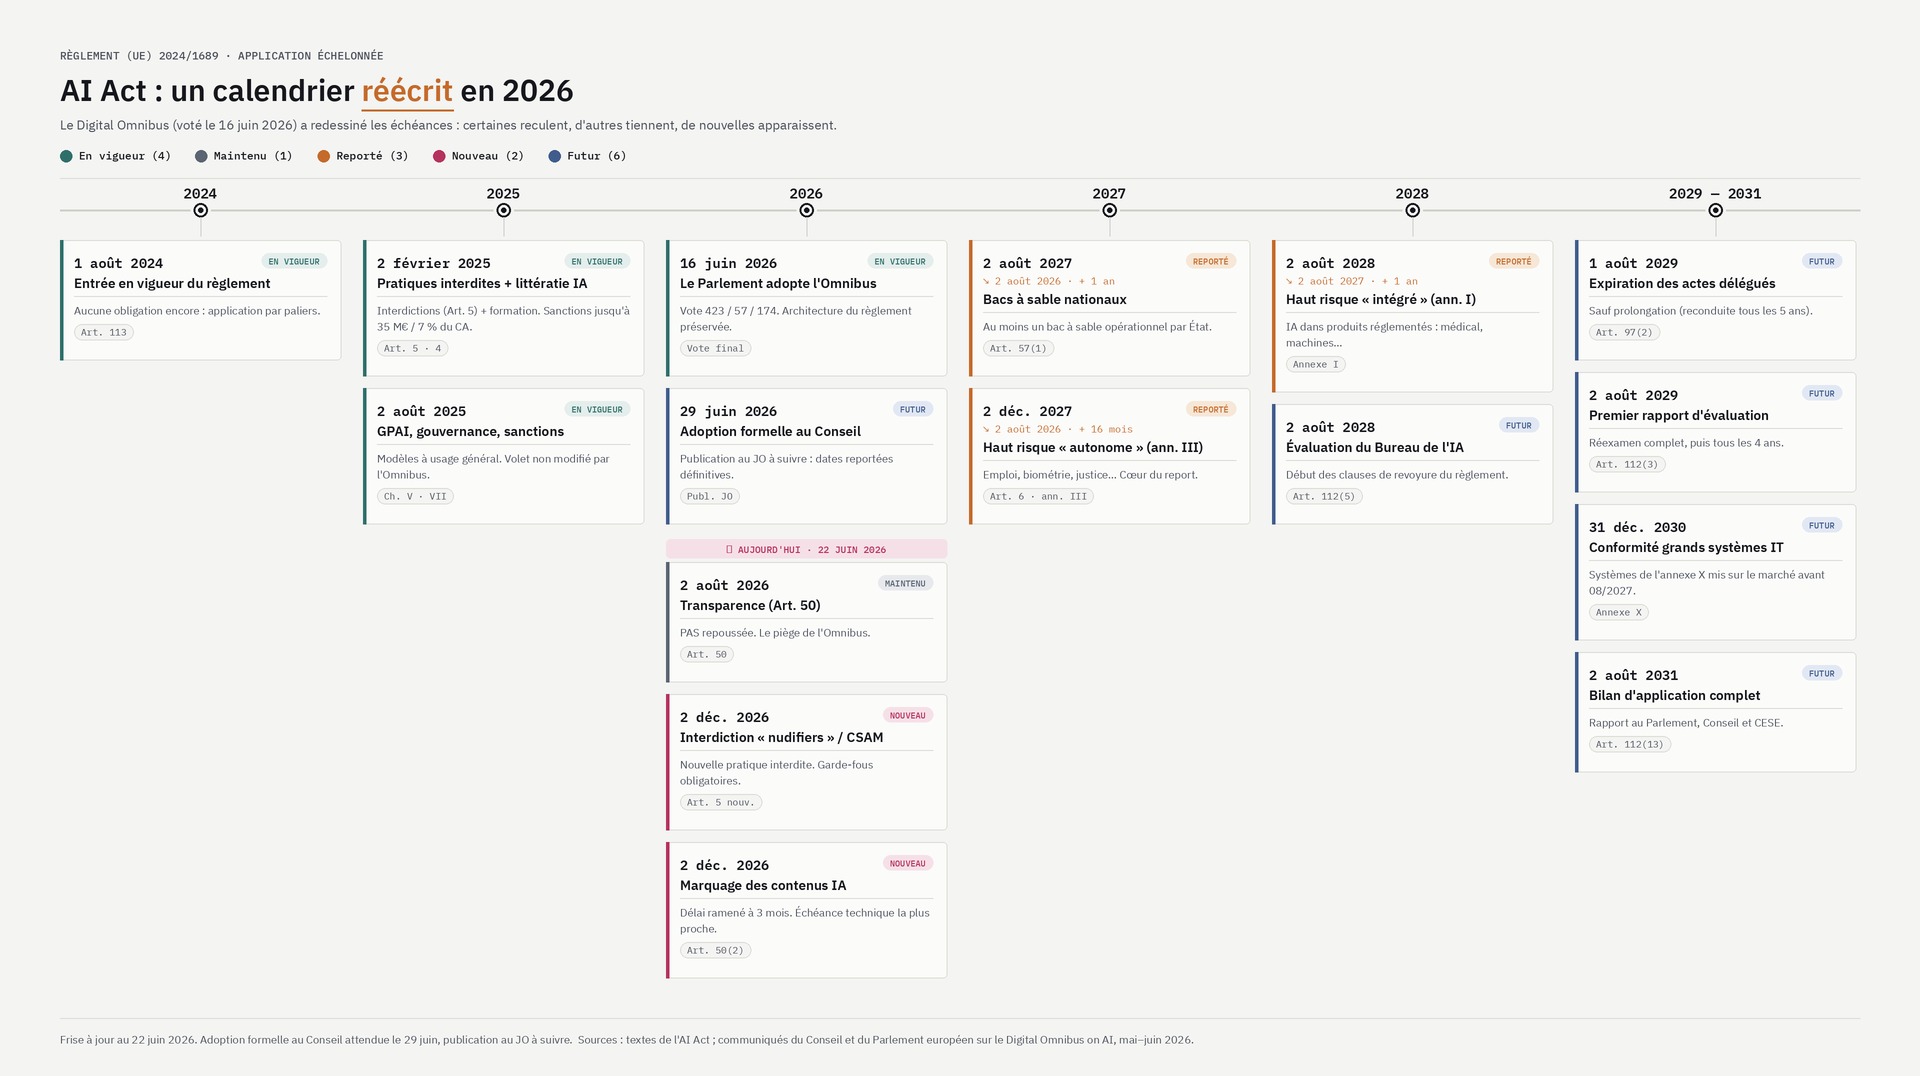
    Le règlement (UE) 2024/1689, dit AI Act, est entré en vigueur le 1ᵉʳ août 2024, mais avec une application échelonnée. Deux étapes sont déjà derrière nous, et elles produisent leurs effets dès aujourd’hui.

    Depuis le 2 février 2025, deux blocs s’appliquent. D’une part, les pratiques interdites de l’article 5 : notation sociale, manipulation subliminale, identification biométrique en temps réel dans l’espace public (avec exceptions encadrées), etc. Ces interdictions relèvent du palier de sanction le plus élevé du règlement — jusqu’à 35 millions d’euros ou 7 % du chiffre d’affaires mondial. D’autre part, l’obligation de littératie en IA (article 4) : former le personnel et les sous-traitants qui opèrent des systèmes d’IA.

    Depuis le 2 août 2025, c’est le régime des modèles d’IA à usage général (GPAI) qui est entré en jeu (chapitre V), accompagné de la gouvernance (chapitre VII), des organismes notifiés, des règles de confidentialité (article 78) et du régime de sanctions (articles 99 et 100). C’est à cette date que le Code de bonnes pratiques pour les GPAI et les seuils de risque systémique sont devenus la grille de référence pour les fournisseurs de modèles de fondation. Point important : le Digital Omnibus ne touche pas à ce volet GPAI. Les fournisseurs de modèles doivent continuer leur travail de conformité comme prévu.

    Autrement dit, contrairement à une idée répandue, l’AI Act n’est pas « en attente » : une partie substantielle de ses obligations est déjà du droit dur applicable.

    Le Digital Omnibus comme tournant pour l’année 2026

    Dès la fin 2025, la mise en œuvre était visiblement en retard. Deux goulets d’étranglement en particulier : la désignation par les États membres de leurs autorités nationales compétentes (Orad), et surtout la finalisation des normes harmonisées (CEN-CENELEC) censées servir de colonne vertébrale technique aux exigences sur les systèmes à haut risque. Sans ces normes, demander aux entreprises de se conformer revenait à leur fixer un examen sans en avoir publié le programme.

    Sur fond d’agenda européen de « simplification » et de pression concurrentielle, la Commission a donc déposé le 19 novembre 2025 une proposition de Digital Omnibus on AI. Le processus législatif a ensuite été mené à un rythme inhabituellement rapide :

    • 13 mars 2026 : position du Conseil (orientation générale)
    • 26 mars 2026 : position du Parlement
    • 7 mai 2026 : accord politique provisoire en trilogue
    • 16 juin 2026 : vote final du Parlement (423 voix pour, 57 contre, 174 abstentions)
    • 29 juin 2026 : adoption formelle attendue au Conseil, puis publication au Journal officiel (entrée en vigueur trois jours après publication, vraisemblablement en juillet)

    Il fallait que ce texte soit en vigueur avant le 2 août 2026, faute de quoi le calendrier d’origine se serait appliqué tel quel.

    Ce que le texte change réellement :

    Le message à retenir est subtil : certaines échéances ont reculé, une nouvelle obligation est apparue, et plusieurs échéances n’ont pas bougé du tout. C’est cette nuance qu’un calendrier brut ne sait pas rendre.

    Ce qui recule :

    • Les obligations sur les systèmes à haut risque « autonomes » (annexe III : emploi, éducation, biométrie, infrastructures critiques, services essentiels, justice, migration, maintien de l’ordre) passent du 2 août 2026 au 2 décembre 2027, soit un report de seize mois.
    • Les obligations sur les systèmes à haut risque « intégrés » dans des produits réglementés (annexe I : dispositifs médicaux, machines, ascenseurs, jouets, équipements radio…) passent du 2 août 2027 au 2 août 2028.
    • La date pour les bacs à sable réglementaires nationaux (au moins un par État membre) glisse au 2 août 2027.
    • Les privilèges réservés aux PME (notamment sur les sanctions) sont étendus à une nouvelle catégorie, les petites entreprises de capitalisation moyenne (« small mid-caps »).

    Ce qui n’a pas bougé  :

    • L’essentiel des obligations de transparence de l’article 50 reste applicable au 2 août 2026. Informer l’utilisateur qu’il interagit avec une IA, signaler la reconnaissance d’émotions ou la catégorisation biométrique, divulguer les hypertrucages (deepfakes) côté déployeur : tout cela arrive bien à l’échéance initiale. Les organisations qui ont cru que « le 2 août 2026 est repoussé » ouvrent un trou de conformité.

    Ce qui est nouveau :

    • Une nouvelle interdiction est insérée à l’article 5, applicable au 2 décembre 2026 : les systèmes d’IA conçus pour générer des images intimes non consenties (les applications dites « nudifier ») et des contenus pédocriminels (CSAM). Elle vise aussi bien les fournisseurs qui mettent ces systèmes sur le marché que les déployeurs. Pour tout fournisseur d’un modèle de génération d’images, la conception de garde-fous (« safe harbour ») doit faire partie intégrante de la documentation de gestion des risques, il n’y a pas de voie « on le rajoutera plus tard ».
    • L’obligation de marquage des contenus synthétiques (filigrane / watermarking, article 50(2)) bénéficie d’un délai de grâce raccourci à trois mois : elle devient exigible le 2 décembre 2026. Concrètement, tout contenu généré par IA devra être étiqueté de façon lisible par machine. Pour les équipes techniques, c’est l’échéance la plus proche et la plus opérationnelle.

    Le texte comporte aussi des ajustements plus discrets et plus contestés : assouplissement des exigences de littératie en IA, élargissement de la possibilité de traiter des données personnelles sensibles pour détecter et corriger les biais, clarification des compétences du Bureau de l’IA, et réduction des informations à publier dans la base de données publique pour les systèmes que les fournisseurs estiment non à haut risque (une obligation d’enregistrement simplifiée a toutefois été réintroduite).

    Le nouveau calendrier de 2026 pour l’IA act :

    Date Échéance Statut
    Fin juin / juillet 2026 Adoption formelle et publication du Digital Omnibus au Journal officiel Imminent
    2 août 2026 Application de la majorité des obligations de transparence (article 50) Maintenu
    2 août 2026 Application du reste du règlement, à l’exception des obligations haut risque reportées Maintenu, mais vidé de sa charge la plus lourde
    2 décembre 2026 Interdiction des « nudifiers » et du CSAM généré par IA (article 5) Nouveau
    2 décembre 2026 Marquage obligatoire des contenus générés par IA (article 50(2)) Nouveau délai

    Mais ces reports, l’année n’est pas un répit, c’est une redistribution  : le poids s’est déplacé de l’inventaire et de la classification des systèmes à haut risque (désormais 2027-2028) vers la transparence et le marquage des contenus synthétiques (août et décembre 2026).

    Et après ? Le futur de l’AI Act

    Les grandes échéances 2027-2028 :

    • 2 décembre 2027 : entrée en application des obligations pour les systèmes à haut risque autonomes (annexe III). C’est désormais l’horizon central pour la plupart des entreprises.
    • 2 août 2028 : entrée en application pour les systèmes à haut risque intégrés dans des produits réglementés (annexe I).

    Un point trop peu souligné : ces nouvelles dates s’appliquent que les normes harmonisées soient prêtes ou non. L’argument initial du report était précisément l’attente des normes ; le compromis politique a néanmoins fixé des dates fermes. Si les normes arrivent en retard, les échéances ne reculeront pas avec elles. Les entreprises qui attendraient la publication des normes pour commencer leur inventaire prennent donc un risque réel.

    L’horizon plus lointain (2029-2031) :

    Au-delà, le règlement prévoit une série de clauses de revoyure : évaluation du fonctionnement du Bureau de l’IA (2028), réexamens périodiques des annexes et de la liste des pratiques à transparence renforcée, rapports d’évaluation au Parlement et au Conseil (à partir de 2029, tous les quatre ans), mise en conformité des grands systèmes d’information de l’annexe X d’ici fin 2030, et premier bilan d’application complet en 2031. C’est la phase de « vie longue » du règlement, celle où il sera ajusté à l’usage.

    Résumé du calendrier de l’IA Act depuis 2024 :

    Calendrier de l'IA Act depuis 2024 - H&TI
    Calendrier de l’IA Act depuis 2024 – H&TI
  • Expérience patient : L’Ifep veut en faire un levier stratégique du système de santé d’ici 2030

    Passer d’initiatives locales à une véritable stratégie nationale

    Depuis plusieurs années, les démarches visant à mieux intégrer le vécu des patients se multiplient dans les établissements de santé. Questionnaires d’expérience, patients partenaires, co-construction des parcours ou encore implication des proches : les initiatives se sont diversifiées et les bénéfices sont désormais largement documentés.

    Pour l’Ifep, le principal défi n’est donc plus de démontrer l’intérêt de ces approches, mais de changer d’échelle. Le manifeste défend l’idée que l’expérience patient ne doit plus être considérée comme un projet annexe ou un simple indicateur de satisfaction, mais comme un levier transversal d’amélioration de la qualité, de la pertinence des soins et de l’organisation du système de santé.

    Cette orientation rejoint les annonces de la ministre de la Santé, Stéphanie Rist, lors de son discours aux Trophées de l’Expérience Patient 2026 où elle a réaffirmé sa volonté de structurer une politique nationale dédiée à l’expérience patient.

    Quatre priorités pour transformer durablement le système :

    Pour atteindre cet objectif à l’horizon 2030, le manifeste identifie quatre axes structurants :

    • renforcer la participation des citoyens aux transformations du système de santé ;
    • intégrer davantage l’expérience patient dans la formation initiale et continue des professionnels ;
    • favoriser le partage des retours d’expérience et les démarches d’innovation collaborative ;
    • développer les travaux de recherche permettant de mieux comprendre et mesurer l’expérience vécue par les patients et leurs proches.

    Au-delà de ces orientations, le texte insiste sur une évolution culturelle : considérer les retours des usagers non comme une évaluation a posteriori, mais comme une ressource mobilisable pour améliorer les organisations, les parcours et les pratiques professionnelles.

    L’expérience patient comme marqueur des transformations à venir

    Le manifeste rappelle également que cette ambition ne peut être dissociée d’un autre enjeu majeur : l’accès aux soins. Une expérience de qualité suppose d’abord un parcours accessible, coordonné et équitable.

    En appelant l’ensemble des établissements, fédérations, associations, institutions et entreprises à rejoindre cette démarche, l’Ifep cherche ainsi à fédérer un mouvement collectif autour d’une conviction simple : la qualité du système de santé ne se mesure plus uniquement par ses résultats cliniques, mais également par la manière dont les patients vivent leur parcours.

    À l’heure où les établissements investissent dans le numérique, l’intelligence artificielle ou la transformation organisationnelle, ce manifeste rappelle qu’aucune innovation ne pourra produire pleinement ses effets sans intégrer l’expérience des patients et des professionnels comme un véritable indicateur stratégique.

  • IA & Cancer : l’INCa et l’Université Paris Cité créent la chaire de recherche « Intelligence artificielle et recherche clinique en oncologie »

    Une chaire pour répondre à de nouveaux défis auxquels sont confrontés les essais cliniques

    L’évolution de la médecine de précision transforme profondément la recherche en cancérologie. L’identification de sous-groupes de patients de plus en plus spécifiques améliore le ciblage thérapeutique, mais complexifie également la conduite des essais cliniques. Le recrutement devient plus difficile, les coûts augmentent et les méthodologies traditionnelles montrent parfois leurs limites.

    Dans ce contexte, l’intelligence artificielle apparaît comme un levier majeur pour exploiter les données de vie réelle, améliorer la conception des études et renforcer leur validité scientifique. Mais l’intégration de ces nouvelles approches soulève aussi des enjeux méthodologiques, réglementaires et éthiques qui nécessitent un cadre robuste et partagé.

    C’est précisément l’ambition de cette nouvelle chaire : structurer la recherche autour de méthodes innovantes tout en garantissant leur fiabilité et leur acceptabilité pour les chercheurs, les cliniciens, les patients et les autorités de santé.

    Une chaire construire autour de trois axes pour construire les essais cliniques de demain

    La chaire s’articulera autour de trois grands domaines de recherche.

    Le premier concerne l’émulation et le redressement d’essais cliniques à partir de données de vie réelle. L’objectif est d’utiliser les données collectées dans les parcours de soins pour mieux estimer l’efficacité des traitements dans les populations réelles et compléter les enseignements issus des essais traditionnels.

    Le deuxième axe porte sur la création de bras de contrôle synthétiques. Cette approche consiste à remplacer ou compléter certains groupes comparateurs par des cohortes construites à partir de données historiques ou observationnelles, particulièrement utiles dans les maladies rares ou lorsque les effectifs sont limités.

    Enfin, la chaire explorera la génération de cohortes simulées grâce à l’IA. Ces patients virtuels pourraient permettre de tester des scénarios d’essais in silico, d’augmenter artificiellement certaines cohortes ou encore de faciliter le partage sécurisé de données.

    Une convergence entre IA, données de santé et recherche clinique :

    Sélectionnée à l’issue d’un appel à candidatures national, la professeure Agathe Guilloux, chercheuse à l’Inria et membre de l’équipe commune HeKA (Inria–Inserm–Université Paris Cité), apportera une expertise reconnue à l’interface entre apprentissage statistique et recherche clinique.

    Ses travaux s’appuieront sur des sources de données variées, incluant notamment les données du Système national des données de santé (SNDS), les entrepôts de données hospitaliers et les données issues des essais cliniques. L’ambition est également d’exploiter des données multimodales et de développer des approches capables d’intégrer imagerie, données cliniques et informations moléculaires.

    Au-delà de la recherche, la chaire entend structurer un véritable écosystème de formation autour de l’IA appliquée à la santé. Enseignements universitaires, masterclasses, diplôme spécialisé et diffusion ouverte des méthodes développées doivent contribuer à faire émerger une nouvelle génération d’experts capables de maîtriser les enjeux méthodologiques de la recherche clinique augmentée par l’IA.

    À travers cette initiative, l’INCa et l’Université Paris Cité affichent une ambition claire : faire de la France un acteur de référence dans la conception des méthodologies qui accompagneront la prochaine génération d’essais cliniques en oncologie. Une orientation qui s’inscrit pleinement dans la stratégie nationale de lutte contre les cancers et dans la montée en puissance des usages de l’intelligence artificielle en santé.