Article 1 – Données de santé synthétiques : d’un concept de laboratoire à une priorité nationale
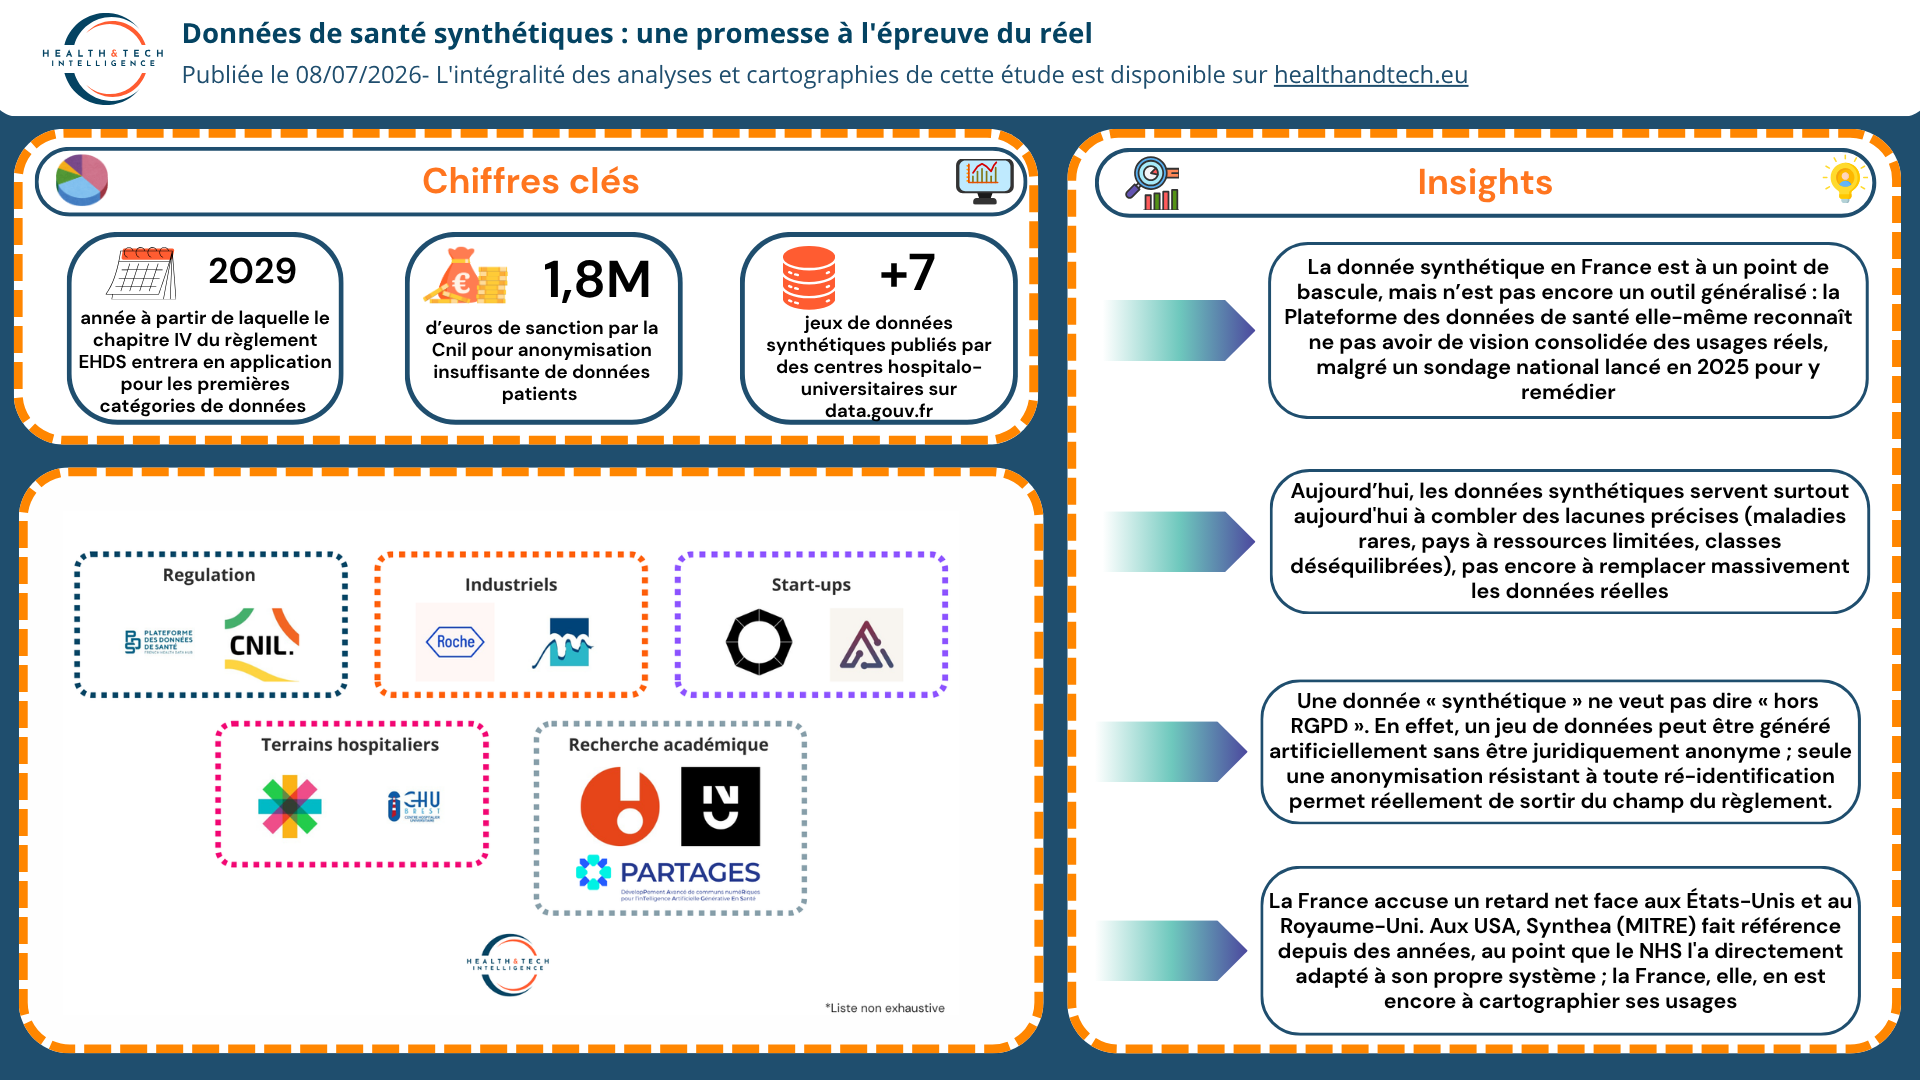
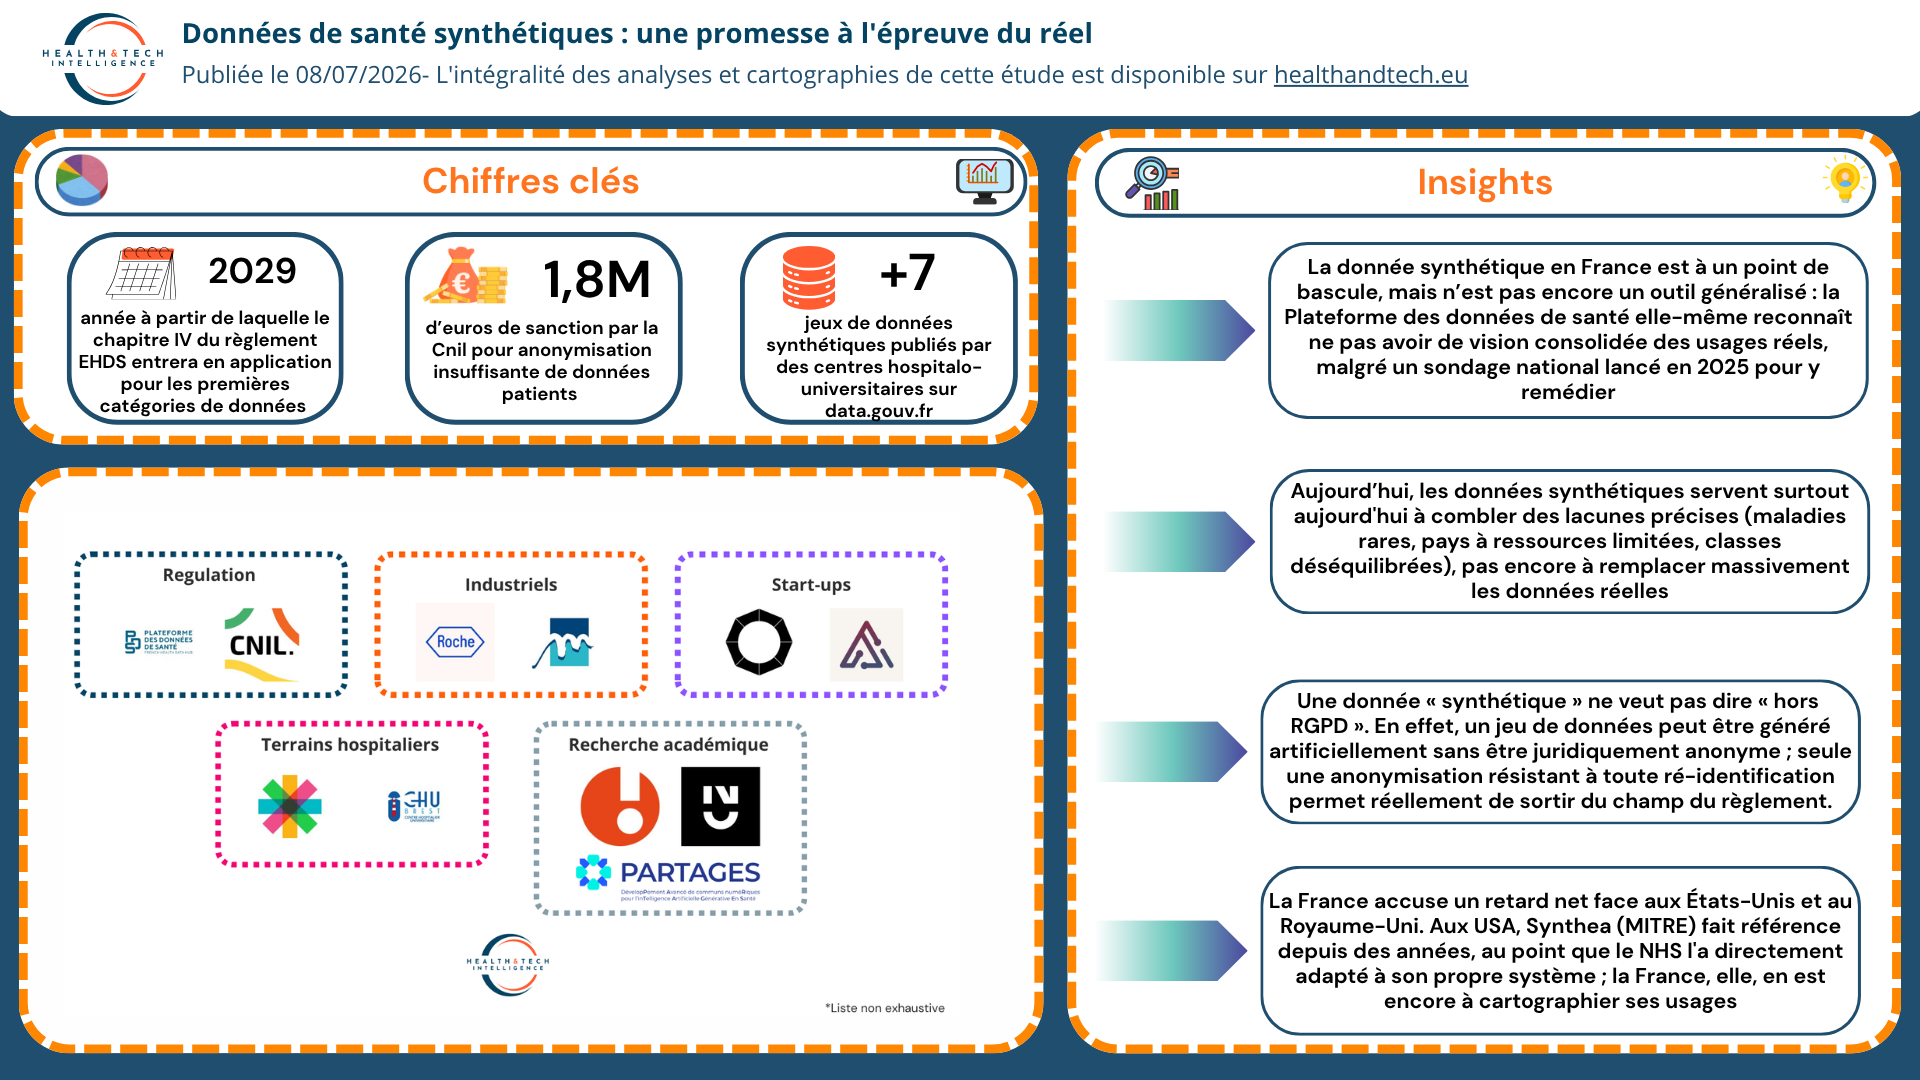
Pendant des années, la donnée de santé synthétique n’était qu’une curiosité de laboratoire. En 2025, elle est devenue une priorité affichée par les institutions françaises. Premiers jeux de données ouverts sur data.gouv.fr, sondage national lancé par la Plateforme des données de santé, entrée en vigueur du règlement européen EHDS : cet article dresse l’état des lieux d’un sujet encore jeune, mais en pleine accélération ; et révèle pourquoi la France, malgré cette dynamique, reste en retard face aux États-Unis et au Royaume-Uni, qui ont plusieurs années d’avance.
👉 Pour en savoir plus : consulter l’article.
Article 2 – Données de santé synthétiques : un cadre juridique encore à construire
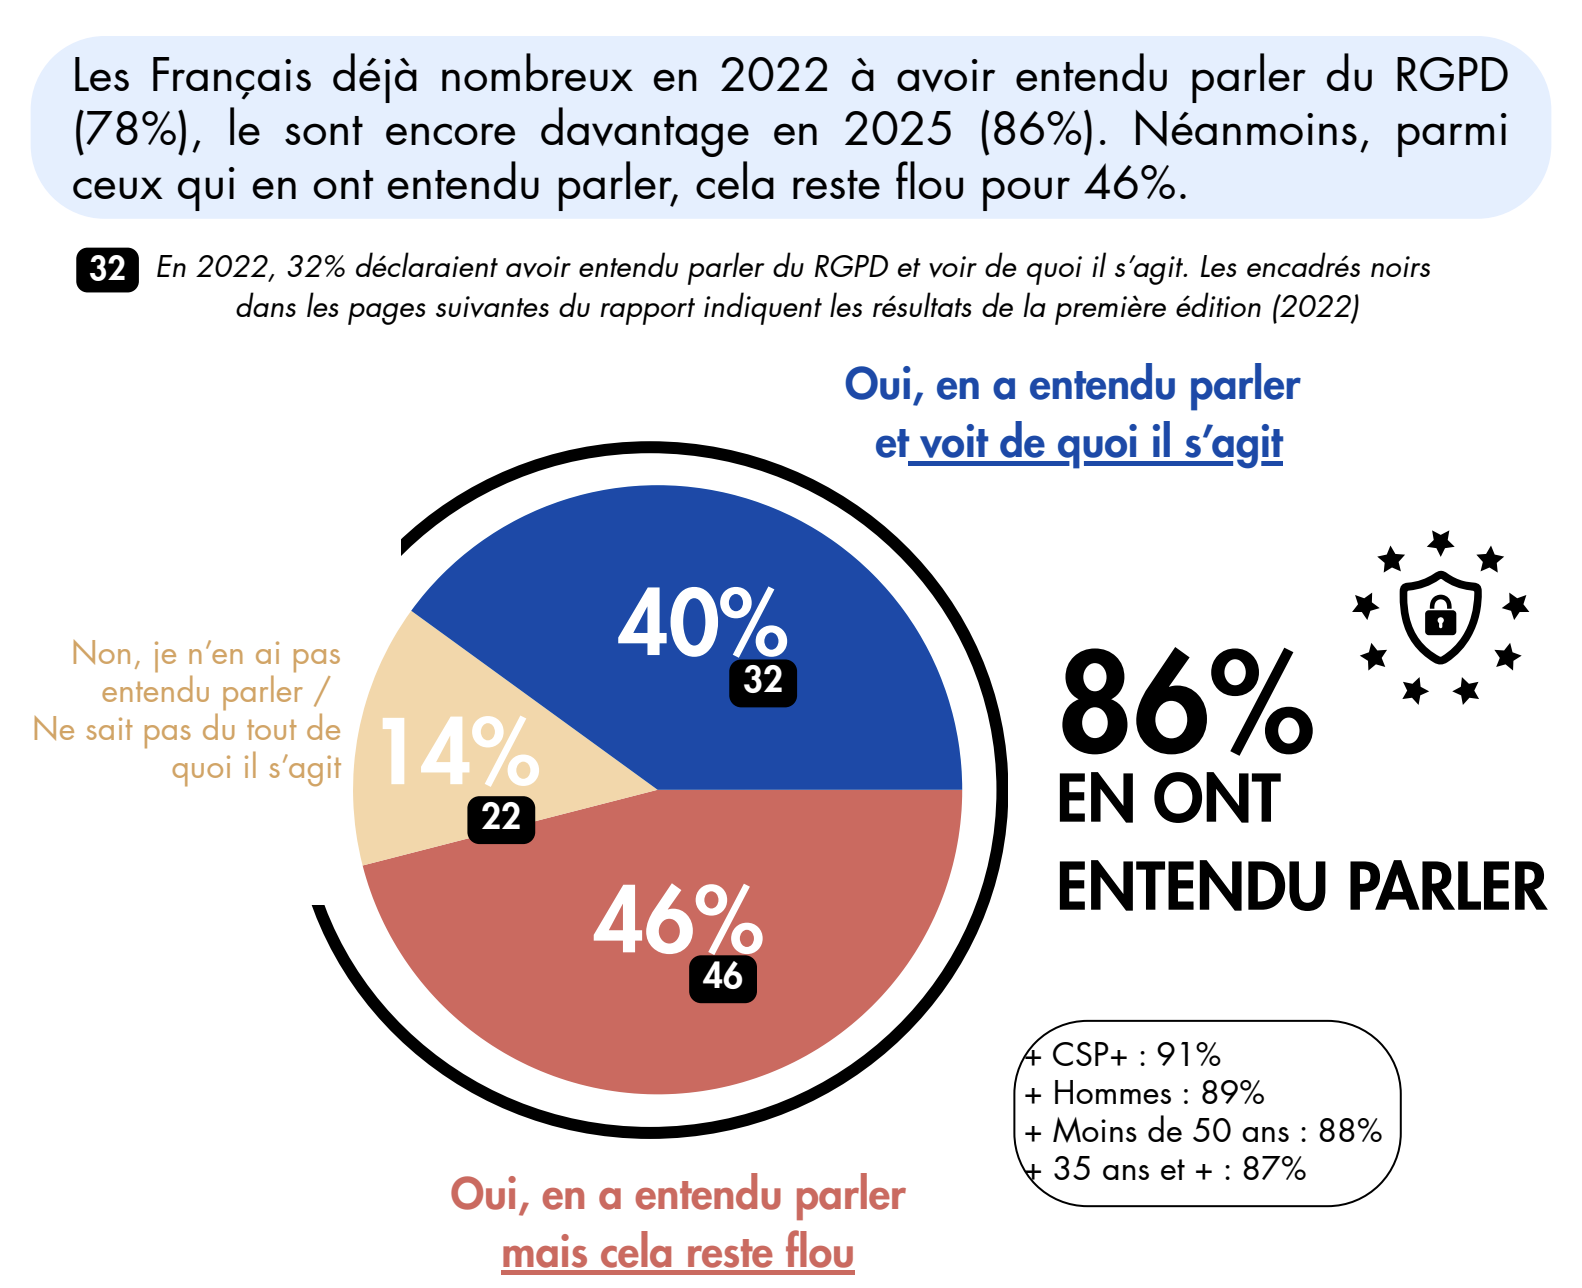
« La donnée synthétique échappe au RGPD » : l’argument séduit, mais le droit ne suit pas encore. Cet article démonte cette fausse promesse à travers un cas concret et récent : une décision du Conseil d’État confirmant 1,8 million d’euros de sanctions pour anonymisation insuffisante de données patients. Entre une Cnil qui n’a toujours pas tranché et un règlement européen EHDS dont les dispositions clés n’entreront en vigueur qu’en 2029, découvrez pourquoi le cadre juridique de la donnée synthétique reste, pour l’instant, un chantier largement ouvert.
👉 Pour en savoir plus : consulter l’article.
Article 3 – Comment fabrique-t-on les données synthétiques ?
La donnée synthétique ne se créée pas avec une méthode unique, mais deux logiques radicalement différentes : simuler une logique clinique à la main, ou laisser un modèle génératif (GAN, diffusion, LLM) apprendre seul les régularités des données réelles. Cet article décortique le fonctionnement de Synthea et des approches génératives, leurs forces et leurs angles morts respectifs. La leçon centrale qui s’en dégage : une donnée peut être statistiquement irréprochable – mêmes moyennes, mêmes distributions – tout en étant cliniquement absurde dans le détail. Un défi qui explique pourquoi l’évaluation d’un jeu de données synthétique est loin d’être triviale.
👉 Pour en savoir plus : consulter l’article.
Article 4 – 7 études démontrent l’intérêt des données de santé synthétiques pour la recherche (revue de littérature)
Maladies rares, pays à ressources limitées, classes de patients sous-représentées : sept études récentes, publiées dans Nature, JAMIA ou le Journal of Biomedical Informatics, documentent déjà des cas concrets où la donnée synthétique comble un vrai manque pour la recherche. Mais un chiffre résume l’angle mort de cette littérature : 17 méthodes existent pour évaluer son utilité, contre seulement 5 pour évaluer ses risques de confidentialité. Cet article fait le bilan scientifique le plus à jour sur ce que la donnée synthétique apporte vraiment à la recherche, et sur ce qu’elle ne garantit pas encore.
👉 Pour en savoir plus : consulter l’article.
Article 5 – Cartographie des acteurs de la donnée synthétique en France
Qui fabrique vraiment la donnée synthétique en France ? Cet article dresse la carte d’un écosystème encore restreint : une plateforme publique qui finance et catalyse, deux start-ups qui portent l’essentiel de la visibilité (mais avec un niveau de preuve très inégal), et deux CHU pionniers qui servent de bancs d’essai. Au centre de cette carte, une pépite nantaise dont la méthode est validée par une publication dans Nature, de quoi devenir un point d’appui pour toute la filière française, encore loin des écosystèmes américain et britannique.
👉 Pour en savoir plus : consulter l’article.