Coumau Cécile

  • Etude : l’évaluation humaine des LLM manque de fiabilité (Nature Digital Medicine)

    LLM en santé : trop d’évaluations automatisées

    Les LLM ont déjà largement pénétré le domaine de la santé. Aide à la décision clinique, surveillance des patients, évaluation des risques… en traitant et en analysant de grandes quantités de données de santé, leurs applications sont multiples. Par conséquent, leur évaluation est cruciale. Et des évaluations humaines s’avèrent essentielles pour garantir leur sécurité et leur efficacité. C’est pourquoi des chercheurs américains de l’université de Pittsburgh ont passé en revue 142 articles scientifiques sur les méthodes d’évaluation des LLM en santé, dont les résultats ont été publiés le 28 septembre dans Nature Digital Medicine.

    Les études examinées dans le cadre de cette revue de la littérature ont présenté un éventail diversifié d’applications des LLM dans le domaine de la santé, de la recherche fondamentale à la pratique clinique et au-delà, visant chacune à améliorer différents aspects :

    • des soins aux patients et de la pratique clinique ;
    • de la recherche en sciences biomédicales et de la santé ;
    • ainsi que de l’éducation.
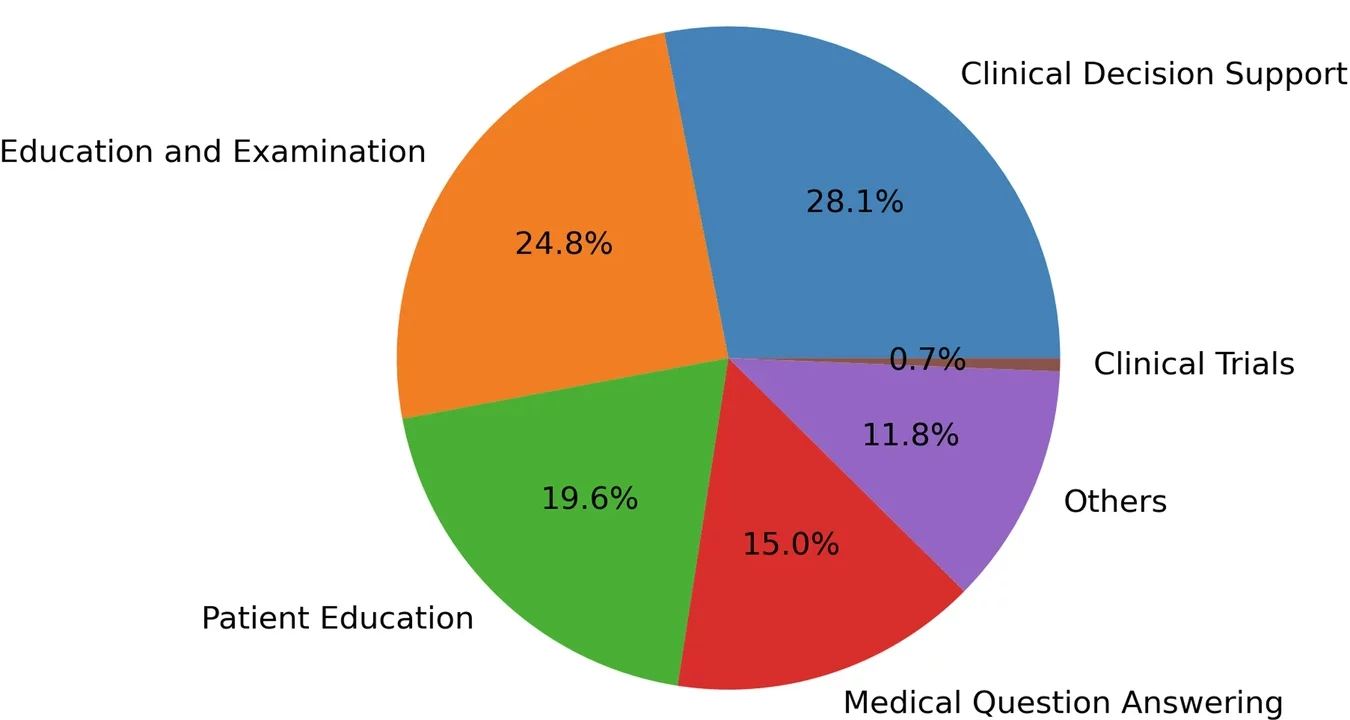
    Applications des LLM en santé - Tam, T.Y.C. et al., 2024
    Applications des LLM en santé – @ Tam, T.Y.C. et al., 2024

    Une revue systématique sur 142 articles :

    Les types et tailles d’échantillons, la sélection et le recrutement des évaluateurs, les cadres et les métriques, le processus d’évaluation et le type d’analyse statistique sont passés au peigne fin. La littérature scientifique actuelle montre que l’évaluation des LLM dans le domaine de la santé repose essentiellement sur des métriques automatisées. Des d’analyses complètes avec des évaluateurs humains font clairement défaut. Plusieurs équipes de recherche ont donc déjà proposé d’améliorer ces méthodes d’évaluation, proposant un cadre standardisé. Cependant, aucune de ces directives n’aborde spécifiquement l’évaluation humaine des LLM en santé.

    C’est pourquoi cette équipe de chercheurs américains (Tam, T.Y.C., Sivarajkumar, S., Kapoor, S. et al.) a mené une revue systématique de la littérature existante sur le sujet.

    Résultats : la radiologie, 1re consommatrice de LLM

    • Les LLM sont surtout utilisés en santé dans les domaines suivants : 28,1% aide à la décision, 24,8% examens, 19,6% éducation des patients, 15% questions-réponses entre patients et médecins
    • Les tâches administratives et le soutien en santé mentale, représentent chacune moins de 11,8 % du total.
    • La radiologie est la spécialité qui utilise le plus les LLM, suivie de l’urologie et de la chirurgie générale.
    • En radiologie, l’évaluation humaine joue un rôle crucial dans l’évaluation de la qualité et de la précision des rapports générés. Elle permet également d’évaluer l’utilité clinique et l’interprétabilité des résultats produits par les LLM.
    • En chirurgie générale, l’évaluation humaine se concentre sur l’application pratique des LLM dans la planification préopératoire, les simulations chirurgicales et les soins postopératoires.
    • En médecine d’urgence, l’évaluation humaine se concentre souvent sur la prise de décision critique et le soutien au triage.

    Des “boîtes noires” qui restent obscures :

    Par ailleurs, les chercheurs ont observé que le fonctionnement interne de ces modèles reste opaque, autrement dit, ce sont encore des “boîtes noires”. Les articles que nous avons examinés montrent que les évaluations de ces modèles “boîtes noires” reposent généralement sur des tests manuels via une évaluation humaine, ce qui met en lumière un problème majeur : le manque de traçabilité, de fiabilité et de confiance. « Les sources des textes, les processus de raisonnement utilisés dans les réponses générées, et la fiabilité des preuves à des fins médicales ne sont souvent pas transparents », regrettent les auteurs de l’étude. La plupart des études ont utilisé de petits échantillons et une diversité limitée d’évaluateurs, ce qui affecte la robustesse des évaluations, en particulier pour les applications à haut risque comme le soutien à la décision clinique. Il n’est donc pas toujours possible de savoir clairement d’où viennent les informations, comment les modèles prennent leurs décisions, ou si ces informations sont fiables pour un usage médical. De telles lacunes présentent « un risque d’évaluations incohérentes et peu fiables, ce qui pourrait compromettre la sécurité des patients ».

    A la recherche d’un cadre d’évaluation des LLM :

    De plus, les méthodes traditionnelles d’évaluation en traitement automatique du langage sont jugées « sous optimales » et « inadéquates » pour les LLM. Par conséquent, les chercheurs de Pittsburgh proposent des lignes directrices pour l’évaluation humaine des LLMs. Ils suggèrent de mettre en place une méthode d’évaluation standardisable. QUEST est conçue sur cinq principes d’évaluation : Qualité de l’information, Compréhension et Raisonnement, Style d’expression et Persona, Sécurité et Risques, et Confiance et Assurance. Les auteurs reconnaissent que ce cadre présente malgré tout des limites, notamment liées aux contraintes spécifiques des sous-spécialités et/ou des institutions susceptibles de l’adopter. Sa généralisation n’est donc pas évidente, d’autant que « les politiques institutionnelles, les infrastructures technologiques, les ressources et la disponibilité du personnel qualifié en informatique varient considérablement, compliquant davantage la mise en œuvre », concluent ces derniers.


    * A framework for human evaluation of large language models in healthcare derived from literature review.

    Tam, T.Y.C., Sivarajkumar, S., Kapoor, S. et al. 

    npj Digit. Med. 7, 258 (2024). https://doi.org/10.1038/s41746-024-01258-7

  • Etude : la fiabilité des grands modèles de langage d’IA ne progresse pas (Nature)

    Modèles de langage : peut-on leur faire confiance ?

    Les LLM de dernière génération ont été entraînés sur plus de paramètres, des ensembles de données plus volumineux, pendant plus longtemps, ils ont été affinés grâce aux retours humains… mais sont-ils plus fiables ? C’est ce qu’ont voulu savoir des chercheurs de l’Université Polytechnique de Valence et de l’Université de Cambridge. Ils ont donc passé au crible les performances de plusieurs familles de LLM : GPT développée par OpenAI, LLaMA développée par Meta, et la suite BLOOM développée par BigScience. Dans leur version brute, telle GPT-3 ada, et leur version ajustée et donc plus aboutie. Ils ont été testés dans 5 domaines : la numération (addition), le maniement du vocabulaire (anagramme), les connaissances géographiques, les compétences scientifiques, et la « transformation » qui regroupe des tâches cognitives de manipulation d’informations.

    Les résultats de leur étude ont été publiés le 25 septembre dans Nature.

    Résultats : une “involution” de la fiabilité

    • À mesure que la difficulté augmente, la correction diminue nettement pour tous les modèles.
    • Une fiabilité totale n’est pas atteinte aux niveaux de difficulté les plus faibles. Bien que les modèles puissent résoudre des cas extrêmement complexes, ils échouent encore sur des instances très simples.
    • Pour la famille LLaMA, aucun modèle n’atteint 60 % de correction au niveau de difficulté le plus simple.
    • Seule exception : en science, GPT-4 atteint des niveaux presque parfaits jusqu’aux niveaux de difficulté moyenne.
    • Les modèles ajustés donnent à la place des réponses apparemment plausibles mais incorrectes. Et ils renoncent à répondre moins souvent.

    Globalement, cette étude met en évidence “une involution de la fiabilité”. Les résultats de cette étude posent donc la confiance que nous avons dans les LLM. Et les données montrent qu’elle risque fort d’être ébranlée. Et ce pour plusieurs raisons. Tout d’abord, « “les modèles peuvent résoudre certaines tâches complexes en accord avec les capacités humaines, mais en même temps, ils échouent sur des tâches simples dans le même domaine. Par exemple, ils peuvent résoudre plusieurs problèmes mathématiques de niveau doctorat, mais en même temps, ils peuvent se tromper sur une simple addition”, note Hernández-Orallo, co-auteur de l’étude. De plus, n’étant pas 100 % précis sur des tâches simples, « cela signifie qu’il n’existe pas de ‘zone sûre’ où l’on pourrait faire entièrement confiance aux modèles”, a ajouté la chercheuse Yael Moros Daval.

    Des réponses trop affirmatives

    Autre élément qui peut alimenter la défiance : les modèles de langage récents ont beaucoup plus tendance à fournir des réponses incorrectes plutôt que d’éviter de répondre à des tâches dont ils ne sont pas sûrs. D’après les chercheurs, ce comportement imprudent a été encouragé par les développeurs qui conçoivent des modèles qui ne sont « jamais évasifs ». Par conséquent, le pourcentage de résultats incorrects augmente nettement entre les modèles bruts et les modèles ajustés. En outre, les chercheurs ont découvert que la supervision humaine ne permet pas de compenser ces problèmes car pour le moment, nous avons tendance à trop nous fier aux modèles et à ne pas reconnaître les résultats incorrects à différents niveaux de difficulté.

    Les chercheurs en concluent qu’« un changement fondamental est nécessaire dans la conception et le développement de l’IA à usage général, en particulier pour les applications à haut risque, où la prédiction des performances des modèles de langage et la détection de leurs erreurs sont primordiales. »


  • Etude : ChatGPT aussi performant que les radiologues pour dépister des tumeurs cérébrales (European Radiology)

    Tumeurs au cerveau : l’apport des LLM

    L’utilisation de LLM tels que ChatGPT dans le diagnostic, et tout particulièrement radiologique, fait l’objet de nombreuses études. Mais, à ce jour, « aucune étude n’a évalué son utilisation à partir de rapports neuoradiologiques réels, affirment des chercheurs japonais de l’Université Métropolitaine d’Osaka. Contrairement aux quiz, qui présentent généralement des cas soigneusement sélectionnés et typiques, créés par des individus connaissant déjà le bon diagnostic, les rapports radiologiques réels peuvent contenir des informations moins structurées et plus diverses. Cette différence pourrait entraîner des évaluations biaisées qui ne reflètent pas la nature complexe de la radiologie clinique », ajoutent ces derniers.

    Pour combler cette lacune, cette équipe de chercheurs a donc collecté 150 rapports d’IRM cérébrale de patients atteints de tumeurs cérébrales préopératoires dans deux établissements, de janvier 2017 à décembre 2021. Leur but : évaluer les capacités et les limitations potentielles de GPT-4 en tant qu’outil diagnostique dans un cadre clinique réel. Et les comparer l’exactitude des diagnostics avec celle de deux neuroradiologues et des trois radiologues généralistes.

    Les résultats de cette étude ont été publiés le 1er octobre dans la revue European Radiology.

    Résultats : Chat-GPT surpasse les radiologues sur le diagnostic différentiel

    • GPT-4 a démontré une exactitude diagnostique comparable à celle des neuroradiologues et des radiologues généralistes avec des taux respectifs de 73 %, 72 % et 68 %.
    • En termes de diagnostic différentiel, ChatGPT a surpassé les spécialistes puisqu’il atteignait un taux d’exactitude de 94% contre 88% pour les neuroradiologues et 77,3 % pour les radiologues généralistes.
    • ChatGPT s’est montré beaucoup plus performant lorsqu’il utilisait des rapports rédigés par des neuroradiologues par rapport à ceux rédigés par des radiologues généralistes. L’exactitude du diagnostic était de 80 % vs 60 %.

    Ces résultats suggèrent que GPT-4 pourrait être utilisé dans des contextes cliniques par les neuroradiologues comme second avis pour les aider à formuler des diagnostics finaux et différentiels. « Pour les radiologues généralistes, GPT-4 peut être particulièrement utile pour comprendre les indices diagnostiques et apprendre les diagnostics différentiels, qui peuvent parfois être chronophages, ajoutent-ils. Lorsqu’un radiologue généraliste est confronté à des cas complexes ou inconnus, consulter GPT-4 pourrait orienter leur réflexion diagnostique. »

    “Réduire la charge des médecins”

    Cette étude présente cependant plusieurs limites. L’utilisation unique des rapports de radiologie à l’exclusion de toute autre information telles que les antécédents du patient et les images elles-mêmes constitue la principale. Les bonnes capacités diagnostiques de GPT-4 laissent malgré tout la porte ouverte à une utilisation en clinique pour les tumeurs cérébrales. Et à l’avenir, les chercheurs japonais ont  « l’intention d’étudier les grands modèles linguistiques dans d’autres domaines d’imagerie diagnostique dans le but de réduire la charge des médecins, d’améliorer l’exactitude des diagnostics et d’utiliser l’IA pour soutenir les environnements éducatifs. »


    * Comparative analysis of GPT-4-based ChatGPT’s diagnostic performance with radiologists using real-world radiology reports of brain tumors.

    Mitsuyama, Y., Tatekawa, H., Takita, H. et al. 

    Eur Radiol (2024). https://doi.org/10.1007/s00330-024-11032-8

  • Etude : les enjeux de l’intégration des LLM dans la pratique oncologique (Lancet)

    Dossiers médicaux : l’IA pour décrypter les informations clés

    A l’hôpital, lorsqu’un soignant consulte le dossier médical d’un patient, plus de 80 % des fichiers sont sous forme narrative. La majorité de ces dossiers cliniques textuels contiennent des informations clés. Tout naturellement, le traitement automatique du langage naturel (NLP) a connu un grand développement ces dernières années, y compris pour des tâches liées au soutien à la décision thérapeutique en oncologie. Pourtant, leur impact sur la pratique clinique n’est pas encore déterminant. Parmi les 71 dispositifs approuvés par la FDA dans des domaines liés à l’oncologie en 2022, seuls trois pouvaient influencer la décision thérapeutique, tous étant des systèmes de planification de la radiothérapie. Récemment, des efforts ont donc été menés pour améliorer l’efficacité et étendre les capacités d’analyse des données. Il faut dire que les LLM ont le potentiel d’aider les oncologues dans des tâches telles que l’estimation du pronostic, les recommandations de traitement et l’appariement des patients avec des essais cliniques.

    Bilan et perspective des LLM

    Pour favoriser l’intégration de ces outils dans la pratique clinique des oncologues, des chercheurs français du Centre Léon Bérard de Lyon et de l’Institut Gustave Roussy de Villejuif ont fait le point sur les dangers des LLM et ont listé des recommandations. Leur article a été publié en septembre dans The Lancet Regional Health Europe.

    • Le « côté sombre des LLMs »

    Les auteurs de ce papier ont listé 11 problèmes potentiels posés par les modèles de langage. Ils soulignent notamment leur impact environnemental (grande consommation d’énergie et d’eau), le travail « aliénant » des « click workers » indispensable au développement des LLM, mais aussi le fait qu’ils induisent des discriminations en tout genre. Autre défaut majeur des LLM : « Les modèles d’apprentissage profond peuvent s’appuyer sur des informations inattendues et parfois indésirables » pouvant « conduire à des erreurs de diagnostic », écrivent les auteurs de l’article. En outre, ces derniers pointent du doigt « le défi de la reproductibilité dans l’IA ». « Même avec des entrées identiques (données et paramètres), un algorithme peut produire des modèles avec des niveaux de précision et des vitesses de convergence significativement différents », indiquent-ils. Enfin, la relation médecin-patient pourrait être mise à mal quand les décisions thérapeutiques s’appuient fortement sur les recommandations de l’IA.

    • « Le bon côté des LLM »

    Ces écueils ne sont cependant pas une fatalité. L’équipe de chercheurs français émet donc des recommandations pour que le recours aux LLM en oncologie soit structuré, éthique et efficace. La qualité des données est évidemment un pilier fondamental. Ils préconisent notamment d’utiliser des modèles capables de gérer efficacement les valeurs manquantes. Mais aussi d’avoir recours à des statisticiens afin de choisir le type de données le mieux adapté à l’évaluation du modèle, en fonction de la nature des données disponibles (données de survie, données continues, données catégorielles, texte, etc.). L’utilisation clinique en dépend. Idéalement, il faudrait aussi se doter de nouvelles données externes. Même si le partage de données soulève des défis éthiques. La tâche n’est pas aisée car selon une étude mentionnée par les auteurs, il existe 450 ensembles de données uniques sur le traitement du langage naturel clinique et biomédical, dont moins de 30 % étaient disponibles publiquement, et seulement 10 % étaient jugés directement pertinents pour les tâches cliniques. L’accès aux données cliniques narratives en oncologie reste un grand défi.

    Le besoin d’essais cliniques en oncologie

    Concernant l’entraînement du modèle, les chercheurs posent la question : « Ai-je vraiment besoin d’entraîner un nouveau modèle ? Et ce à cause de l’impact environnemental de cette étape mais aussi parce qu’il existe un risque de transmission des biais aux modèles descendants. « Évaluer la performance de généralisation implique d’évaluer comment le modèle se comporte sur des données non vues pour s’assurer qu’il va au-delà de l’ensemble d’entraînement », écrivent-ils. Enfin, ils préconisent d’adopter une approche multidisciplinaire pour équilibrer innovation et sécurité des patients. Et cela va sans dire, mais ils préfèrent le mentionner : veiller à ce que le rôle de l’IA reste celui d’un outil d’aide plutôt que d’un décideur.

    En conclusion, le traitement du langage naturel (NLP) par les LLM est un outil précieux mais, pour transformer l’essai et passer au stade clinique, les chercheurs recommandent que soient menés des essais cliniques prospectifs pour évaluer les systèmes d’aide à la décision basés sur l’IA dans des environnements réels d’oncologie.

    *Artificial intelligence in oncology: ensuring safe and effective integration of language models in clinical practice

    Verlingue, Loïc et al.
    The Lancet Regional Health – Europe, Volume 46, 101064
  • Avis : le CNRS alerte sur le risque d’attachement aux robots sociaux

    Les robots sociaux envahissent nos vies

    Pour rompre l’isolement des personnes âgées, de nombreux ehpad ont adopté Paro, la peluche phoque. Ce robot émotionnel a pour but de véhiculer les bénéfices de la thérapie animalière auprès notamment des personnes souffrant de la maladie d’Alzheimer. Très populaire, ce robot ne fait cependant pas l’unanimité. Certains établissements préfèrent l’original à la copie, et accueillent donc des chiens et des chats. Ces différences d’approche illustrent la question sur laquelle le comité d’éthique du CNRS (Comets) s’est penché. Quelle est la place que nous devons accorder aux robots sociaux ? Il a publié son avis* le 1er juillet dernier.

    Trop humains ?

    Certes, plusieurs recommandations éthiques ont déjà été formulées sur les chatbots et autres agents conversationnels mais « toutes ces réflexions ont toutefois trop souvent négligé un phénomène qui accompagne l’usage croissant de certains de ces robots, à savoir l’attachement aux robots dits « sociaux », indique Christine Noiville, la directrice du Comets. La question est centrale puisque ces dispositifs ressemblent à des humains : ils parlent, ils détectent nos émotions et en simulent à leur tour… Résultat : « L’utilisateur tend alors à attribuer à la machine des capacités humaines (intelligence, conscience, bienveillance, empathie), à se projeter dans une interaction affective avec elle, à développer l’illusion que se noue un lien intime et de confiance entre elle et lui, voire à s’y attacher, » écrivent les auteurs de l’avis. Des risques d’emprise, d’addiction, de désocialisation, et surtout de manipulation sont donc pointés du doigt par le Comets. Alors que ces robots visent à nous apporter du bien-être, à combler des manques affectifs, ces derniers pourraient en effet avoir des effets pervers, nous éloigner des humains et nous faire croire que nos vrais amis sont ces robots.

    Face à de tels dangers, le Comets interpelle donc les chercheurs, les incitant à s’interroger sur « l’utilité de mettre au point des robots sociaux expérimentaux mimant le plus possible l’humain, jusqu’à ses hésitations dans le langage, l’expression des émotions. »

    Le CNRS interpelle les chercheurs

    Le Comets a donc formulé 5 recommandations en direction de la recherche publique :

    • développer des formations aux enjeux éthiques (dans les cursus scientifiques et techniques et pour les personnels de recherche concernés), et se familiariser davantage avec la littérature internationale consacrée à ces questions et en débatte collectivement ;
    • s’interroger sur les finalités de la recherche, des applications et des choix de conception, comme sur les avantages et les inconvénients à donner aux robots une forme ou un comportement humanoïde ou des capacités à capter et à simuler les émotions ;
    • mener des études scientifiques de long terme et à grande échelle sur : – les relations que les utilisateurs nouent avec « leurs » robots sociaux et sur les incidences en termes de cognition, de psychisme, d’attachement, d’autonomie d’actions et de décisions ; – les effets du déploiement des robots sociaux sur les relations entre humains ;
    • renforcer les recherches interdisciplinaires et indépendantes associant aux travaux en informatique, en robotique, en sciences du comportement, du traitement du langage, etc., des recherches en psychologie, neurosciences, linguistique, sociologie, droit, éthique, philosophie, anthropologie ;
    • créer un observatoire pour collecter à grande échelle et à long terme les données relatives à l’utilisation de robots sociaux.

    Concernant la ressemblance des robots sociaux avec les humains, plusieurs études ont été menées sur le sujet, dont une qui devrait interpeller les concepteurs de ces dispositifs. Parue dans Plos One en novembre 2023, elle révèle que les robots sociaux peuvent être victimes de violences de la part de leurs utilisateurs et surtout que les mieux acceptés étaient ceux qui ressemblaient… le moins à des humains.

    *Avis du COMETS  « Le phénomène d’attachement aux robots dits « sociaux ». Pour une vigilance de la recherche scientifique »

  • Etude : la sélection des embryons par IA n’améliore pas le taux de grossesse (Nature)

    L’enjeu de la sélection du “bon embryon”

    Les techniques d’aide médicale à la procréation ont représenté une révolution mais ce n’est pas une baguette magique. Le taux de naissance atteint au mieux 22% pour les FIV. Sélectionner l’embryon avec les meilleures qualités morpho-cinétiques pour s’implanter reste en effet encore une tâche complexe. Actuellement, pendant la période de culture, l’embryologiste retire les embryons de l’incubateur, généralement à plusieurs reprises, et effectue une évaluation morphologique “instantanée” sous un microscope3. Cette approche est chronophage, subjective et, en substance, n’a guère changé depuis la première naissance par FIV il y a 45 ans. La technologie dite “Time Lapse” est certes intervenue. Concrètement, les embryons sont filmés en continu, des images étant prises toutes les 10 minutes pendant les 5 premiers jours suivant la fécondation.

    Plusieurs équipes de recherche ont donc mis au point des algorithmes aptes à sélectionner les embryons en analysant les images, après avoir été entraînés à repérer les plus susceptibles d’intérêt sur des milliers d’images.

    Cependant, il manque des preuves solides démontrant leur efficacité par rapport aux méthodes traditionnelles pour que ces techniques soient intégrées en routine dans la pratique clinique. Un certain nombre d’études sur l’IA ont bien suggéré des améliorations significatives dans la cohérence de la notation des embryons mais ces évaluations ont été rétrospectives.

    Un 1er essai prospectif :

    Une équipe de chercheurs australiens et européens a donc mis sur pied un essai prospectif randomisé de non-infériorité. Leur but : déterminer si l’apprentissage profond aboutit à un taux de grossesse clinique comparable à celle obtenue par des embryologistes formés utilisant les critères morphologiques standard (avec une marge d’infériorité de 5 %). Ils ont eu recours à l’algorithme d’apprentissage profond iDAScore, développé pour utiliser des motifs morphologiques et morphocinétiques à partir d’images de time-lapse sur les six premiers jours de développement de l’embryon. Quelque 1 066 patientes ont été incluses dans l’essai.
    Les résultats de cette étude ont été publiés le 9 août dans Nature Medicine.

    Résultats : l’IA plus rapide mais pas plus efficace

    • Un taux de grossesse de 46,5% a été obtenu dans le groupe de femmes ayant bénéficié de l’IA contre 48,2% dans le groupe témoin.
    • Le taux de naissance vivante était de 39,8 % dans le groupe iDAScore et de 43,5 % dans le groupe utilisant les critères morphologiques standard
    • Le taux de grossesses intra-utérines non viables était similaire dans les deux groupes.
    • L’évaluation de la qualité des embryons a pris 10 fois moins de temps dans le groupe IA comparé au groupe contrôle (21 secondes vs 208).

    Cette étude n’a donc pas pu démontrer la non-infériorité de l’apprentissage profond en termes de taux de grossesse par rapport à technique traditionnelle. « Cependant, elle a montré que l’apprentissage profond accélère de manière significative les temps d’évaluation par rapport à la sélection d’embryons basée sur la morphologie standard », tiennent à souligner les auteurs.

    Espoirs déçus pour le time lapse :

    Ces derniers font également remarquer que le taux de grossesse constaté dans cette étude est nettement supérieur à leurs prévisions, qui étaient de l’ordre de 35%. « Cette déviation a eu un impact négatif sur la puissance de cet essai à démontrer la non-infériorité », déclarent-ils.

    Cet échec s’ajoute à celui du système time-lapse. Le plus grand essai randomisé réalisé sur le sujet, paru dans The Lancet en 2023, a révélé que « ni les conditions de culture stables dans un incubateur à time-lapse ni la méthode de sélection des embryons informatisée n’améliorent les chances de succès d’un traitement de FIV », indiquaient déjà les auteurs.


    * Deep learning versus manual morphology-based embryo selection in IVF: a randomized, double-blind noninferiority trial

    Illingworth, P.J., Venetis, C., Gardner, D.K. et al.

    Nat Med (2024). https://doi.org/10.1038/s41591-024-03166-5


  • Étude : l’analyse des ondes de l’EEG par IA prometteuse pour dépister les maladies neurodégénératives

    Des informations clés repérées par l’IA dans les EEG

    Les maladies neurodégénératives telles que la maladie d’Alzheimer et la maladie à corps de Lewy provoquent des perturbations électrophysiologiques. Ces anomalies dans les signaux électriques émis par le cerveau peuvent être détectées par électroencéphalogramme (EEG) et ces examens peuvent servir de mesure de la gravité de la maladie. Cependant, l’analyse d’un EEG suppose que les médecins aient sélectionné a priori les caractéristiques des ondes sur lesquelles ils vont se concentrer. Cette méthode traditionnelle a des limites. Elle repose sur le jugement humain pour sélectionner ces caractéristiques, ce qui peut introduire des biais. De plus, certaines informations pertinentes pourraient être ignorées.

    6 caractéristiques pour identifier les troubles cognitifs :

    Pour ne pas passer à côté d’informations médicales cruciales présentes dans les ondes cérébrales, des chercheurs américains de la Mayo Clinic ont développé un nouvel outil. Concrètement, ils ont d’abord rassemblé un grand volume de données, provenant de plus de 11 000 patients qui ont passé des EEG à la Mayo Clinic sur une période de dix ans. Pour analyser ces données complexes, ils ont utilisé des techniques d’IA et de ML qui ont simplifié ces motifs en les réduisant à six caractéristiques spécifiques. En outre, l’outil a ignoré automatiquement les données non pertinentes pour se concentrer uniquement sur les motifs d’ondes cérébrales permettant d’identifier des troubles cognitifs.

    Les résultats de leur étude ont été publiés le 31 juillet dans la revue Brain Communications.

    Résultats : l’IA fait la distinction entre les personnes saines et les malades

    • Les 6 six facteurs choisis pour différencier des sous-groupes de patients représentaient des activités cérébrales biologiquement significatives.
    • Les caractéristiques extraites automatiquement ont montré des précisions de classification élevées entre les sujets cognitivement normaux et ceux atteints de troubles cognitifs légers, et surtout chez les sujets atteints de démence.
    • Ces facteurs ont aussi permis de distinguer les patients souffrant de la maladie d’Alzheimer de ceux atteints par la démence à corps de Lewy.

    Les auteurs de cette étude estiment donc que l’association des EEG de routine avec des méthodes d’analyse automatisées et axées sur les données pourrait mener à un test rapide, non invasif et relativement peu coûteux pour différencier les différentes causes neurodégénératives de troubles cognitifs. En outre, l’IA peut également alerter les experts sur des motifs anormaux trop subtils pour être détectés par l’humain.

    Bien sûr, l’utilisation de l’EEG pour détecter les problèmes cognitifs n’a pas vocation à remplacer d’autres types d’examens, tels que les IRM ou les tomographies par émission de positons (TEP). Mais grâce à la puissance de l’IA, l’EEG pourrait se révéler une option intéressante, notamment dans des zones où l’accès à des équipements spécialisés est limité…


    *Data-driven retrieval of population-level EEG features and their role in neurodegenerative diseases

    Wentao Li, Yogatheesan Varatharajah, Ellen Dicks, Leland Barnard, Benjamin H Brinkmann, Daniel Crepeau, Gregory Worrell, Winnie Fan, Walter Kremers, Bradley Boeve,

    Hugo Botha, Venkatsampath Gogineni, David T Jones

    Brain Communications, Volume 6, Issue 4, 2024, fcae227, https://doi.org/10.1093/braincomms/fcae227

  • Etude : un tiers des radiologues encore sceptiques quant à l’utilisation de l’IA (Eur. J. Radiol)

    L’IA au cœur de la pratique radiologique

    La radiologie est la spécialité médicale qui a adopté en premier l’IA. Elle s’est en effet tournée très tôt vers l’imagerie numérique, ce qui a permis de disposer de vastes ensembles de données d’images médicales de haute qualité, un élément crucial pour l’apprentissage des algorithmes d’IA. En outre, l’analyse d’images radiologiques implique souvent des tâches bien définies, comme la détection de lésions ou la mesure de structures anatomiques. Ce qui correspond bien aux capacités des algorithmes d’IA basés sur le deep learning.

    Cependant, pour que cette technologie entre de plain-pied dans la pratique clinique, encore faut-il que les principaux acteurs soient convaincus de ses bénéfices. C’est pourquoi la Société italienne de radiologie médicale (Sirm) a mené une étude auprès de ses membres. “L’intégration réussie des outils d’IA dans les flux de travail cliniques dépend de l’engagement actif des professionnels de la santé, qui servent de principaux intervenants en interaction quotidienne avec les systèmes d’IA”, a noté Michaela Cellina, du département de radiologie de l’hôpital Fatebenefratelli Sacco à Milan, en Italie. “Par conséquent, comprendre les perceptions et les attitudes des radiologues envers cette technologie transformatrice apparaît comme une priorité critique.”

    Un questionnaire pour sonder l’avis des spécialistes de l’imagerie :

    Quelque 230 d’entre eux ont répondu au questionnaire qui portait sur la satisfaction actuelle des radiologues quant à :

    • l’utilisation des outils basés sur l’IA ;
    • les perceptions du potentiel de l’IA à améliorer des aspects tels que les taux de détection et le flux de travail ;
    • et l’optimisme par rapport aux avantages futurs qui pourraient découler du perfectionnement de la technologie.

    L’enquête a été distribuée à un large éventail de radiologues avec des détails démographiques et des niveaux d’expérience variés. Les résultats de cette étude ont été publiés le 27 juin dans l’European Journal of Radiology.

    Résultats : l’IA pas décisive pour 1 radiologue sur 3

    • Plus de 80 % des radiologues pensent que l’IA améliorera plusieurs aspects du flux de travail en radiologie. L’optimisme est plus net chez les moins de 30 ans et les plus de 60 ans.
    • Environ 40 % des répondants utilisent actuellement l’IA dans leur pratique.
    • Seulement un tiers de ces utilisateurs considèrent que les contributions de l’IA sont décisives.
    • Plus d’un tiers des radiologues se sentent insuffisamment préparés pour utiliser l’IA.
    • 46 % des radiologues de moins de 30 ans déclarent avoir une littératie en IA insuffisante.
    • Deux tiers des sondés voient l’IA comme une opportunité pour améliorer leur domaine plutôt qu’une menace pour leur carrière.
    • 84 % estiment que les radiologues doivent conserver le dernier mot sur les rapports.

    Ces résultats en demi-teinte font dire aux auteurs de l’étude que “malgré l’optimisme général parmi les radiologues, il reste un travail important à accomplir pour améliorer l’intégration et l’utilisation généralisée des outils d’IA dans la pratique clinique.” Ils préconisent donc d’initier des programmes éducatifs sur l’IA pour tous les niveaux d’expérience et que la formation continue en IA soit recommandée tout au long de la carrière des radiologues.


    * Radiologists’ perceptions on AI integration: An in-depth survey study.

    Cè M, Ibba S, Cellina M, Tancredi C, Fantesini A, Fazzini D, Fortunati A, Perazzo C, Presta R, Montanari R, Forzenigo L, Carrafiello G, Papa S, Alì M.

    Eur J Radiol. 2024 Jun 27;177:111590. doi: 10.1016/j.ejrad.2024.111590. Epub ahead of print. PMID: 38959557.


  • Etude : l’évaluation de la rentabilité de l’IA dans la santé manque de rigueur (BMC)

    L’IA en santé, un investissement rentable ?

    Le moins que l’on puisse dire, c’est que le potentiel de l’intelligence artificielle pour transformer les soins de santé fait l’objet de nombreuses recherches. L’efficacité clinique n’est certes pas toujours au rendez-vous et d’ailleurs, à ce jour, seuls 600 outils d’IA ont été approuvés par la Food and drug administration (FDA). Le passage à la pratique clinique se fait donc lentement. C’est certes la faut à un manque de guidelines précis, comme l’a démontré une étude publiée le 29 mai dans Plos Digital Health mais pas que… Afin de s’assurer que les ressources sont utilisées de manière optimale, il est nécessaire de mesurer la rentabilité des outils d’IA. D’autant que tous les systèmes de santé sont soumis à une pression économique énorme, et l’heure est aux restrictions budgétaires.

    La qualité des études économiques en question :

    C’est pourquoi des chercheurs danois de l’université d’Aalborg ont voulu analyser la qualité des évaluations économiques en santé (EES) concernant l’IA, sachant que des évaluations de mauvaise qualité peuvent fournir des résultats trompeurs et conduire à de mauvais investissements. Ils ont donc mené une revue systématique pour évaluer la qualité méthodologique (conception des études, collecte des données et interprétation des résultats) et la transparence des évaluations économiques des technologies d’IA en santé, en identifiant les forces et les faiblesses des méthodologies actuelles et en suggérant des améliorations nécessaires. Ils ont épluché des études publiées au cours des cinq dernières années, entre le 1er janvier 2017 et le 6 mars 2022, et mises à jour jusqu’au 1er septembre 2023, dont ils en ont extraits 29.

    Les résultats de cette revue systématique ont été publiés le 1er juillet dans BMC Digital Health.

    Résultats : des défauts majeurs de conception et de transparence

    • Les aspects de conception des études étaient généralement bien traités alors que les éléments relatifs à la collecte de données et à l’interprétation des résultats présentaient des lacunes significatives.
    • Les études économiques manquaient de transparence dans le rapport des coûts et des analyses statistiques. Par exemple, de nombreuses études n’ont pas précisé les coûts unitaires ou encore les intervalles de confiance.
    • Aucune des études examinées n’a spécifiquement traité des éléments propres aux technologies médicales (MedTech).
    • Il y a un nombre relativement faible d’évaluations économiques complètes par rapport au nombre total de publications sur l’IA, malgré une tendance à la hausse.
    • Le ratio coût-efficacité, une mesure essentielle pour comparer les coûts et les effets de différentes interventions, n’était que peu évalué. Ce qui rendait difficile l’évaluation de la rentabilité des technologies d’IA.
    • Les mesures de substitution n’étaient pas optimales. Ce qui a pu conduire à surestimer les bénéfices des technologies d’IA.
    • Aucune étude n’a examiné comment l’efficacité des technologies d’IA peut changer avec le temps et l’expérience.

    Un besoin de guidelines :

    En conclusion, les chercheurs jugent « inquiétant » le faible nombre d’études économiques sur l’IA en santé. Et estiment « crucial » d’améliorer la qualité et la transparence de ces études pour garantir une utilisation efficace des ressources de santé. Dans ce but, ils préconisent d’établir des lignes directrices dédiées aux évaluations économiques des interventions d’IA dans le domaine de la santé.


    * Landscape and challenges in economic evaluations of artificial intelligence in healthcare: a systematic review of methodology.

    Kastrup, N., Holst-Kristensen, A.W. & Valentin, J.B.

    BMC Digit Health 2, 39 (2024). https://doi.org/10.1186/s44247-024-00088-7

  • Étude : un dépistage du cancer du sein plus précoce avec l’introduction de l’IA (Radiology)

    L’IA au service de l’imagerie de demain… et d’aujourd’hui

    « Nous, médecins radiologues, sommes convaincus de l’importance de l’intelligence artificielle (IA) pour l’imagerie de demain… » Telle est la certitude d’un collectif de radiologues qui a signé une tribune dans Le Monde en avril dernier. Selon ces derniers, « l’introduction de l’IA dans le système français de dépistage pourrait augmenter le nombre de cancers détectés sans augmenter le nombre de faux positifs, sous réserve que l’IA soit combinée à un lecteur expert de niveau L2 au minimum. »

    C’est globalement le scénario testé par des chercheurs danois. Ils ont comparé deux groupes de 119 000 femmes âgées de 50 à 69 ans qui ont subi une mammographie de dépistage dans la région de la capitale du Danemark. Le premier groupe a été dépisté entre octobre 2020 et novembre 2021 sans l’utilisation de l’IA. Le deuxième groupe a été dépisté entre novembre 2021 et octobre 2022 grâce à la combinaison de radiologues et de l’IA.

    Le Danemark a déjà fait le choix de l’IA pour le dépistage du cancer du sein

    Au Danemark, toutes les femmes âgées de 50 à 69 ans se voient offrir un dépistage du cancer du sein tous les deux ans. Et celles qui ont déjà subi une chirurgie du cancer du sein se voient offrir des mammographies jusqu’à l’âge de 79 ans. En tout, des dizaines de milliers de radiographies sont donc désormais examinées chaque année par l’intelligence artificielle. Ce dispositif représente évidemment une grande charge de travail pour les radiologues. Le but de l’étude était donc d’évaluer la pertinence du déploiement de l’IA dans la région de Copenhague sur près de trois ans.

    Les résultats de cette étude ont été publiés le 4 juin dans le journal Radiology.

    Résultats : des tumeurs plus petites détectées grâce à l’IA

    • Avant l’introduction de l’IA, les radiologues détectaient en moyenne 70 cas de cancer du sein pour 10 000 dépistages.
    • Depuis sa mise en œuvre, l’IA a permis aux radiologues de trouver 82 femmes atteintes de cancer du sein sur 10 000, soit une augmentation de 12 cas pour 10 000 dépistages.
    • L’IA a permis un dépistage plus précoce puisque la proportion de petites tumeurs détectées avec l’aide de l’IA était de 44,93 % contre 36,60 % avant l’introduction de l’IA.
    • Les dépistages assistés par l’IA ont réduit les faux positifs (1,63 % contre 2,39 %).
    • La charge de travail des radiologues a été réduite de 33,4 % grâce à l’intelligence artificielle. La double lecture n’est plus automatique puisque le système de dépistage par IA sélectionne environ 70 % des mammographies à faible risque, qui sont ensuite lues par un seul radiologue spécialiste du sein.

    À la question « L’intelligence artificielle peut-elle être utilisée pour aider à détecter le cancer du sein ? La réponse est un « oui » sans équivoque, estiment les auteurs d’une nouvelle étude de l’Université de Copenhague et du programme de dépistage du cancer du sein de la région de la capitale du Danemark. « Le nombre de tumeurs trouvées et leur taille sont des facteurs cruciaux qui ont vraiment un impact sur les chances de guérison de ces femmes », a expliqué le Dr Ilse Vejborg, médecin-chef et responsable du programme de dépistage mammographique de la région de la capitale au Danemark.

    Enfin, les chercheurs danois insistent sur le fait que le résultat final est toujours décidé par des radiologues spécialistes du sein. Et quand il y a désaccord, les deux radiologues spécialistes du sein se réunissent pour une discussion de consensus ou font appel à un troisième radiologue spécialiste du sein expérimenté pour aider à prendre une décision finale. L’IA n’a jamais le dernier mot !


    *Early Indicators of the Impact of Using AI in Mammography Screening for Breast Cancer

    Andreas D. Lauritzen, Martin Lillholm, Elsebeth Lynge, Mads Nielsen, Nico Karssemeijer, Ilse Vejborg, and Linda Moy

    Radiology 2024 311:3